
cemig-ceia/ons_aneel_markdown
收藏官方服务:
资源简介:
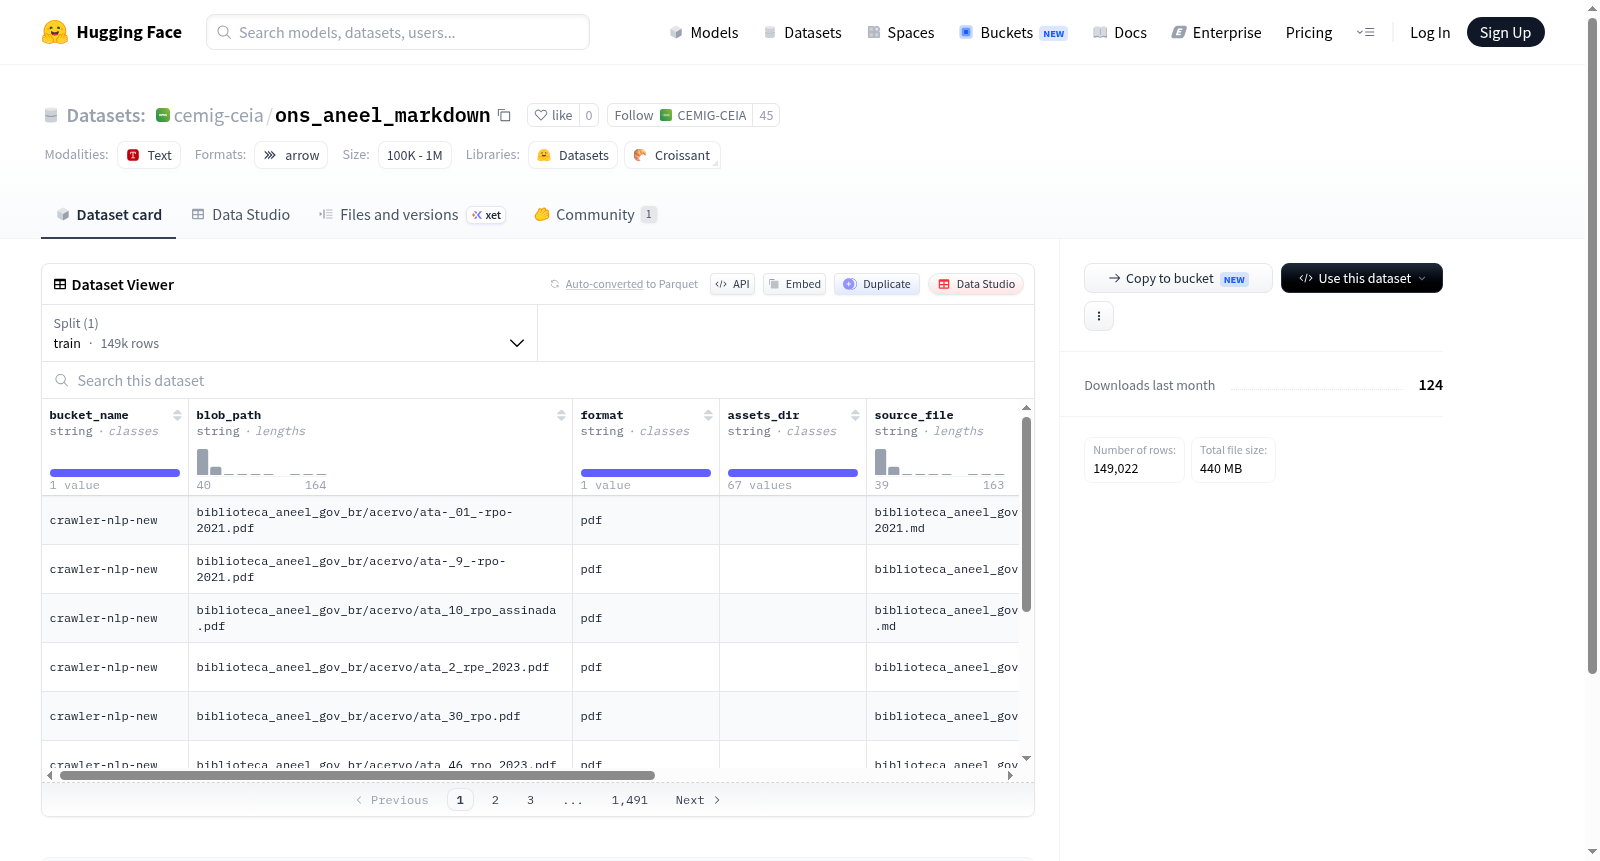
--- dataset_info: features: - name: bucket_name dtype: string - name: blob_path dtype: string - name: format dtype: string - name: assets_dir dtype: string - name: source_file dtype: string - name: image_paths sequence: string - name: text dtype: string splits: - name: train num_bytes: 1333034411 num_examples: 149022 download_size: 439787553 dataset_size: 1333034411 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
cemig-ceia搜集汇总
数据集介绍
构建方式
该数据集名为ons_aneel_markdown,源自巴西国家电力系统运营商(ONS)的公开数据,经由精细化处理而成。构建过程中,原始数据被转换为结构化的Markdown格式,保留了关键信息。每条样本包含桶名称、存储路径、格式类型、资产目录、源文件、关联图像路径以及文本内容。数据以单一训练集形式存在,包含149,022个样本,总大小约1.33 GB,便于高效加载与使用。
特点
该数据集的核心特点在于其高度结构化的组织方式。通过将电力系统技术文档与图像路径关联,实现了多模态信息的整合。文本字段采用Markdown格式,保留了原始文档的层级与排版,便于解析与理解。此外,每条记录均包含详细的元数据(如源路径与格式),极大地提升了数据的可追溯性和可复用性,为电力领域的数据分析与自然语言处理研究提供了坚实基础。
使用方法
在使用该数据集时,用户可通过Hugging Face Datasets库直接加载默认配置。由于数据以Parquet格式分片存储,推荐采用流式加载方式处理大规模文件,以降低内存占用。加载后,可结合文本与图像路径字段,进行多模态任务训练,例如文档理解或报告生成。此外,数据集支持直接转换为Pandas DataFrame,便于后续分析与预处理工作,适用于针对巴西电力系统数据的文本挖掘或知识图谱构建。
背景与挑战
背景概述
在数字化浪潮推动下,非结构化数据的激增对信息处理与知识提取提出了严峻挑战,Markdown格式作为轻量级标记语言,在技术文档、笔记和在线内容中广泛应用,但其自动解析与结构化转换仍面临诸多难题。ons_aneel_markdown数据集由相关研究机构于近期创建,专注于对Markdown文档进行系统化收集与标注,旨在为自然语言处理、信息检索及文档分析等领域提供标准化的训练与评估资源。该数据集包含约14.9万个训练样本,涵盖文本、图像路径等多模态特征,其发布为提升Markdown内容的理解与生成能力奠定了基础,对推动文档智能处理技术的发展具有显著影响力。
当前挑战
该数据集面临的核心挑战在于领域问题的复杂性:Markdown文档的语法多样性与人类写作的自由性导致解析过程易产生歧义,现有模型在准确捕捉层级结构、代码块、嵌入图像等元素时表现欠佳,亟需高质量的标注数据来训练鲁棒的解析算法。此外,构建过程中需克服数据收集的广度与深度矛盾,确保覆盖不同场景下的Markdown变体;处理大规模多模态数据时,需平衡文本与图像的一致性标注,并解决存储与传输效率问题,这进一步加剧了数据清洗与质量控制的难度。
常用场景
经典使用场景
在现代信息检索与文档理解的交叉领域中,结构化与非结构化数据的融合处理始终是研究焦点。ons_aneel_markdown数据集以其精巧的设计,为多模态文档解析与内容提取任务提供了标准化的训练与评估平台。该数据集涵盖了来自云存储(如Azure Blob)中的海量文档,每条样本包含存储路径、源文件格式、关联图像路径及转换后的Markdown文本,因而在文档图像理解、版面分析、图文内容对齐以及Markdown格式文本生成等经典场景中扮演着关键角色。研究者利用该数据集训练模型,能够从复杂布局的文档(如技术报告、科研论文、企业报表)中精准提取并结构化表达信息,从而推动文档智能处理技术迈向更高效、更鲁棒的境界。
解决学术问题
长期以来,学术界在实现从原始文档到结构化文本的自动化转换时,面临着标注成本高昂与跨模态语义割裂的双重困境。ons_aneel_markdown数据集的出现,系统性地回应了这两大挑战。它缓解了多模态文档理解领域大规模高质量标注数据稀缺的瓶颈,为训练跨模态对齐模型提供了丰富的图文配对资源。通过这一基准,研究者能够深入探索视觉布局特征与文本语义之间的映射规律,攻克文档版面顺序重建、复杂表格内容提取以及多栏文本连续阅读顺序判定等典型学术难题。该数据集的发布,促进了文档智能领域从规则驱动向数据驱动范式的转型,为后续研究奠定了坚实的实证基础,并推动了评测标准的统一。
衍生相关工作
ons_aneel_markdown数据集的问世,催生了一系列富有启发性的后续研究。在模型架构层面,研究人员基于该数据集开发了专门针对长文档布局理解的端到端Transformer模型,实现了文档图像到Markdown文本的无损映射。在评测体系上,围绕该数据集衍生出面向文档结构化程度、跨模态对齐准确率及表格/代码块还原精度的专项评测指标,丰富了文档智能领域的度量工具。此外,利用此数据集进行预训练的语言模型,在未见过的文档类型上展现了强大的零样本迁移能力,相关成果被多次引用并应用于多语言文档处理系统的开发,显著拓宽了该数据集在学术与工业界的影响力边界。
以上内容由遇见数据集搜集并总结生成


