
awesome-DGA
收藏数据链接:
官方服务:
资源简介:
该合集是一个关于域名生成算法(DGA)的资源集合,收录了DGA相关的研究论文、数据集和代码。它旨在为研究DGA提供有用的资料,覆盖网络安全和恶意软件检测领域,以组织化的方式整理这些资源。
This collection is a curated resource repository focused on Domain Generation Algorithms (DGA), which gathers research papers, datasets, and code related to DGAs. It is designed to provide valuable resources for DGA-related research, spanning the fields of cybersecurity and malware detection, and organizes these materials in a structured manner.
创建时间:
2020-04-03
原始信息汇总
Domain Generation Algorithms (DGA) 相关资源汇总
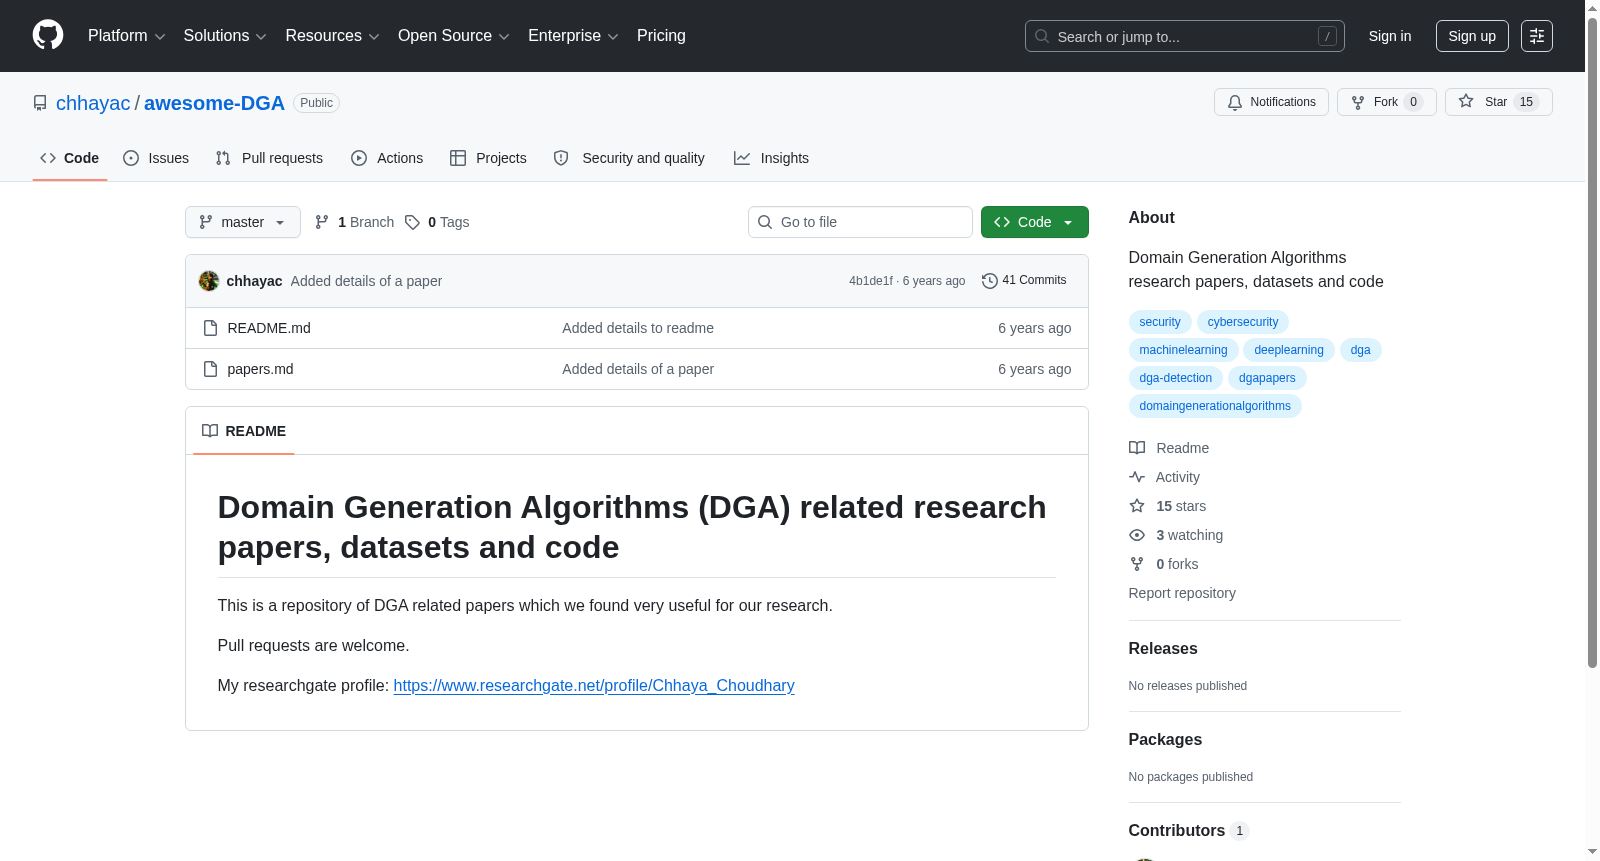
这是一个专注于域名生成算法(DGA)相关的研究论文、数据集和代码的仓库。
主要内容
- 研究论文:汇集了与DGA相关的学术论文,可用于该领域的研究参考。
- 数据集:提供了与DGA相关的数据集资源。
- 代码:收录了与DGA相关的代码实现。
贡献说明
该仓库欢迎社区通过Pull Request贡献更多资源。
相关链接
- 仓库维护者的ResearchGate主页:https://www.researchgate.net/profile/Chhaya_Choudhary
搜集汇总
数据集介绍
构建方式
在网络安全领域中,域名生成算法(DGA)作为恶意软件规避域名黑名单检测的常用技术,一直是学术研究的热点。该数据集通过系统梳理与DGA相关的研究论文、公开数据集及代码实现,构建了一个结构化的知识库。构建过程以学术文献为基石,广泛收录了来自顶级会议和期刊的DGA研究成果,同时整合了多个公开的DGA域名样本集和检测工具代码,确保了内容的全面性与代表性。数据集以GitHub仓库为载体,通过版本控制实现持续更新,并支持社区贡献,从而保持与前沿研究的同步。
特点
该数据集的核心特点在于其多维度的资源整合能力。它不仅收录了DGA领域的经典与最新研究论文,还提供了可直接用于实验的域名样本数据集,覆盖了多种已知DGA变种及生成策略。此外,数据集包含了多种检测方法的源代码实现,如基于机器学习和深度学习的分类模型,便于研究者复现实验与对比分析。其开放协作的维护模式使得资源能够快速响应领域内新出现的威胁与技术进步,形成了一个动态演化的知识生态系统。
使用方法
研究者可通过GitHub仓库直接访问该数据集,所有资源按分类目录组织。论文部分按发表年份和主题标签索引,支持快速检索;数据集以压缩文件或链接形式提供,可直接下载用于模型训练与评估;代码实现则附有详细使用说明,依赖环境清晰标注。用户可根据研究需求,直接引用论文进行理论分析,或利用提供的数据集和代码开展实验验证。仓库还鼓励提交改进建议或新增资源,通过Pull Request机制促进社区协同,从而拓展数据集的实用边界。
背景与挑战
背景概述
域名生成算法(Domain Generation Algorithm, DGA)是网络攻击中广泛采用的一种技术,恶意软件通过该算法动态生成大量随机域名,以规避基于静态黑名单的检测机制。自2010年以来,DGA技术逐渐成为高级持续性威胁(APT)和僵尸网络的核心组件,对网络安全防御提出了严峻挑战。awesome-DGA数据集由研究人员Chhaya Choudhary等人创建,旨在系统性地收集和整理与DGA相关的学术论文、公开数据集及代码资源,为学术界和工业界提供一个全面的知识库。该数据集聚焦于DGA的分类、检测与防御策略,其研究问题涵盖从传统机器学习方法到深度学习模型在DGA识别中的应用。自发布以来,awesome-DGA已成为该领域的重要参考资源,推动了DGA检测技术的演进与对比分析,对网络威胁情报研究具有显著影响力。
当前挑战
DGA领域面临的核心挑战在于恶意软件域名的动态生成机制使得传统基于静态特征匹配的检测方法难以奏效。具体而言,DGA的随机性导致域名空间极度庞大且不断变化,增加了特征提取与模型泛化的难度。此外,攻击者常采用多态性技术和对抗样本攻击,进一步削弱了检测模型的鲁棒性。在数据集构建过程中,研究人员面临标签噪声问题,即恶意与良性域名之间的边界模糊,且公开数据源可能包含过时或未覆盖最新DGA变体的样本。同时,跨数据集的一致性维护与隐私保护也构成实际障碍,限制了大规模协作研究的开展。
常用场景
经典使用场景
在网络安全领域,域名生成算法(DGA)是恶意软件用以规避静态黑名单检测的关键技术。awesome-DGA数据集汇聚了与DGA相关的学术论文、公开数据集及代码实现,为研究者提供了一个系统化的知识库。其经典使用场景集中于DGA检测模型的构建与评估,例如通过分析算法生成的随机域名与合法域名的统计特征,训练机器学习或深度学习分类器,从而实现高精度的恶意域名识别。该数据集还常用于复现经典检测方法(如基于LSTM或CNN的模型),并支持跨数据集的性能对比实验,推动检测技术的标准化与可复现性。
实际应用
在实际应用中,awesome-DGA数据集支撑了网络安全运营中的实时威胁检测系统。安全团队可基于该数据集训练的模型,部署于网络流量监控平台,自动识别僵尸网络、勒索软件等恶意程序生成的DGA域名,并阻断其与命令控制服务器的通信。例如,企业防火墙或云安全服务可集成相关模型,在DNS查询阶段进行预判,将误报率控制在可接受范围内。此外,该数据集还用于开发轻量化检测方案,适应物联网或边缘计算等资源受限场景,提升整体安全防护的自动化与智能化水平。
衍生相关工作
基于awesome-DGA数据集,衍生了一系列影响深远的经典工作。在检测方法层面,研究者提出了融合字符级与词级特征的混合模型(如CharCNN+BiLSTM),以及利用注意力机制捕捉域名中关键子串的改进架构。在对抗攻防方面,衍生出针对DGA检测器的逃逸攻击方法(如基于GAN生成逼真域名)及其防御策略(如对抗训练)。此外,该数据集还催生了跨领域迁移学习研究,例如将预训练语言模型(如BERT)适配至域名分析任务,显著提升了低资源场景下的检测性能。这些工作共同推动了DGA研究从单一检测向体系化对抗的演进。
以上内容由遇见数据集搜集并总结生成


