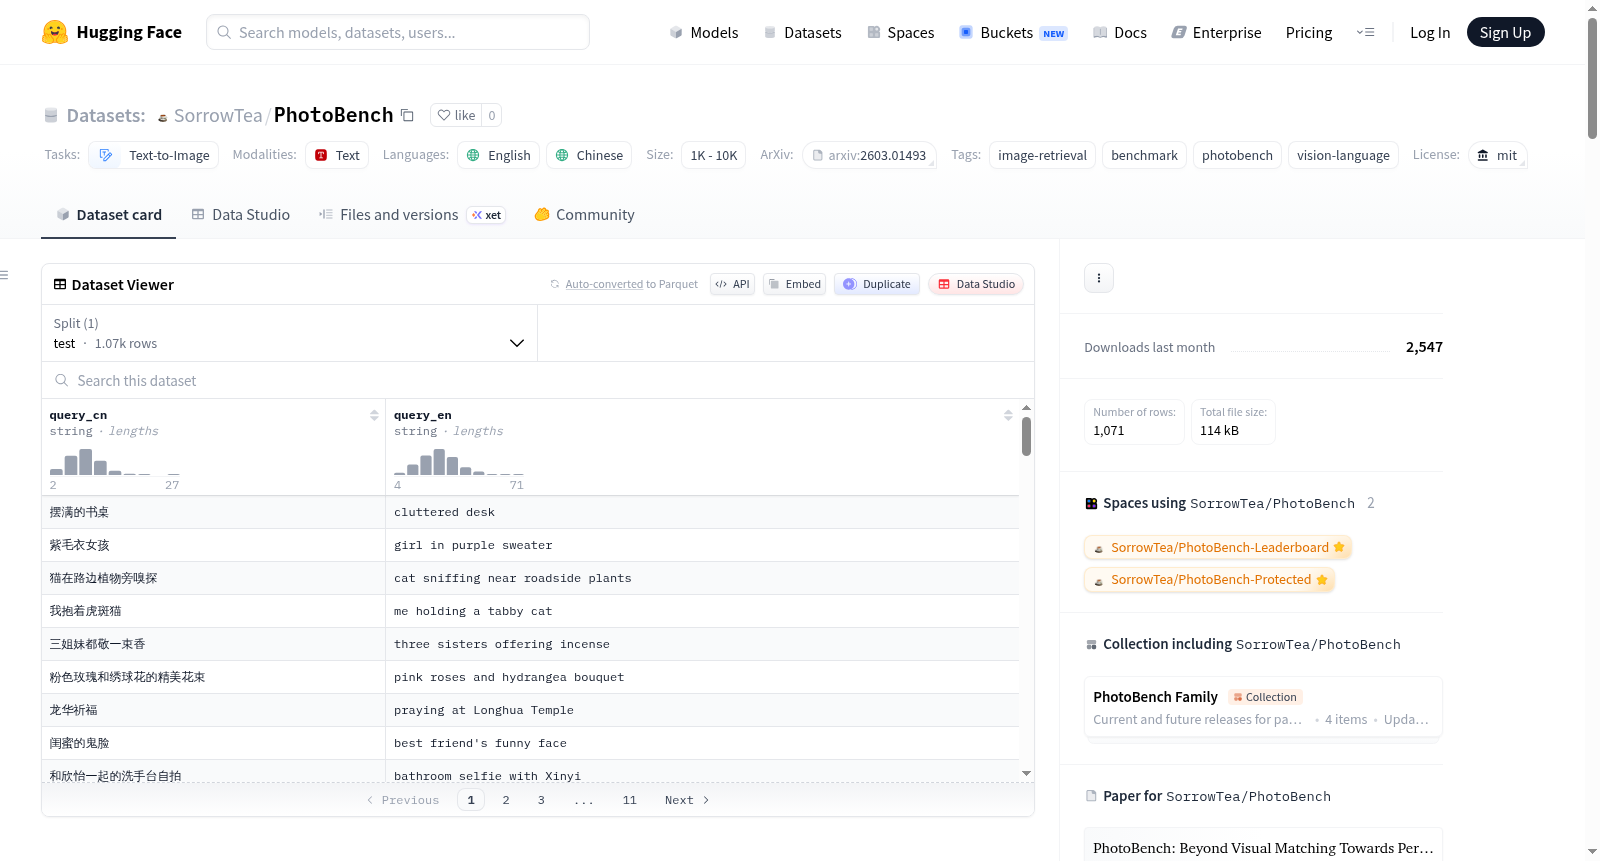
PhotoBench
收藏资源简介:
PhotoBench 是一个基于真实个人相册构建的图像检索基准数据集,旨在从视觉匹配转向个性化多源意图驱动的照片检索。该数据集包含开放式的自然语言查询,支持使用自定义的嵌入模型、标题生成器或基于代理的检索工作流。数据集主要包括:1) 三个相册的测试查询(中英文双语);2) 所有三个相册的原始图像(需单独获取)。具体数据规模为:相册1约1,070张图像和100个测试查询,相册2约1,470张图像和100个测试查询,相册3约1,050张图像和100个测试查询,每个查询平均有约4.5个真实匹配。测试查询以JSON格式提供,包含中英文查询文本字段。原始图像为JPEG格式,保持相机原始文件名。该数据集适用于文本到图像检索任务,支持使用各种视觉编码器和视觉语言模型进行评估和创新。数据集采用MIT许可证发布。
PhotoBench 数据集概述
基本信息
- 数据集名称:PhotoBench
- 任务类型:文本到图像检索(Text-to-Image Retrieval)
- 许可协议:MIT License
- 语言:中文、英文
- 数据集规模:小于 1,000 条记录
- 相关标签:image-retrieval, benchmark, photobench, vision-language
数据集简介
PhotoBench 是首个基于真实个人相册构建的基准测试,旨在将视觉匹配范式转向个性化、多源意图驱动的照片检索。该数据集提供对原始图像的完全访问权限,允许用户使用自定义的嵌入模型、标题生成器或基于代理的检索工作流。
数据集规模
数据集包含 3 个相册,每个相册的详细信息如下:
| 相册 | 图像数量 | 测试查询数 | 每个查询的平均真实标注数 |
|---|---|---|---|
| 1 | ~1,070 | 100 | ~4.5 |
| 2 | ~1,470 | 100 | ~4.5 |
| 3 | ~1,050 | 100 | ~4.5 |
数据格式
测试查询文件
每个查询文件以 JSON 数组格式存储,包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
| query_cn | string | 中文查询文本 |
| query_en | string | 英文查询文本(主要语言) |
示例: json [ { "query_cn": "摆满的书桌", "query_en": "cluttered desk" }, { "query_cn": "紫毛衣女孩", "query_en": "girl in purple sweater" } ]
原始图像
- 总大小:约 11 GB
- 格式:JPEG
- 命名方式:原始相机文件名(如
IMG_1234.JPG) - 存放位置:由于大小限制,原始图像不直接托管在该仓库中,需联系作者获取或按照说明下载
评估指标
排行榜计算的指标如下:
| 指标 | 描述 | 支持的 k 值 |
|---|---|---|
| Recall@k | 前 k 个结果中真实图像的比例 | 1, 5, 10, 20, 50, 100 |
| NDCG@k | 前 k 个位置的归一化折损累积增益 | 1, 5, 10, 20, 50, 100 |
最终得分按相册平均,然后跨相册取平均值。只有提交全部 3 个相册、全部查询的结果才能参与公开排行榜排名。
使用方式
-
下载测试查询:通过
huggingface_hubCLI 或直接从仓库的 Files 标签页下载albumN_test.json文件。 -
下载原始图像:联系作者获取访问权限,或按照相册结构准备图像:
raw_albums/ ├── album1/ ├── album2/ └── album3/
-
构建检索系统:使用原始图像和测试查询,可进行图像嵌入提取、标题生成、多步代理工作流设计等。
-
提交至排行榜:准备预测结果并上传至 PhotoBench 排行榜。
相关链接
引用
bibtex @misc{photobench2026, title={PhotoBench}, year={2026}, eprint={2603.01493}, archivePrefix={arXiv}, primaryClass={cs.CV} }