real-v-tsfm
收藏资源简介:
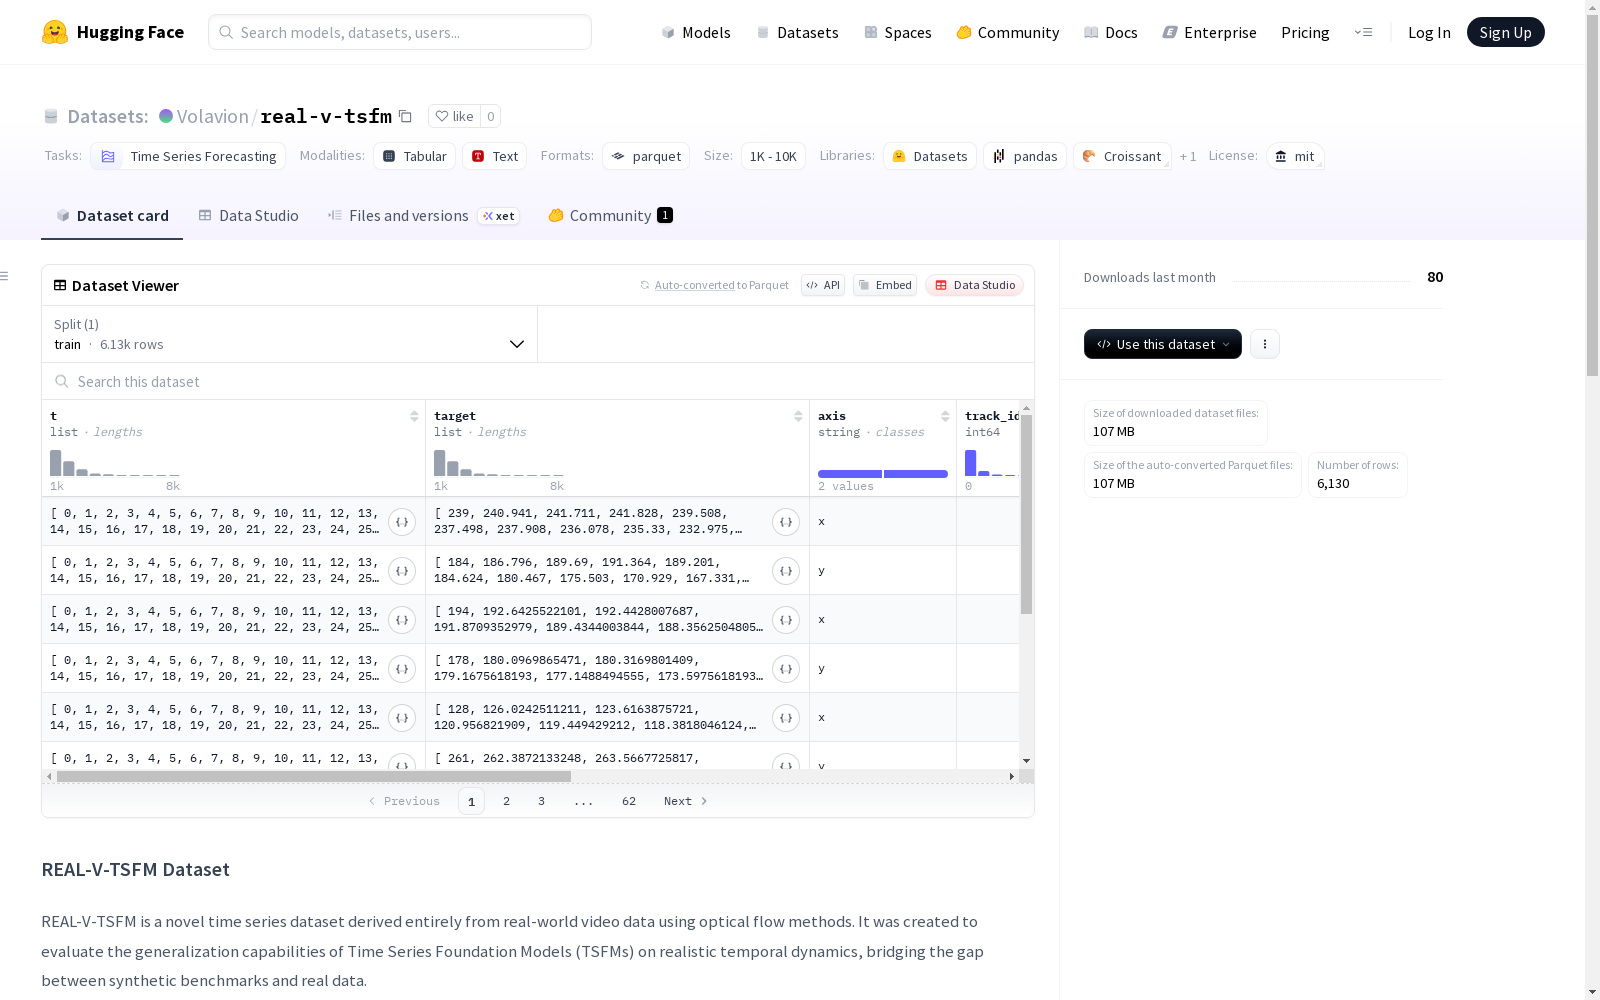
REAL-V-TSFM数据集是一个全新的时序数据集,完全从真实世界视频数据中使用光流方法衍生而来。它旨在评估时序基础模型在真实时序动态上的泛化能力,弥合了合成基准和真实数据之间的差距。数据集包含6130个时序,源自609个不同物体的轨迹,提供了大量的类别多样性。每个时序的平均长度为2043个时间步,长度在1000到8000个时间步之间变化。数据集大约有44%的序列是静止的,平均信息熵为3.88比特,表明了其复杂性和多样性。
The REAL-V-TSFM dataset is a novel temporal dataset entirely derived from real-world video data using optical flow methods. It aims to evaluate the generalization capability of temporal foundation models on real temporal dynamics, bridging the gap between synthetic benchmarks and real-world data. The dataset contains 6130 temporal sequences derived from the trajectories of 609 distinct objects, offering substantial category diversity. The average length of each temporal sequence is 2043 time steps, with lengths ranging from 1000 to 8000 time steps. Approximately 44% of the sequences in the dataset are stationary, with an average information entropy of 3.88 bits, indicating its complexity and diversity.
REAL-V-TSFM 数据集概述
数据集基本信息
- 名称:REAL-V-TSFM
- 来源:基于真实世界视频数据,主要源自LaSOT数据集
- 数据量:6,130个时间序列样本
- 数据大小:下载大小106.7MB,数据集大小200.8MB
- 许可证:MIT许可证
- 任务类别:时间序列预测
- 规模类别:1K<n<10K
数据特征
- 特征列:
- t:时间索引(int64列表)
- target:时间序列对应值(float64列表)
- axis:空间轴标识(x或y)
- track_id:光流跟踪标识符
- timestamp:时间戳字段
- prefix:源视频标识
- time_length:时间长度
- target_length:目标长度
- unique_id:唯一标识符
数据生成方法
使用Lucas-Kanade光流算法跟踪视频中检测到的关键点的像素轨迹,每个轨迹的x和y坐标形成独立的单变量时间序列。
数据处理流程
- 选择视频并提取逐帧图像
- 使用高斯混合模型2(MOG2)进行前景检测以屏蔽背景像素
- 使用Shi-Tomasi角点检测算法检测前景对象中的角点
- 使用金字塔Lucas-Kanade光流跨帧跟踪关键点,并应用前后一致性检查过滤不稳定轨迹
- 将轨迹插值到每个视频的最长序列长度,保留五个最不相关的轨迹以确保多样性并减少噪声
- 将每个轨迹的x和y坐标作为单独的时间序列存储在数据集中
数据集特点
- 来自609个不同对象的6,130个时间序列,提供显著的类别多样性
- 平均长度为2,043个时间步长,长度范围从1,000到8,000个时间步长
- 约44%的序列通过增强迪基-富勒检验显示为平稳序列
- 平均信息熵为3.88比特,表明复杂性和多样性
评估基准
- 在零样本预测设置下评估最先进的时间序列基础模型
- 使用指标:平均绝对百分比误差(MAPE)、对称MAPE(sMAPE)、聚合相对加权分位数损失(WQL)和聚合相对平均绝对尺度误差(MASE)
- 与M4数据集相比,在REAL-V-TSFM上表现出性能下降,表明当前模型对真实世界视频衍生时间序列的泛化能力有限