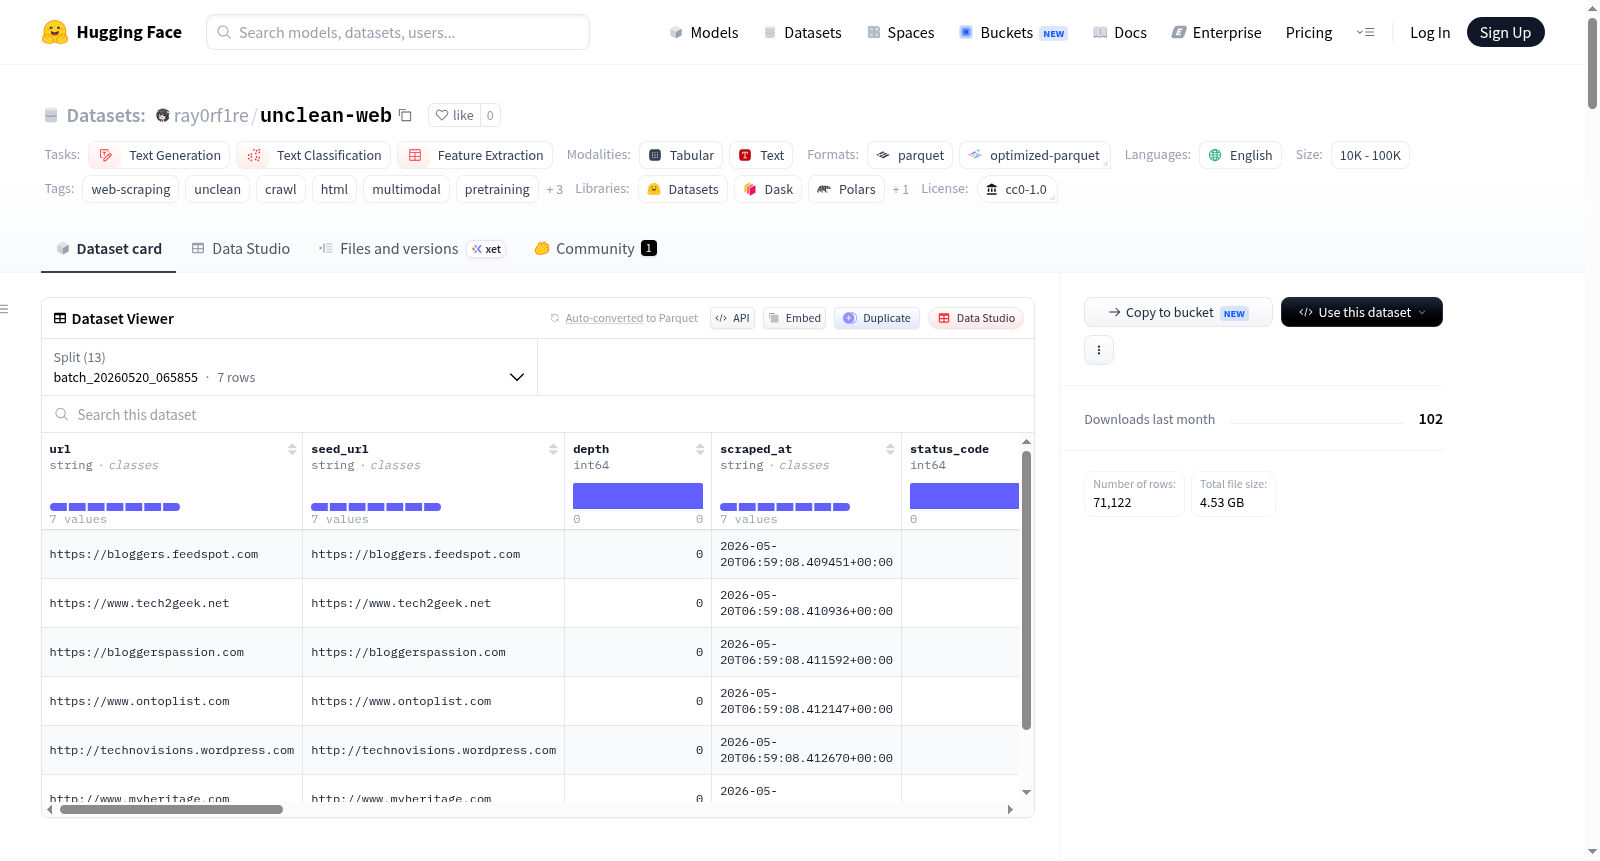
unclean-web
收藏资源简介:
Unclean Web是一个原始、未过滤的网络爬取数据集,专门为语言模型的预训练、微调和研究而设计。该数据集通过广度优先搜索(BFS)递归爬取自18个不同的网站来源,共包含4,210个网页,估计总token数约为559万。它提供了多种格式的子集,包括完整的原始抓取数据、不同规模的token抽样子集(如10K、1M、5M token)、用于指令微调的OpenHermes格式子集、用于预训练的Dolma/RedPajama格式子集,以及用于分词器训练的原始文本分片子集。每个数据样本包含25个详细的字段,涵盖URL信息(如原始URL、种子URL、爬取深度、时间戳)、页面元数据(如标题、描述、关键词、作者、语言、规范链接)、结构化语义信息(如Open Graph标签、Twitter卡片标签、Schema.org数据)、文本内容(清理后的正文文本和所有可见文本)、HTML源代码(上限12MB)、链接信息(内部和外部链接)、图像数据(以base64编码存储)、代码块以及可能的错误信息。该数据集适用于多种自然语言处理任务,包括文本生成、文本分类、特征提取、多模态学习、模型预训练、指令微调和分词器训练。需要注意的是,数据集内容为原始未过滤的网络数据,可能包含冒犯性、成人或敏感材料。
Unclean Web is a raw, unfiltered web-scraped dataset specifically designed for language model pretraining, fine-tuning, and research. The dataset was recursively crawled from 18 different website sources using breadth-first search (BFS), containing a total of 4,210 web pages with an estimated total token count of approximately 5.59 million. It provides various format subsets, including complete raw crawl data, token-sampled subsets of different scales (e.g., 10K, 1M, 5M tokens), an OpenHermes-format subset for instruction fine-tuning, a Dolma/RedPajama-format subset for pretraining, and a raw text chunk subset for tokenizer training. Each data sample includes 25 detailed fields covering URL information (such as original URL, seed URL, crawl depth, timestamp), page metadata (such as title, description, keywords, author, language, canonical link), structured semantic information (such as Open Graph tags, Twitter card tags, Schema.org data), text content (cleaned body text and all visible text), HTML source code (capped at 12MB), link information (internal and external links), image data (stored in base64 encoding), code blocks, and possible error messages. The dataset is suitable for various natural language processing tasks, including text generation, text classification, feature extraction, multimodal learning, model pretraining, instruction fine-tuning, and tokenizer training. It should be noted that the dataset contains raw, unfiltered web data and may include offensive, adult, or sensitive material.
数据集概览
Unclean Web 是一个未经处理的原始网络抓取数据集,专为语言模型的预训练、微调及研究而设计。该数据集采用 CC0 1.0 许可证,主要语言为英语,适用于文本生成、文本分类和特征提取等任务。
数据规模与统计
| 指标 | 数量 |
|---|---|
| 总页面数 | 18,865 |
| 预估总Token数 | 24.35M |
| 唯一来源网站数 | 27 |
| 架构版本 | 3.0 |
| 最后更新 | 2026-05-21 04:40 UTC |
数据集划分与子集
该数据集提供了多种划分和子集,方便不同用途:
| 划分/子集 | 描述 | 格式 |
|---|---|---|
full (按批次) |
完整的原始抓取数据,包含所有列 | Parquet / JSONL |
subset_10k_tokens |
约10K Token的随机样本,用于快速测试 | Parquet / JSONL |
subset_1m_tokens |
约1M Token的精选样本 | Parquet / JSONL |
subset_5m_tokens |
约5M Token的精选样本 | Parquet / JSONL |
subset_half |
成功抓取页面的随机50% | Parquet / JSONL |
subset_openhermes |
OpenHermes 2.5/3 指令微调格式 | Parquet / JSONL |
subset_dolma |
Dolma / RedPajama / Fineweb 预训练格式 | Parquet / JSONL |
subset_tokenizer |
用于分词器训练的原始2048字符文本分片 | Parquet / JSONL |
merged (通过 merge_batches.py) |
所有批次划分合并为一个 | Parquet / JSONL |
数据列架构
| 列名 | 类型 | 描述 |
|---|---|---|
url |
string |
抓取页面的绝对URL |
seed_url |
string |
本次抓取的起始根URL |
depth |
int64 |
BFS爬取深度(0表示种子页面本身) |
scraped_at |
string |
ISO-8601 UTC时间戳 |
status_code |
int64 |
HTTP响应状态码 |
title |
string |
<title> 标签文本 |
description |
string |
<meta name=description> 内容 |
keywords |
string |
<meta name=keywords> 内容 |
author |
string |
<meta name=author> 内容 |
lang |
string |
<html lang> 属性值 |
canonical |
string |
来自 <link rel=canonical> 的规范URL |
og_tags |
string |
Open Graph <meta property=og:*> 标签的JSON字典 |
twitter_tags |
string |
Twitter卡片 <meta name=twitter:*> 标签的JSON字典 |
schema_org |
string |
<script type=application/ld+json> 对象的JSON列表 |
text |
string |
干净的正文文本(已移除脚本和样式) |
text_all |
string |
包括导航、页脚等的所有可见文本 |
word_count |
int64 |
text 列的词数 |
token_estimate |
int64 |
近似Token数(词数 × 1.35) |
content_hash |
string |
text 列的SHA-256前缀,用于去重 |
structured |
string |
包含标题、段落、表格、列表、块引用的JSON |
html |
string |
原始HTML源代码(上限12 MB) |
links |
string |
内部 <a href> URL的JSON列表 |
external_links |
string |
外部 <a href> URL的JSON列表 |
images |
string |
图像对象(url, alt, base64数据等)的JSON列表 |
code_blocks |
string |
<code>/<pre>/<script>/<style> 块的JSON列表 |
error |
string? |
成功时为 null,失败时为错误字符串 |
数据来源
该数据集涵盖了27个不同的来源网站,包括但不限于:en.wikipedia.org、github.com、medium.com、archiveofourown.org、www.fandom.com、www.fanfiction.net、www.reddit.com、www.webtoons.com 等。
数据管道
该数据集由 scrape_to_hf.py Python管道生成,具备以下特性:
- 智能URL解析
- BFS递归爬取,可配置深度(1-25),仅限同源
- 每层级临时缓存,支持大规模爬取
- Token预算控制(
-M参数),达到目标时停止 - 自动站点发现(
-A参数),通过DuckDuckGo、Bing、Common Crawl发现网站 - 重试与退避,3次重试,指数退避,尊重robots.txt
- 多线程并行工作,实现更快的BFS爬取
- 自动生成7个标准子集
- 自更新README,每次上传都会重新生成
注意事项与免责声明
- 内容为原始未经筛选状态,可能包含攻击性、成人或敏感材料。
- 图像数据以 base64 格式存储在
imagesJSON列中(仅当未设置--no-images时)。 - 默认尊重 robots.txt,可通过
--ignore-robots覆盖。 - 每次上传运行会创建一个新的命名划分,数据会累积而非覆盖。