tereus-imputation
收藏资源简介:
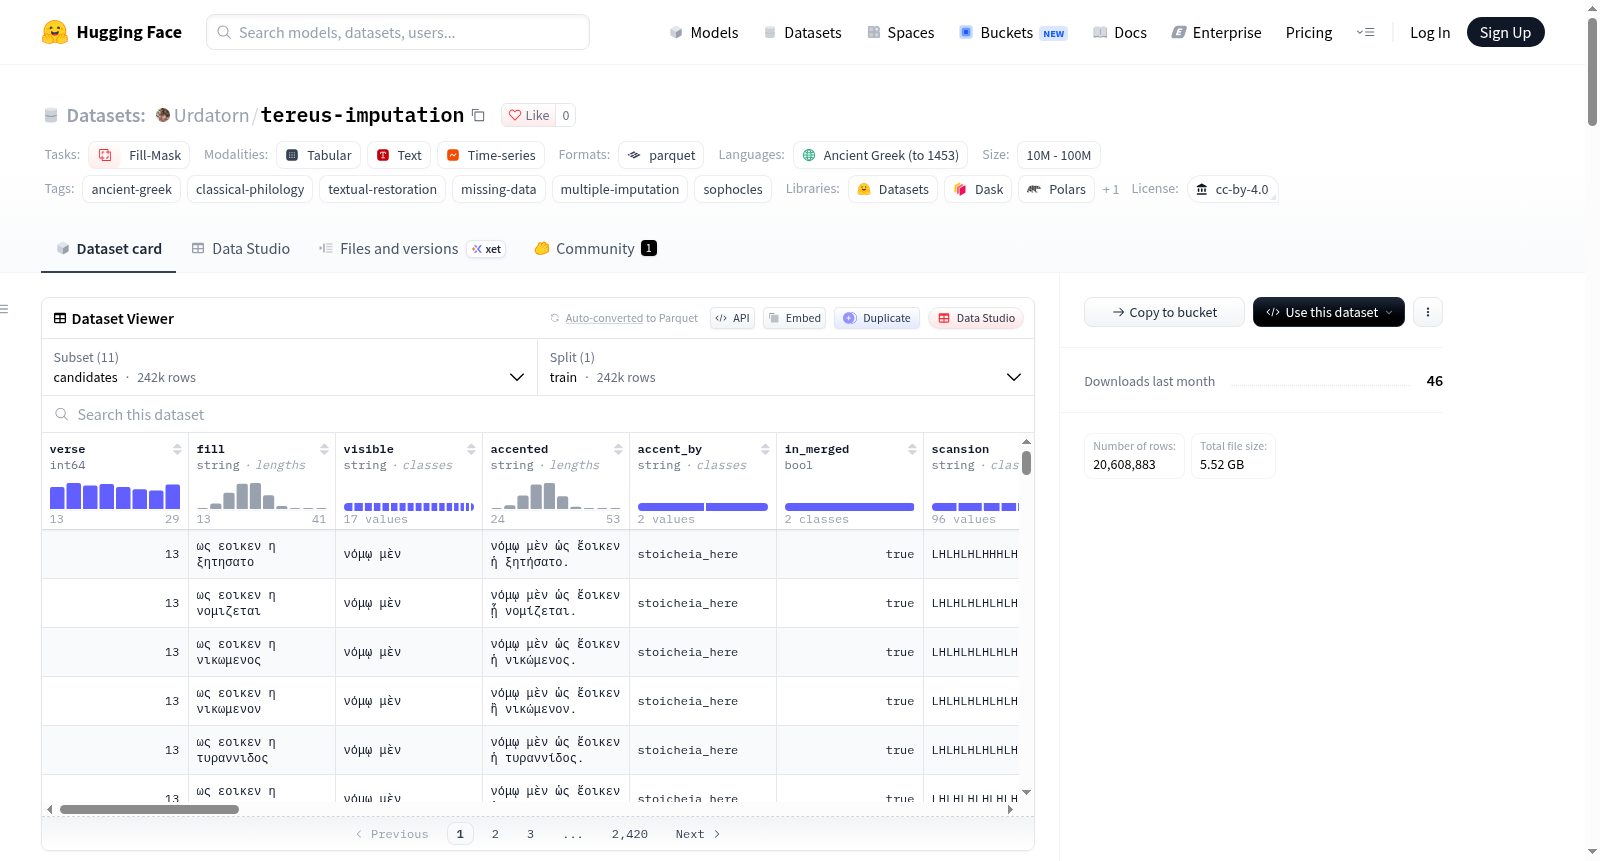
Tereus imputations数据集旨在通过机器补全方法,为索福克勒斯失传悲剧《Tereus》的纸莎草残片P.Oxy. 3013(第13至29行)中的缺损部分提供多重插补候选。该数据集包含多个配置:stoicheia配置提供210,000个完整的补全结果(每个补全填充全部17处缺损),使用字符级掩码扩散编码器Stoicheia生成,并按抑扬格三音步格测试筛选;candidates配置包含241,916个逐行候选填充(一次填充一行),来自独立的管道(结合恢复器、搜索链、LLM提议器和词典约束枚举),已按韵律过滤并排序;style_vectors配置提供3,224,119个诗句的768维KainoBERT嵌入向量(平均池化末层隐藏状态),用于风格分析;ll_verses和ll_imputations配置提供贝叶斯分析所需的每行似然值和索引映射;corpus配置包含27,523个参考三音步格诗句(埃斯库罗斯、索福克勒斯、欧里庇得斯的戏剧对白三音步格,经人工审核);classifier_stoicheia和classifier_candidates配置提供基于微调KainoBERT的分类器输出(三个种子,每个不同诗句的后验概率)。数据集的关键特征包括:所有补全被视为多重插补(而非拟议读法),强调覆盖率和不同补全之间的差异;使用多种评分(如恢复器对数概率、6-gram文体测量、LLM评判等);提供韵律特征(扫描、停顿、波尔森定律违反等)和文体似然值。注意事项包括:覆盖远非完整(Good-Turing估计每行未见过概率质量约75%),插补在Rubin意义上不恰当(来自固定检查点且温度低于1),韵律可接受不等于正确,两个配置(stoicheia和candidates)不可通约。数据集可用于古典语文学中的文本修复、三重奏戏剧风格分析、缺失数据多重插补等任务。
The Tereus imputations dataset aims to provide multiple imputation candidates for the damaged portions of the papyrus fragment P.Oxy. 3013 (lines 13-29) of Sophocles lost tragedy Tereus using machine completion methods. The dataset includes multiple configurations: stoicheia provides 210,000 complete imputations (filling all 17 lacunae), generated by the character-level masked diffusion encoder Stoicheia and filtered by iambic trimeter testing; candidates contains 241,916 line-by-line candidate fillings (one lacuna at a time), from an independent pipeline (combining restorer, search chain, LLM proposer, and lexicon-constrained enumeration), filtered and sorted by meter; style_vectors provides 3,224,119 768-dimensional KainoBERT embeddings (mean-pooled last hidden states) for style analysis; ll_verses and ll_imputations provide per-line likelihoods and index mappings for Bayesian analysis; corpus contains 27,523 reference iambic trimeter verses (from Aeschylus, Sophocles, and Euripides drama dialogue, manually verified); classifier_stoicheia and classifier_candidates provide fine-tuned KainoBERT classifier outputs (three seeds, posterior probabilities for different verses). Key features: all imputations are treated as multiple imputations (not proposed readings), emphasizing coverage and diversity; multiple scores (restorer log-probability, 6-gram stylometry, LLM judgments, etc.); prosodic features (scansion, caesura, violation of Porsons law, etc.) and stylistic likelihoods. Caveats: coverage is far from complete (Good-Turing estimate of unseen probability mass ~75% per line), imputations are not Rubin proper (from fixed checkpoints with temperature <1), metrical acceptability does not imply correctness, and the two configurations (stoicheia and candidates) are incommensurable. The dataset can be used for text restoration in classical philology, stylistic analysis of tragic drama, and multiple imputation for missing data.
Tereus imputations 数据集总结
基本信息
- 数据集地址:https://huggingface.co/datasets/Urdatorn/tereus-imputation
- 许可证:CC-BY-4.0
- 语言:古希腊语(grc)
- 别名:Tereus imputations (P.Oxy. 3013, vv. 13-29)
- 数据规模:1M < n < 10M
- 任务类别:fill-mask
- 标签:ancient-greek、classical-philology、textual-restoration、missing-data、multiple-imputation、sophocles
数据集概述
本数据集为索福克勒斯已失传剧作《Tereus》的纸草 P.Oxy. 3013 中残缺部分的机器复原结果。纸草保存了第 13-29 行的左侧部分,这 17 行的其余部分均已失传。第 1-12 行因由 Stobaeus 传抄而完整保存,作为每次复原的固定语境,存储于 context.json 中而非逐行重复。
这些结果是填补值(imputations),而非提出的校勘读法。该集合的重点在于覆盖范围及补全结果之间的分布差异(依据 Rubin 多重插补理论):分析应基于多个结果进行并报告插补间方差,而非选择单一读法。此处内容均未经编者认可。
配置说明
stoicheia — 第 13-29 行的 210,000 个完整复原
每行代表一个完整的填补结果:在整段残存字母的语境下,同时填补全部 17 处空缺。由字符级掩码扩散编码器 Stoicheia 通过基于置信度的迭代解掩码生成;空缺宽度从索福克勒斯三音步长度先验中抽样,截断至编者对每个空缺的估计。每行诗句随后由 Stoicheia-meter 扫描并对照抑扬格三音步模板检验。
| run | 行数 | 温度 | 给出诗句末尾边界 | 随机种子 |
|---|---|---|---|---|
t10 |
10,000 | 1.0 | 否 | 0 |
t065_seed0 |
10,000 | 0.65 | 是 | 0 |
t065_seed1 |
90,000 | 0.65 | 是 | 1 |
t065_seed2 |
100,000 | 0.65 | 是 | 2 |
列包括:run、conjecture_id、temperature、seed、verse_boundaries;widths、fills、gap_logp、gap_mean_logp(各 17 个,仅复原部分);verses、scansion、bracketed、is_trimeter(各 17 个,完整第 13-29 行);logp_total、n_verses_trimeter、all_trimeter。
格律扫描每个音节一个符号,- 为重音,u 为轻音,X 为诗句末尾。三音步检验允许除最后一个外的所有长音发生 resolution,并自由处理 anceps;它接受 Hypotactic 语料库中埃斯库罗斯 1,139 种不同扫描中的 1,135 种。第 29 行以 ἧμιν 扫描,即索福克勒斯使用的短 iota 韵律,在扫描前施加。
candidates — 241,916 个候选填补,逐行生成
每行代表某一诗句的一个不同填补,来自独立的流水线,拥有自身复原器、四条搜索链、诗句调优的 LLM 提议器及词典约束枚举,已按格律过滤并按五个分数排序。列携带该流水线自身的判断:lp_uni(复原器每字母对数概率)、bits_trag/style_trag/style_soph/lex_trag/lex_gen(字符 6-gram 风格计量)、llm_*、rank*(含 LLM 评判结论)、translation 与 note,以及 scansion、metre、caesura、porson_ok、word_status、found_by 和 chains。
accented 为带变音符号的诗句。accent_by 记录由哪一遍提供变音符号:paper 表示源流水线加注的 117,250 个,stoicheia_here 表示本次发布用 Stoicheia-doc_clean 完成的 124,666 个,仅预测填补部分的变音符号并保留编者在可见前缀上的变音符号。两遍在所有字母上一致,但仅约四分之一的完整诗句一致;双向评分 20,000 行诗句会使分类器在 8.5% 的诗句上改变 argmax,中位后验变化为零,95 百分位为 0.81。应将 accent_by 视为协变量,或限制为 paper 以获得变音符号统一的子集。
style_vectors — 3,224,119 行诗句的 768 维 KainoBERT 状态
本数据集中每行不同诗句及参考语料,各由 Urdatorn/KainoBERT(未审计的古希腊语 ModernBERT-base 掩码语言模型)编码一次。向量为平均池化的最后隐藏状态,以 float16 原样存储。此处无分类头也无作者判定:向量是可为其写似然的观测量。
文本在模型自身的预训练表面上编码,小写化并去标点,保留多音调符号,iotacism adscript 先规范化为 subscript(Diggle 的欧里庇得斯、纸草及复原器写 adscript;风格计量约定为 subscript);surface 为实际输入模型的字符串,text 为原始文本。
sources |
行数 | 内容 |
|---|---|---|
corpus |
27,506 | 真实抑扬格三音步:埃斯库罗斯 1,779、索福克勒斯 7,545、欧里庇得斯 18,182 |
intact |
12 | 纸草第 1-12 行,真实索福克勒斯 |
henry |
17 | W. B. Henry 对第 13-29 行的补遗 |
conjecture |
2,954,680 | 来自 stoicheia 配置的全部四个 run 的不同诗句 |
candidate |
241,916 | 来自 candidates 配置的不同诗句 |
row 为矩阵中的位置,在单次发布内稳定;authors 为 corpus 行填充,verses 为与纸草位置关联的行填充。12 个 surface 出现于多个 source,故 sources 为列表。行按 surface 去重,故仅标点或大小写不同的两行诗句共享同一行,text 为首次出现的形式。
该空间的适用性(在留出语料行上测量):
- 弱作者判别器。 三个作者质心的余弦相似度为 0.993,200 个主成分上的线性判别达到 macro-F1 0.517,而多数类准确率基线为 0.660,埃斯库罗斯 F1 为 0.202。不要用它归属某行诗句。
- 可用的悲剧三音步模型。 真实索福克勒斯行距索福克勒斯质心的平均马氏距离为 51.7,12 行完整诗句为 47.7,Henry 的 17 行为 52.1,均远在分布范围内。
- 实际高维。 344 个成分承载 90% 方差,有效秩约 335,故激进降维会破坏信号。
- 协方差应共享而非按作者。 以池化作者内协方差为中心的逆 Wishart 先验在三个作者上均优于按作者协方差,对埃斯库罗斯每行优 312 nats,所选先验强度超过每位作者的行数。
注意该编码器已读过整个古希腊语语料,包括参考行来源的剧作及第 1-12 行的 Stobaeus 传抄。它未读过第 13-29 行的补遗,这些不在其训练材料中。故每个 corpus 行对模型熟悉,每个 conjecture 行新颖,这是在拟合前者似然并应用于后者时需记住的不对称性。
ll_verses 与 ll_imputations — 贝叶斯分析的似然表
每位悲剧作家下的逐行诗句证据,可直接求和为 Stan 数据块,以及将每个 stoicheia 插补映射到其 17 个诗句行的索引。作者顺序全程为埃斯库罗斯、索福克勒斯、欧里庇得斯。
ll_verses 每个 style_vectors 行一行,row 编号相同:
z1、z2:向量在三类共享协方差高斯(在 corpus 行上拟合)的两个判别方向上的坐标(第三个广义特征值为 1e-12:两个方向已足够,非降维)。ll_style2_<author>:该平面中 log N(z | author),共享 2×2 协方差在 corpus 上重新拟合;ll_style768_<author>:相同似然在完整 768 维空间中使用池化协方差。corpus 行为样本内评分。is_trimeter、pattern、caesura、n_resolutions:对每行同样派生的 Stoicheia-meter 特征;candidates诗句、完整诗句及 Henry 的在此重新扫描,以使两侧共享同一扫描器。ll_pattern_<author>、ll_res_<author>、ll_caes_<author>:完整 12 位置模式、resolution 计数(0、1、2+)及 caesura 在每位作者下的多项-Dirichlet 对数后验预测(add-one),基于扫描器接受的 23,916 行参考行。扫描器拒绝该行诗时为 NaN。
ll_imputations 每个 stoicheia 行一行:run、temperature、seed、conjecture_id、logp_total、all_trimeter、n_verses_trimeter;row_v13 … row_v29,诗句行;log_w,整个猜想温度-1 与温度-0.65 采样概率的对数比,log_w_v13 … log_w_v29 为每个空缺的对应值,针对保存了字母分布的 t065_seed2 run(其余为 NaN)。整猜想权重退化(有效样本量 100,000 中之 1);逐空缺权重每行诗句保持 81 至 31,519 的有效样本。
r library(arrow) V <- read_parquet("data/ll/verses.parquet"); I <- read_parquet("data/ll/imputations.parquet") idx <- as.matrix(I[I$all_trimeter, paste0("row_v", 13:29)]) + 1L LL <- sapply(c("aeschylus", "sophocles", "euripides"), function(a) rowSums(matrix(V[[paste0("ll_style2_", a)]][idx], ncol = 17)))
corpus — 27,523 行参考三音步
此处置信与似然所依据的三位悲剧作家的抑扬格三音步:埃斯库罗斯 1,780(Hypotactic 中手工扫描的三部剧作,保留 hypotactic_scansion)、索福克勒斯 7,545、欧里庇得斯 18,198(TLG 剧作,通过对行长、说话者及 strophe 标签的两态 HMM 找到对白三音步,再手工审计)。work、line、edition 与 speaker 给出出处。每行携带与复原诗句相同的 Stoicheia-meter scansion、bracketed 文本及格律特征(is_trimeter、pattern、caesura、n_resolutions、resolved、word_ends、porson_violation、n_elisions);扫描器接受三位作家行中的 93.9%、91.2% 及 84.4% 为三音步。
classifier_stoicheia 与 classifier_candidates — 微调归属分类器
为完整起见,端到端微调的 KainoBERT 悲剧作家分类器(三个种子,未读过 Tereus 的排行榜模型)对前两个 Stoicheia run 的每个不同诗句(1,452,914 行,含完整诗句及 Henry 的作为锚点)及对 Eric 的候选(241,945 行)的输出:logit_<seed>_<author> 与 prob_<seed>_<author>,标签顺序为埃斯库罗斯、欧里庇得斯、索福克勒斯。这些是分类器的后验而非似然,上述分析不使用它们。
lexicon_bare 与 lexicon_forms — 古希腊语词词典
Ericu950/AncientGreek(3.616 亿 token)中每个词形的 token 计数:lexicon_forms 保留带变音符号形式(656 万类型,iota adscript 规范化为 subscript,小写化),lexicon_bare 为去除所有变音符号并折叠 final sigma 的形式(521 万类型),这是复原器填补被评判的表面,因其变音符号为猜测。n_sources 为某形式出现的源作品数。
fills — 每行诗句一百个复原的候选列表
对第 13-29 行每行,一百个不同复原诗句(任一复原器)扫描为三音步、不含非词且无立即词重复,按等先验与 tau = 1 下风格与格律流的索福克勒斯 :(埃斯库罗斯或欧里庇得斯)对数几率排序。"无 非词" 指每个词的 Bayes factor real : not-Greek 在 scripts/real_greek.py 的词混合下高于一(对词典的 Dirichlet 过程 对照希腊语音位学的字母 4-gram 模型),且每个单字母 token 为希腊词或缩略残片。n_imputations 为包含该诗句的 Stoicheia 插补数(0:仅来自 candidates 流水线)。在同一混合下,参考语料与完整诗句评分完全为真,Henry 的补遗 0.993,Stoicheia 插补 0.873,候选 0.856 为真词;其格律干净诗句中分别有 37% 与 35% 不含非词(data/real_greek/summary.json)。
使用方法
python from datasets import load_dataset
passages = load_dataset("Urdatorn/tereus-imputation", "stoicheia", split="train") fills = load_dataset("Urdatorn/tereus-imputation", "candidates", split="train")
the style vectors, as a matrix
import numpy as np, pyarrow.parquet as pq, glob from huggingface_hub import snapshot_download d = snapshot_download("Urdatorn/tereus-imputation", repo_type="dataset", allow_patterns="data/style_vectors/") t = pq.read_table(sorted(glob.glob(f"{d}/data/style_vectors/.parquet"))) X = np.stack(t.column("embedding").to_numpy(zero_copy_only=False)).astype(np.float16) # (3224119, 768)
the 1,186-in-100,000 of one run whose every verse scans
clean = passages.filter(lambda r: r["all_trimeter"] and r["run"] == "t065_seed2")
注意事项
- 覆盖范围远未完整。 对 200,000 个温度 0.65 的插补进行 Good-Turing 估计,每行诗句的未见概率质量平均近 75%,从第 14 行的 39.5% 到第 25 行的 98.5%,累积曲线仍接近线性。真实读法可能缺失。
- 插补在 Rubin 意义下是不恰当的。 它们来自温度低于一的固定检查点,故模型不确定性缺失且分布被 temper。某填补在行间的频率不是其后验概率。熵或缺失质量是更安全的汇总。
- 格律可接受不等于格律正确。 过滤为扫描模型加三音步模板。caesura、Porson 定律及 resolution 限制在可用处记录但未强制执行。
- 两个配置不可通约。 一为段落级且联合采样,另一为诗句级且独立搜索。
出处与致谢
candidates 配置源自 Eric Cullhed(乌普萨拉大学)对《Tereus》纸草的工作,包括两配置所用的 Stoicheia 模型族。stoicheia 配置及本打包由 Albin Thörn Cleland(隆德大学,ORCID 0009-0003-3731-4038)完成。
底层纸草文本为 editio princeps 的文本;复原为机器生成,不具校勘权威。