
mille-agent-blueprints
收藏官方服务:
资源简介:
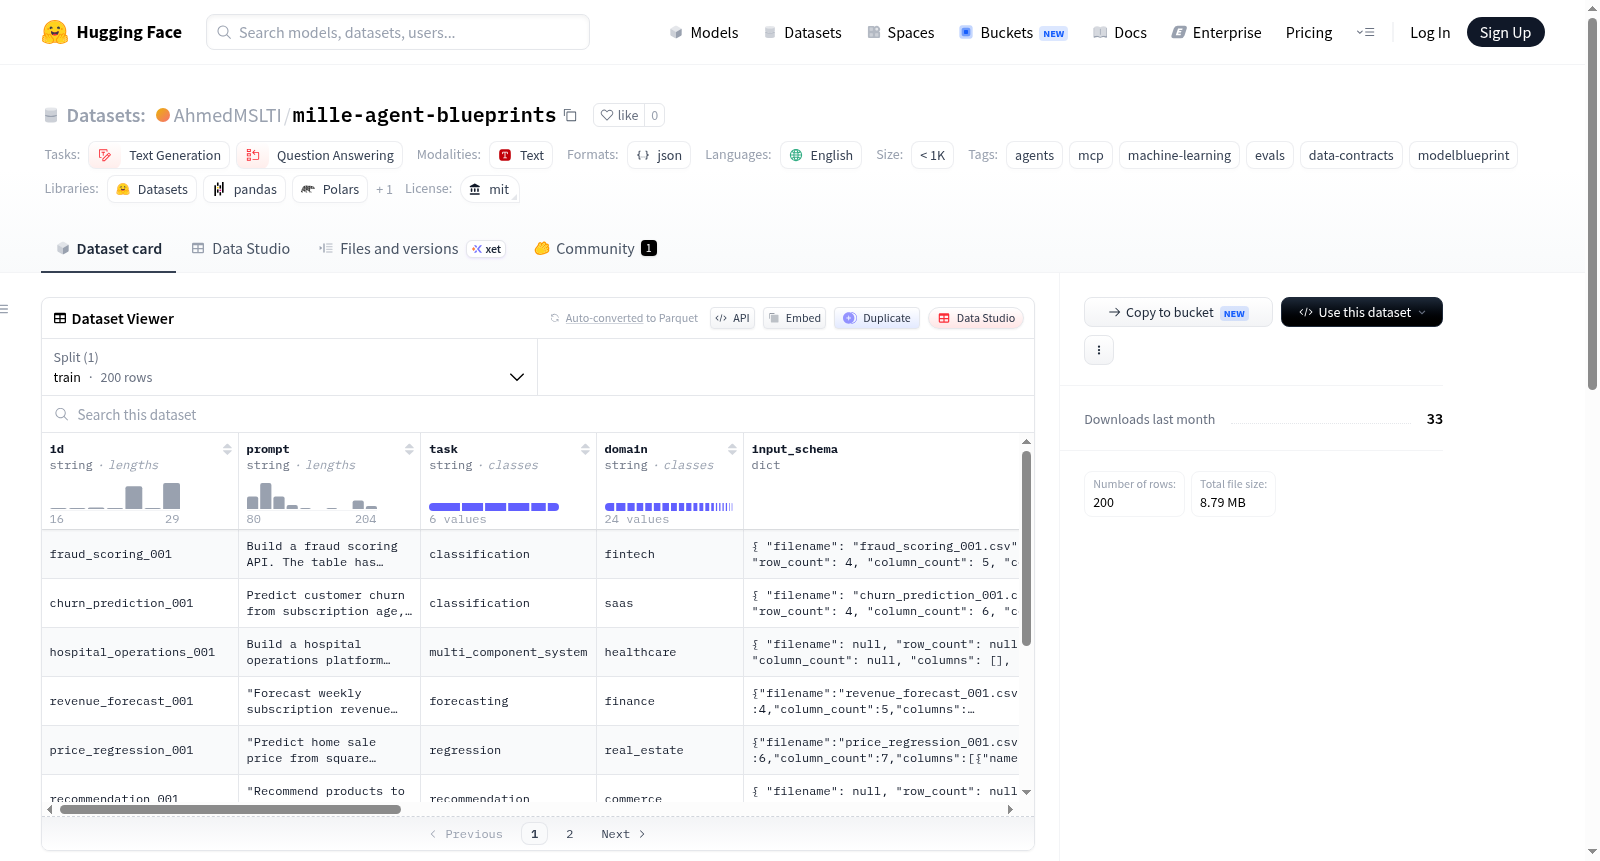
MILLE Agent Blueprints是一个用于评估规划机器学习系统的智能体的合成基准数据集。该数据集包含经过合约检查的示例,每个示例以JSONL格式存储,将自然语言描述的机器学习系统请求与MILLE生成的预期系统蓝图进行配对。当有样本CSV数据可用时,还会包含数据集配置文件。此外,每个示例都提供了评估标准和已知失败模式,用于系统化评估智能体表现。该数据集专门设计用于评估智能体在多个关键维度的能力:正确选择机器学习任务框架、保持数据合约和验证约束、识别数据泄漏和基线风险、生成可供智能体执行的实施计划,以及处理多组件机器学习系统(而非将其简化为单一模型)。数据集规模较小(少于1000个样本),作为初始合成种子集发布,主要适用于产品验证、演示、回归测试和早期智能体基准测试,不应被视为全面的基准测试套件或真实生产数据源。数据生成遵循MILLE Space仓库中的脚本,并在写入前通过公开的MILLE模式合约进行验证。
创建时间:
2026-07-03
原始信息汇总
数据集概览
- 名称:MILLE Agent Blueprints
- 语言:英语(en)
- 许可证:MIT
- 任务类别:文本生成、问答
- 标签:agents、mcp、machine-learning、evals、data-contracts、modelblueprint
- 数据规模:少于1000条记录(n<1K)
数据内容
数据集包含合成的、经合约检查的示例,用于评估规划机器学习系统的智能体。每条JSONL记录包含以下要素:
- 一个用自然语言描述的机器学习系统需求
- MILLE生成的预期蓝图
- 数据集概况(当提供样本CSV数据时)
- 评估准则(rubric criteria)
- 已知的失败模式
文件结构
- records.jsonl:基准评估记录,遵循MILLE Space仓库中的
schemas/mille-eval-record.schema.json模式。
预期用途
该数据集用于评估智能体在以下方面的能力:
- 选择正确的机器学习任务框架
- 保留数据合约和验证约束
- 识别数据泄露和基线风险
- 生成智能体可执行的实施计划
- 处理多组件机器学习系统,而非将其简化为单一模型
局限性
- 首个版本为合成的种子集
- 适用于产品验证、演示、回归测试和早期智能体基准测试
- 不应被视为全面的基准测试集或真实生产数据的来源
数据生成
记录由MILLE Space仓库中的 scripts/build-mille-eval-dataset.mjs 脚本生成,并在写入前根据公开的MILLE模式合约进行验证。
搜集汇总
数据集介绍
构建方式
本数据集通过自动化合成流程构建,基于MILLE Space仓库中的`scripts/build-mille-eval-dataset.mjs`脚本生成记录,并依据公开的MILLE模式合约进行严格验证,确保每条数据符合预定义的结构化规范。每条JSONL记录包含自然语言描述的机器学习系统请求、MILLE生成的预期蓝图、样本CSV数据(若可用)对应的数据集概况、评估准则及已知失败模式,形成结构化的评测基准。
特点
该数据集聚焦于评测代理在规划机器学习系统时的多维度能力,包括任务框架选择、数据合约与验证约束的保持、数据泄露与基线风险的识别、代理就绪实现计划的生成,以及多组件系统的整体处理。其独特之处在于强调合同检查的合成用例,覆盖典型失败模式,为早期代理基准测试和回归测试提供针对性评估资源。
使用方法
数据集主要用于代理系统的能力评估与产品验证。用户可通过加载`records.jsonl`文件,结合MILLE模式合约对代理生成的计划进行合同检查,对比预期蓝图与代理输出,从而量化其在任务框架、数据约束、风险识别等维度的表现。典型应用场景包括演示、回归测试及早期基准比较,但不应视作全面基准或真实生产数据源。
背景与挑战
背景概述
MILLE Agent Blueprints数据集由MILLE研究团队于近期构建,旨在评估智能体在规划机器学习系统时的能力。该数据集聚焦于核心研究问题:智能体能否从自然语言描述中生成符合规范的系统蓝图。通过提供合成但经过合同校验的示例,它填补了智能体评估领域缺乏结构化基准的空白,对推动自动化机器学习系统设计的研究具有重要影响力,尤其适用于产品验证、回归测试和早期基准测试等场景。
当前挑战
该数据集面临的挑战主要涵盖两方面。在领域问题层面,它致力于解决智能体在规划多组件机器学习系统时难以选择正确任务框架、维护数据合同与验证约束、识别数据泄漏和基线风险等核心难题。在构建过程中,挑战在于生成高质量的合成数据,确保每个记录都严格遵循MILLE模式合同,同时避免引入真实生产数据的复杂性,从而在有限样本(n<1K)下保持基准的可靠性和代表性。
常用场景
经典使用场景
该数据集专为评估智能代理在机器学习系统规划任务中的表现而设计,其经典使用场景聚焦于验证代理能否从自然语言描述的需求出发,自主完成ML任务的合理选择、数据合约与验证约束的维护、数据泄露与基线风险的识别,以及多组件ML系统实施方案的生成。每一行JSONL记录均包含一个由自然语言驱动的ML系统请求、对应的预期蓝图、样本CSV数据概况、评分标准及已知失败模式,从而为代理的端到端规划能力提供结构化的评估基准。
实际应用
在实际应用层面,该数据集主要服务于产品验证、演示原型、回归测试和早期代理基准测试等场景。对于开发机器学习助手或自动化ML平台的企业团队,它提供了一套轻量级但结构化的测试工具,用以甄别代理在理解复杂需求、维护数据约束和避免常见陷阱方面的实际表现。此外,该数据集还可用于教学演示,帮助从业者直观理解ML系统规划中的关键环节,或作为持续集成流水线的一部分,确保代理系统在迭代更新中不退化其规划能力。
衍生相关工作
该数据集衍生了一系列相关经典工作,包括围绕其合约检查模式构建的评估框架、基于记录中已知失败模式开发的故障诊断算法,以及利用预期蓝图为引导的代理规划优化方法。其生成脚本与公开的MILLE系列架构紧密结合,催生了诸如蓝图自动验证工具、数据合约一致性检测器,以及面向多组件ML任务的规划粒度评估体系等衍生成果。这些工作共同推动了智能代理从简单问答向复杂系统规划能力的范式跃迁,并为人机协作的ML系统开发提供了新的评估与改进路径。
以上内容由遇见数据集搜集并总结生成


