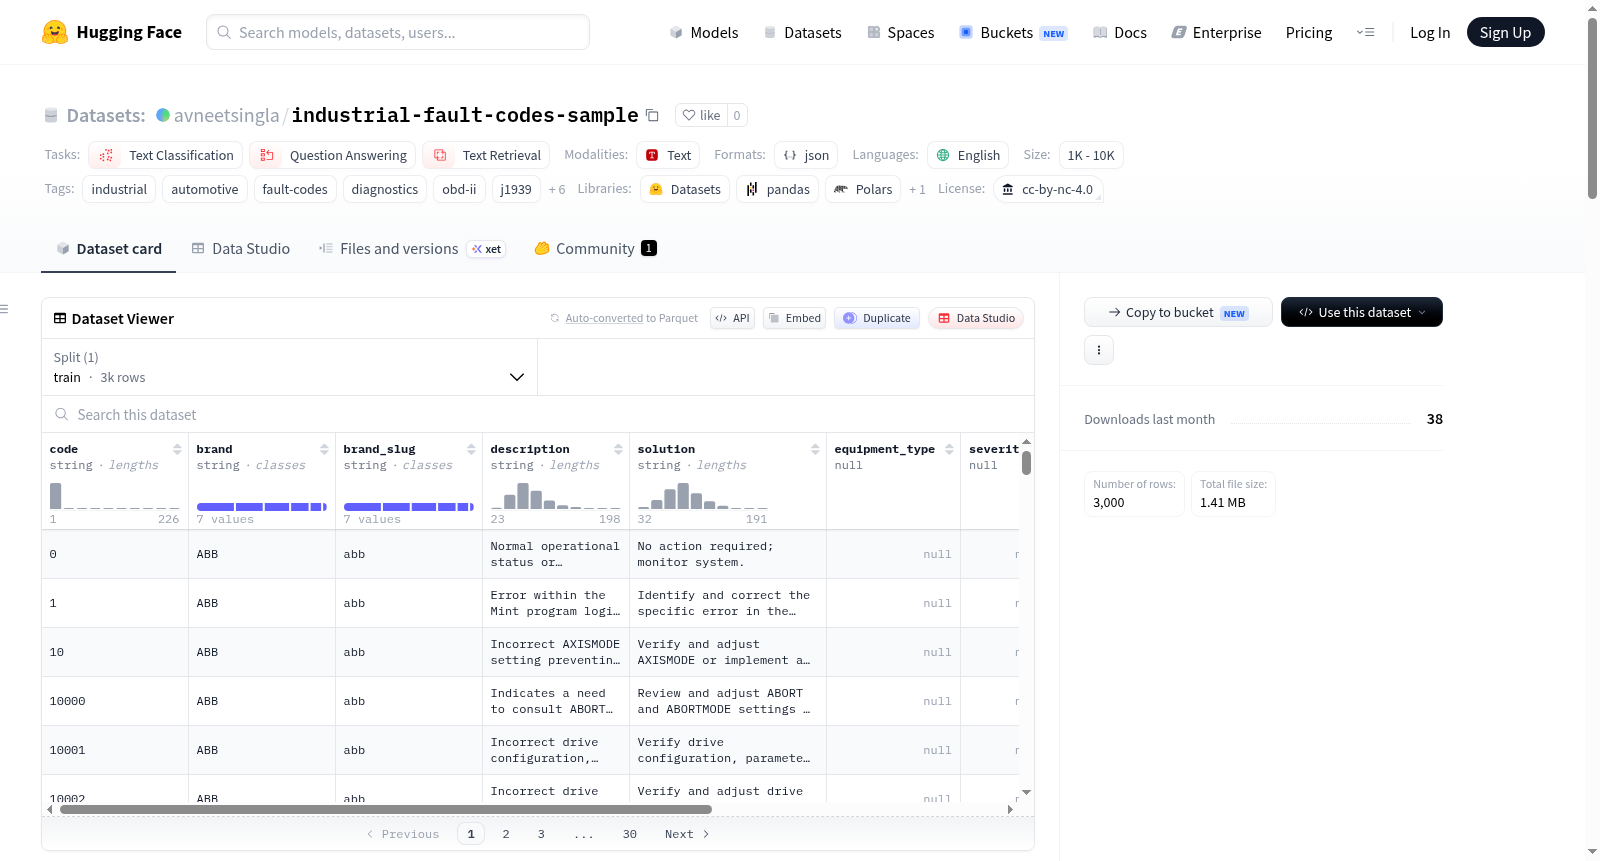
industrial-fault-codes-sample
收藏资源简介:
FixFaults工业故障代码样本数据集是FixFaults工业维修百科全书的公开样本,包含2,808条记录(每周从在线目录更新)。每条数据将制造商的故障代码与人类可读的故障描述和推荐的维修操作配对,旨在为诊断大语言模型(LLM)的微调、评估或检索提供即用数据。完整语料库包含超过70,000条代码,覆盖82个以上制造商(如Caterpillar、Cummins、Siemens、Fanuc、ABB、Bobcat、Haas、Yaskawa、Daikin等),并支持OBD-II、J1939等标准。数据模式包括:故障代码(code)、品牌(brand)、品牌标识符(brand_slug)、故障描述(description)、解决方案(solution)、设备类型(equipment_type,如柴油机、暖通空调、数控机床、伺服驱动器、可编程逻辑控制器)、严重性等级(severity,分低、中、高、关键四级)、文章永久链接(permalink)和源文章URL(source_url)。该数据集适用于多种任务,包括构建诊断助手或维修LLM(通过微调实现从代码和品牌到描述和解决方案的映射)、基于技术文档的检索增强生成(RAG)、基于描述和解决方案的严重性分类、跨品牌相似代码的消歧,以及作为多语言翻译流程的种子数据。数据集采用CC-BY-NC 4.0许可证,允许非商业用途的研究、评估和个人使用,需注明出处;商业用途需获取商业许可或使用其在线API。
The FixFaults Industrial Fault Code Sample Dataset is a public sample from the FixFaults Industrial Repair Encyclopedia, containing 2,808 records (updated weekly from the online catalog). Each record pairs a manufacturers fault code with a human-readable fault description and recommended repair actions, designed to provide ready-to-use data for fine-tuning, evaluating, or retrieving diagnostic large language models (LLMs). The full corpus includes over 70,000 codes, covering more than 82 manufacturers (such as Caterpillar, Cummins, Siemens, Fanuc, ABB, Bobcat, Haas, Yaskawa, Daikin, etc.) and supports standards like OBD-II and J1939. The data schema includes: fault code (code), brand (brand), brand identifier (brand_slug), fault description (description), solution (solution), equipment type (equipment_type, e.g., diesel engines, HVAC, CNC machines, servo drives, programmable logic controllers), severity level (severity, categorized as low, medium, high, critical), article permalink (permalink), and source article URL (source_url). This dataset is suitable for various tasks, including building diagnostic assistants or repair LLMs (by fine-tuning to map from codes and brands to descriptions and solutions), retrieval-augmented generation (RAG) based on technical documentation, severity classification based on descriptions and solutions, disambiguation of similar codes across brands, and serving as seed data for multilingual translation workflows. The dataset is licensed under CC-BY-NC 4.0, allowing non-commercial use for research, evaluation, and personal purposes with attribution; commercial use requires a commercial license or use of its online API.
数据集概述:FixFaults Industrial Fault Codes — Sample
这是一个工业故障代码样本数据集,来源于 FixFaults 工业维修百科,主要用于诊断型大语言模型的微调、评估或检索。
- 许可证:CC-BY-NC 4.0(非商业用途免费,商业用途需联系获取许可或使用官方API)。
- 语言:英语。
- 数据集大小:约 2,808 条记录(每周从实况目录自动刷新)。
- 任务类型:文本分类、问答、文本检索。
数据内容与结构
每条数据记录包含一个制造商故障代码及其对应的可读描述和推荐维修操作。数据集的列结构如下:
| 列名 | 类型 | 描述 |
|---|---|---|
code |
字符串 | 故障/错误代码(例如 P0420、A.022、SPN 4364 FMI 5) |
brand |
字符串 | 制造商/标准名称(例如 Cummins、OBD-II、Siemens) |
brand_slug |
字符串 | 品牌标识符(小写,连字符分隔) |
description |
字符串 | 故障的可读描述 |
solution |
字符串 | 推荐的维修/下一步诊断操作 |
equipment_type |
字符串 | 设备类别(例如 diesel、hvac、cnc、servo-drive、plc) |
severity |
字符串 | 严重级别:low / medium / high / critical |
permalink |
字符串 | FixFaults.com 上源文章的别名(slug) |
source_url |
字符串 | 源文章的标准URL |
适用场景
- 诊断助手与维修LLM:将
(code, brand)映射到(description, solution),用于微调模型以构建维修聊天机器人。 - RAG(检索增强生成):嵌入数据行作为“此代码含义”问题的真实检索数据,并使用
source_url作为引用链接。 - 严重性分类:训练模型根据
description和solution预测severity。 - 多品牌映射:区分不同品牌中外观相似的代码(例如 Yaskawa 与 ABB 的
A.022)。 - 多语言种子:使用英文描述作为翻译管道的标准种子。
完整数据集与API
- 完整语料库包含 70,000+ 条代码,覆盖 82 家以上制造商(如 Caterpillar、Cummins、Siemens、Fanuc、ABB、Bobcat、Haas、Yaskawa、Daikin、OBD-II、J1939 等)。
- 通过 REST API 提供,免费层每月 500 次请求,无需信用卡。
- 官方文档及 SDK 链接见
Hugging Face页面。