turk-ictihat-kararlari-fulltext
收藏资源简介:
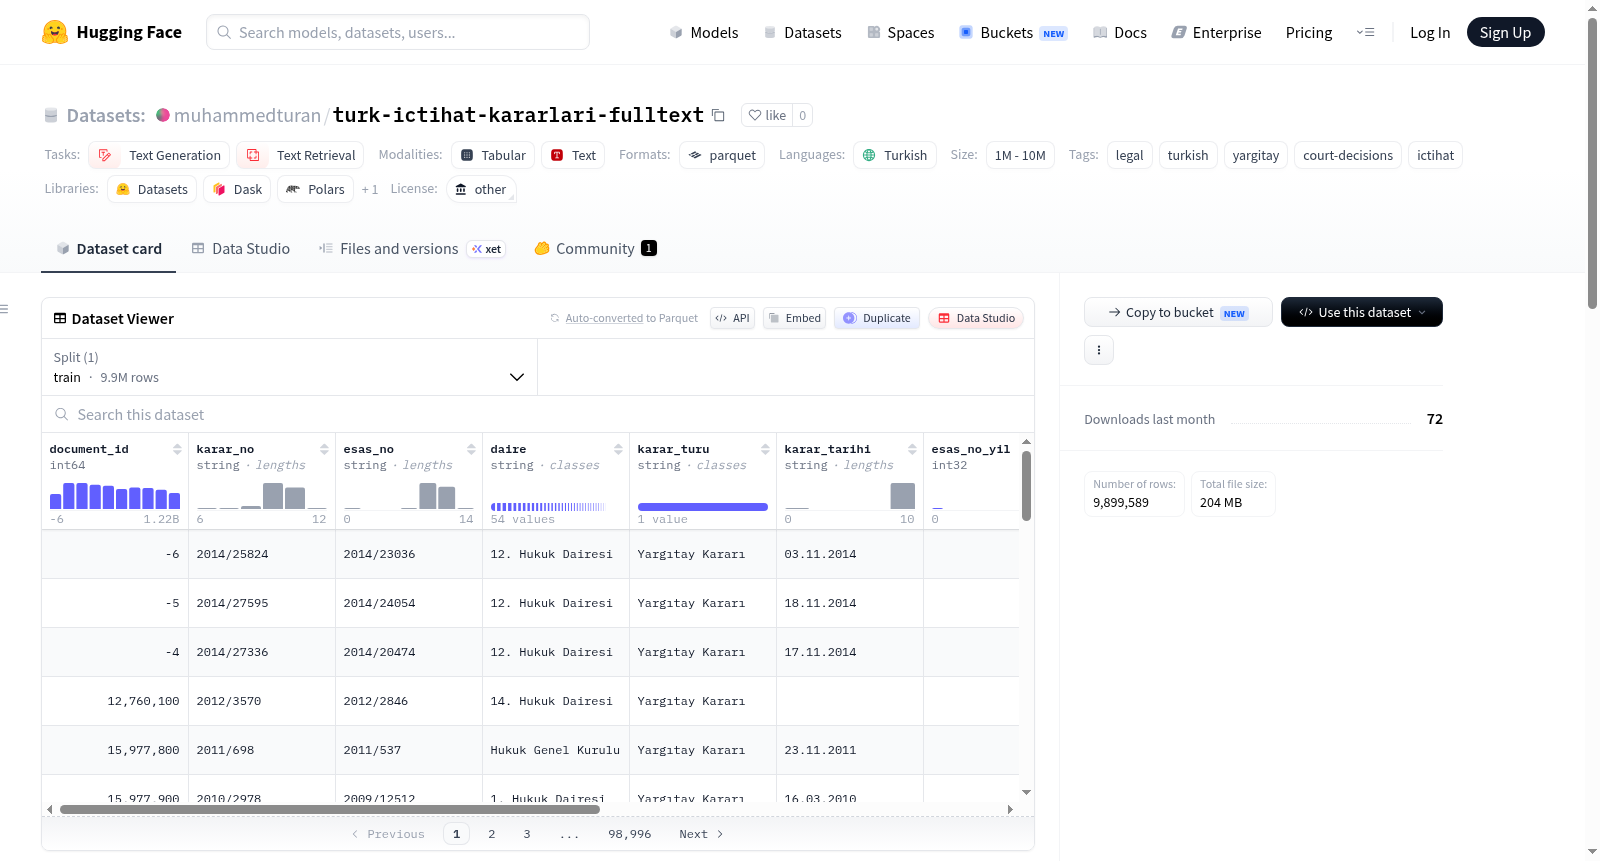
本数据集来源于土耳其司法部 UYAP 系统的 e-Bedesten 公共平台(bedesten.adalet.gov.tr),通过概念关键词搜索收集了土耳其最高法院(Yargıtay)的判决全文。数据规模约为 9,899,589 条唯一判决记录,时间范围覆盖 1993 年至 2026 年。其中约 39,301 条判决包含完整文本(逐步补充中)。数据集包含以下字段:document_id(文档 ID)、karar_no(判决号)、esas_no(案号)、daire(法院部门)、karar_turu(判决类型,通常为“Yargıtay Kararı”)、karar_tarihi(判决日期,格式 dd.mm.yyyy)、esas_no_yil(案号年份)、karar_no_yil(判决年份)、kesinlesme(判決确定状态)、matched_terms(匹配的搜索词列表)、text(判决全文,可能为空)。该数据集适用于文本生成(如法律文本摘要、判决书生成)和文本检索(如法律案例检索)任务。注意:判决文本可能包含当事人姓名等个人数据,使用时需根据土耳其个人数据保护法(KVKK)评估使用目的。
This dataset originates from the e-Bedesten public platform (bedesten.adalet.gov.tr) of the Turkish Ministry of Justices UYAP system, collecting full-text decisions of the Turkish Supreme Court (Yargıtay) through concept keyword search. It contains approximately 9,899,589 unique decision records, spanning from 1993 to 2026. About 39,301 decisions include full text (gradually being supplemented). The dataset includes the following fields: document_id, karar_no (decision number), esas_no (case number), daire (court department), karar_turu (decision type, typically Yargıtay Kararı), karar_tarihi (decision date in dd.mm.yyyy format), esas_no_yil (case year), karar_no_yil (decision year), kesinlesme (finalization status), matched_terms (list of matching search terms), and text (full decision text, may be empty). It is suitable for text generation tasks (e.g., legal text summarization, judgment generation) and text retrieval tasks (e.g., legal case retrieval). Note: The decision texts may contain personal data such as party names; users must evaluate the purpose of use in accordance with the Turkish Personal Data Protection Law (KVKK).
数据集概述
该数据集为土耳其最高法院(Yargıtay)判决全文数据集,内容源自土耳其司法部UYAP法规与判例程序(e-Bedesten)公共平台,通过概念化检索查询收集而成。数据集以土耳其语呈现,属于法律领域文本资源。
基本信息
- 语言:土耳其语(tr)
- 任务类型:文本生成、文本检索
- 标签:法律、土耳其语、最高法院、法院判决、判例
- 记录规模:9,899,589条唯一判决
- 许可协议:其他(other)
- 收集日期:2026年9月7日
数据规模与覆盖范围
- 记录总数:9,899,589条唯一判决记录
- 年份跨度:1993年至2026年
- 全文数量:39,301条(持续增量补充中)
- 搜索词分布:
- "karar"(判决):9,894,542条
- "bosanma"(离婚):100,052条
- "tazminat"(赔偿):100,052条
- "nafaka"(赡养费):66,241条
数据字段结构
| 字段名 | 类型 | 说明 |
|---|---|---|
| document_id | int64 | e-Bedesten文档标识 |
| karar_no | string | 判决编号(如2026/6738) |
| esas_no | string | 主案编号 |
| daire | string | 最高法院审判庭 |
| karar_turu | string | 判决类型(最高法院判决) |
| karar_tarihi | string | 判决日期(日.月.年格式) |
| esas_no_yil | int32 | 主案年份 |
| karar_no_yil | int32 | 判决年份 |
| kesinlesme | string | 终局状态 |
| matched_terms | list[string] | 匹配的检索词 |
| text | string | 判决全文(可空,增量填充) |
使用方式
通过Hugging Face datasets库加载:
python from datasets import load_dataset ds = load_dataset("muhammedturan/turk-ictihat-kararlari-fulltext")
重要说明
- 数据来源:土耳其司法部e-Bedesten公共服务平台(bedesten.adalet.gov.tr)
- 构建方法:采集代码存放于该仓库的
crawler/目录中,支持可恢复的SQLite状态及按年份分段处理 - 隐私考量:判决文本可能包含当事人姓名等个人信息,使用者需依据土耳其《个人数据保护法》(KVKK)评估使用目的
- 数据状态:全文判决数量仍在持续增量补充中