
JetBrains-Research/cwm-benchmarks-dl4c-traces
收藏官方服务:
资源简介:
该数据集包含函数调用的详细跟踪信息,包括时间消耗、内存使用、事件计数、调用序列等。用于性能分析和调试。
This dataset contains detailed trace information from function calls, including timing, memory usage, event counts, and call sequences. It is used for analyzing performance and debugging.
提供机构:
JetBrains-Research搜集汇总
数据集介绍
构建方式
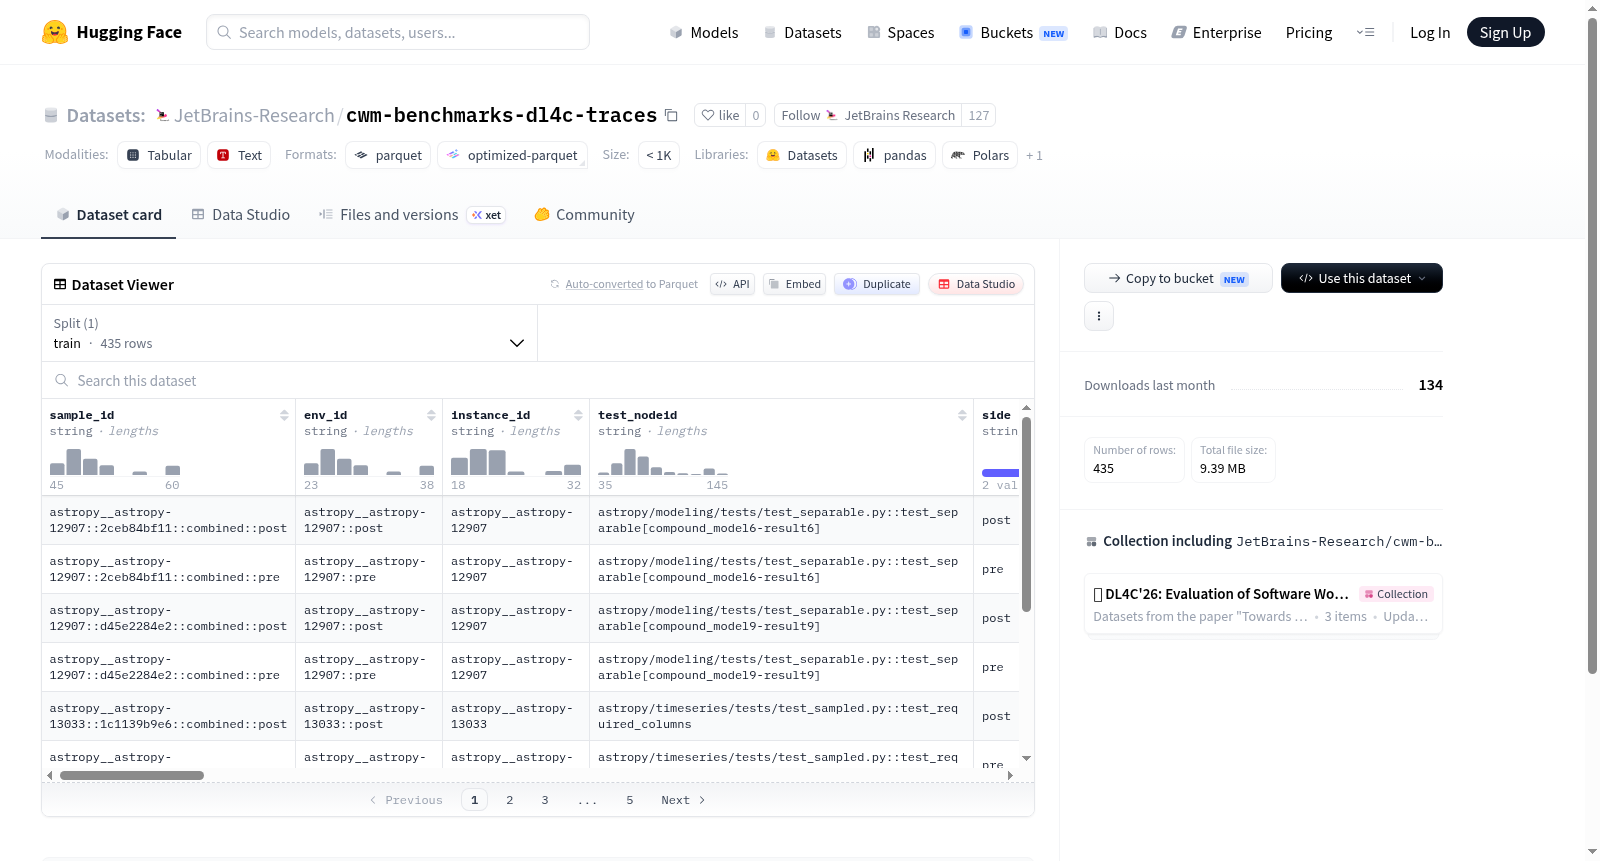
在深度学习持续集成与交付的复杂场景中,性能追踪数据是优化迭代的关键资产。cwm-benchmarks-dl4c-traces数据集以系统化的方式采集了435个训练样本,每个样本包含从环境配置到函数调用的完整生命周期记录。通过结构化的特征设计,数据集整合了样本标识、环境信息(如测试节点ID、后端类型、Python版本)、运行时性能指标(如墙钟时间、各阶段耗时、内存占用峰值)以及调用序列数据。构建过程确保了对每一次实验的精细化追踪,支持从启动到拆除的全程性能分析。
特点
该数据集具备多维度的性能追踪特性,覆盖了深度学习工作流的多个关键剖面。每个样本都包含丰富的时序信息,如setup_time_s、call_time_s和teardown_time_s,能够精确揭示任务各阶段的耗时分布。同时,通过start_rss_bytes与peak_rss_bytes等内存指标,以及事件计数与调用序列数据,数据集提供了对资源消耗与执行逻辑的深层洞察。此外,traced_files、test_files与neighbor_files等列表字段,保持了样本间依赖关系的可追溯性,为系统级性能优化研究奠定了坚实基础。
使用方法
本数据集可通过HuggingFace Datasets库便捷加载,默认配置为default,使用单split(train)结构,数据文件路径为data/train-*。用户可在Python环境中执行`load_dataset("cwm-benchmarks-dl4c-traces")`完成加载,随后通过pandas或原生API将数据转换为DataFrame格式,便于进行统计分析或机器学习建模。数据集支持按需过滤字段与样本,适用于性能基准测试、资源预测建模以及调用链异常检测等研究场景,科研人员可依据自身需求灵活转换数据格式以适配工作流。
背景与挑战
背景概述
随着深度学习在不同领域中的广泛应用,确保其软件实现的正确性与稳定性成为一项关键挑战。特别是在持续集成与持续交付(CI/CD)的背景下,对深度学习代码进行细粒度的性能与行为追踪显得尤为重要。该数据集名为cwm-benchmarks-dl4c-traces,由相关研究机构创建,旨在系统性地收集深度学习代码在多种环境下的执行轨迹。核心研究问题聚焦于如何通过轨迹数据揭示代码执行中的异常模式、资源消耗与潜在缺陷,从而提升深度学习代码的可靠性。该数据集为后续的代码分析、性能优化以及自动化测试提供了宝贵的基准资源,对推动深度学习代码质量保障领域的发展具有显著影响。
当前挑战
该数据集所解决的领域问题在于,深度学习代码的复杂性与其执行环境的多样性导致传统软件测试方法难以全面覆盖其行为模式。具体挑战包括:一是如何精准捕捉不同后端、不同Python版本以及不同内存追踪设置下的代码执行差异;二是构建过程中需要处理大量异构的执行轨迹数据,并确保其完整性与一致性,例如区分设置、调用与拆卸等不同阶段的时间消耗;三是需要识别并标记调用序列截断等异常情况,以反映真实环境中资源受限或执行中断的场景。这些挑战促使数据集设计者采用精细化的追踪架构,并记录包括内存峰值、函数调用序列在内的详尽特征,为深度学习代码的稳健性分析奠定坚实基础。
常用场景
经典使用场景
在深度学习的连续性集成与部署流程中,对模型训练与推理过程中的资源消耗进行精准追踪至关重要。cwm-benchmarks-dl4c-traces数据集正是为此而生,其经典使用场景聚焦于分析深度学习工作负载在分布式环境下的性能特征。通过记录每个样本的执行时间、内存占用峰值、调用序列及追踪文件等细粒度指标,该数据集为研究者提供了考察不同深度学习框架后端(如PyTorch、TensorFlow)在相同任务上资源效率差异的标准化基准。此外,它还能用于剖析多实例并行训练时的资源争抢模式,揭示环境配置、代码版本与硬件节点对计算性能的微妙影响,从而助力构建更高效、更可靠的深度学习CI/CD流水线。
衍生相关工作
基于cwm-benchmarks-dl4c-traces,研究者已衍生出多项关键工作。例如,有工作利用其中的调用序列与函数追踪数据,训练序列模型以预测深度学习程序的内存使用轨迹,实现了对OOM(内存溢出)错误的提前预警。另一些研究则聚焦于该数据集中的事件计数与耗时分布,开发出跨框架的性能瓶颈自动定位算法,能够比人工分析更快速地指出特定GPU内核调用或数据传输环节的优化空间。此外,该数据集还催生了面向CI场景的轻量级性能回归检测框架,通过哈希摘要与统计检验对比新旧提交的trace特征,实现了细粒度且零开销的异常感知,推动了深度学习DevOps实践的精细化发展。
数据集最近研究
最新研究方向
cwm-benchmarks-dl4c-traces数据集聚焦于深度学习持续集成(Continuous Integration for Deep Learning)领域的性能追踪与资源剖析,为模型训练流程中的时间消耗与内存占用提供了细粒度的基准。当前前沿研究方向包括利用该数据集构建异常检测模型,以识别训练任务中的资源泄漏或性能退化;同时,结合调用序列(call_sequence)与函数级追踪信息,研究者正探索深度学习工作负载的自动化瓶颈诊断与优化(如编译时内存调度)。该数据集的意义在于弥合了传统软件工程基准与深度学习特有问题(如动态图执行、GPU内存碎片)之间的鸿沟,为开发鲁棒的CI/CD流水线提供了实证基础。通过公开435个训练样本的完整执行轨迹与资源快照,它推动了可复现的、面向数据科学的软件质量保障研究。
以上内容由遇见数据集搜集并总结生成


