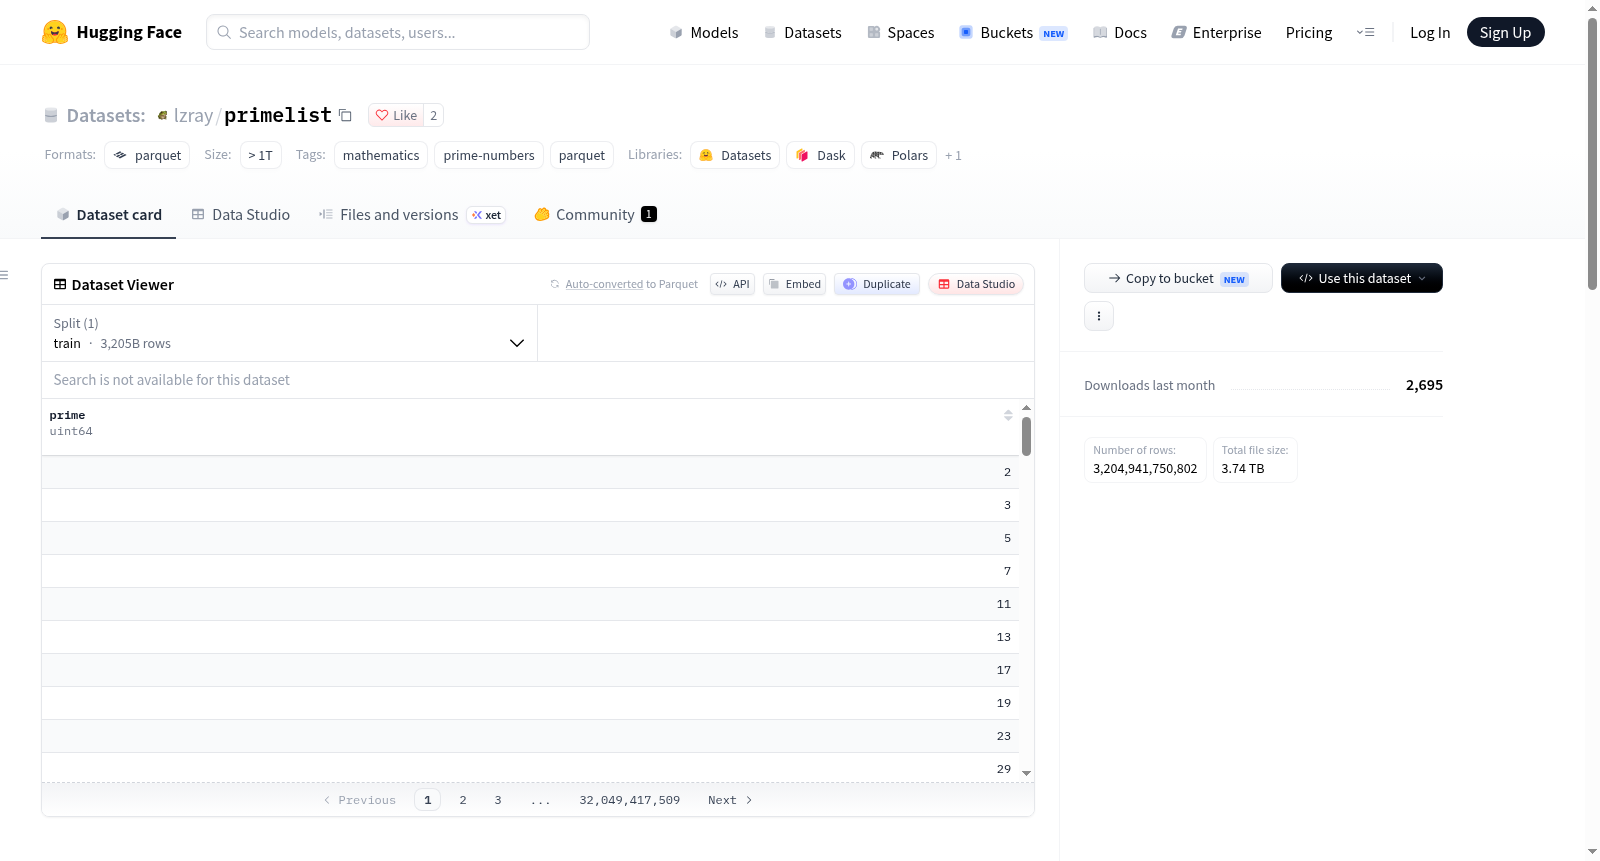
primelist
收藏资源简介:
该数据集为Prime List from 1 to 1e14,旨在提供从1到100,000,000,000,000(1e14)之间的所有素数,并以Parquet格式发布,便于流式传输、选择性分片下载和在线预览。数据集仅包含素数数值,不包含标签、自然语言内容或衍生特征。数据覆盖范围为1 ≤ p < 1e14,共分为1000个分片,每个分片覆盖1e11的整数区间,文件名格式为part-NNNN-of-1000.parquet(NNNN从0000到0999)。每个分片内的素数严格递增,所有分片合并后得到全局有序的完整素数列表。数据模式包含一个prime字段,类型为uint64,不可为空,数据页使用ZSTD压缩。用户可通过Hugging Face Datasets以流式模式加载数据,无需下载整个数据集。该数据集适用于素数枚举、数学研究、数值测试等场景。
The dataset is Prime List from 1 to 1e14, which aims to provide all prime numbers from 1 to 100,000,000,000,000 (1e14) and is published in Parquet format for easy streaming, selective shard download, and online preview. The dataset contains only prime numbers, no labels, natural language content, or derived features. The coverage is 1 ≤ p < 1e14, divided into 1000 shards, each covering an integer interval of 1e11, with filenames like part-NNNN-of-1000.parquet (NNNN from 0000 to 0999). Primes are strictly increasing within each shard, and merging all shards yields a globally ordered complete prime list. The schema has a single prime field of type uint64, non-nullable, with ZSTD compression on data pages. Users can load the dataset in streaming mode via Hugging Face Datasets without downloading the entire dataset. It is suitable for prime enumeration, mathematical research, numerical testing, etc.
数据集概述:Prime List from 1 to 1e14
基本信息
- 数据集名称:Prime List from 1 to 1e14
- 数据集标识:
lzray/primelist - 类别标签:数学、素数、Parquet格式
- 语言:不包含自然语言内容或无标签数据,仅包含素数数值
数据范围与内容
- 覆盖范围:包含从1到100,000,000,000,000(即
1e14)之间的所有素数,且按升序排列 - 内容类型:仅提供素数数值,不包含标签、衍生特征或自然语言描述
- 数据唯一性:每个素数在整个数据集中仅出现一次
数据分片结构
- 数据目录:
1-1e14/ - 分片数量:共1,000个分片
- 分片命名规则:文件名符合
part-NNNN-of-1000.parquet模式,其中NNNN从0000到0999 - 分片间隔宽度:每个分片覆盖一个半开区间
[i * 1e11, (i + 1) * 1e11),其中i为分片索引(0到999) - 相邻分片关系:相邻分片的区间互不重叠、无间隔,按文件名顺序读取所有分片即可获得完整的全局有序素数列表
数据模式
- 字段:仅有
prime一列 - 字段类型:Arrow类型为
uint64,不可为空 - 排序规则:严格递增
- 压缩方式:数据页采用ZSTD压缩
使用建议
- 推荐方式:使用Hugging Face Datasets库的流式模式,避免一次性下载完整数据集
- 分段加载:如需特定数值范围,可选择与该范围相交的分片文件进行读取
- 类型注意:保留
uint64类型,避免将大数值转换为32位整数导致溢出
引用示例代码
python from datasets import load_dataset
primes = load_dataset( "lzray/primelist", data_files="1-1e14/*.parquet", split="train", streaming=True, )
for row in primes.take(10): print(row["prime"])
局限性说明
该数据集提供素数枚举数据,而非素性测试API或交互式计算工具。使用者需自行处理数值类型转换,确保不丢失精度。