
遇见数据集

zayn-burrito/countdown-cas-treatment

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

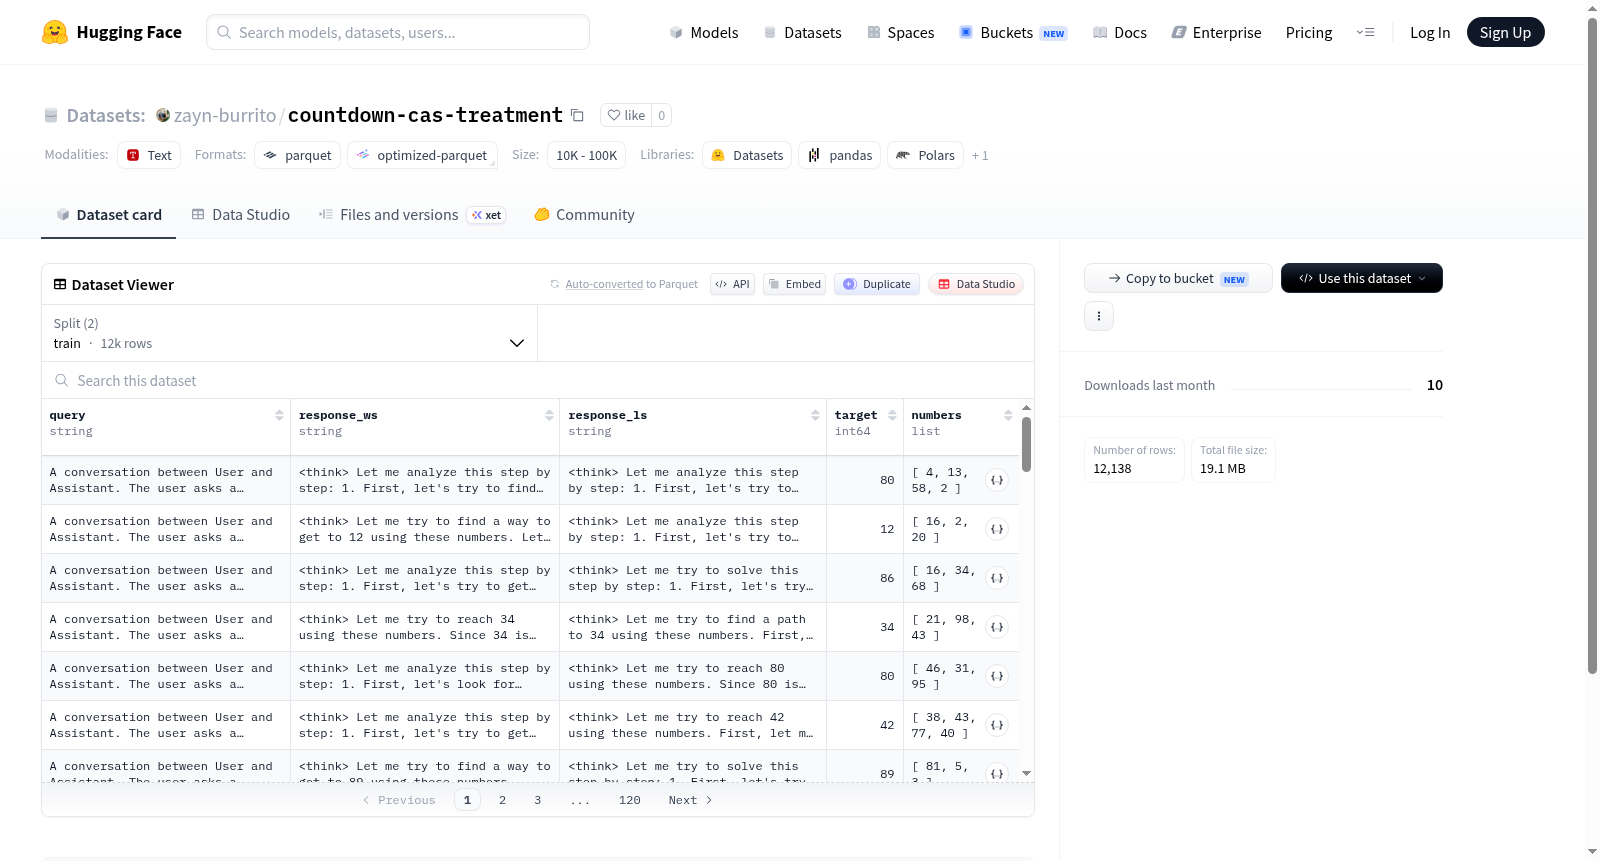
该数据集包含文本查询和响应数据,用于训练和测试模型在响应选择或偏好排序任务中的性能。数据集特征包括:查询文本(query)、两种响应文本(response_ws和response_ls,可能分别表示胜出响应和失败响应)、目标标签(target,可能用于指示偏好或分类)以及数字列表(numbers,可能用于辅助分析)。数据集分为训练集(12,000个示例)和测试集(138个示例),适用于自然语言处理任务,如对话系统、排序学习或文本比较。

This dataset contains text queries and responses, designed for training and testing models in response selection or preference ranking tasks. The features include: query text (query), two response texts (response_ws and response_ls, possibly representing winning response and losing response), target labels (target, likely used to indicate preferences or classifications), and a list of numbers (numbers, potentially for auxiliary analysis). The dataset is split into a training set (12,000 examples) and a test set (138 examples), suitable for natural language processing tasks such as dialogue systems, learning to rank, or text comparison.
提供机构:
zayn-burrito
搜集汇总
数据集介绍
zayn-burrito/countdown-cas-treatment 数据集图片
构建方式
countdown-cas-treatment 数据集旨在为逆向算术推理任务提供高质量的监督数据。其构建基于一种特殊的组合搜索策略,针对给定的目标数字与一组输入数字,通过约束搜索算法生成包含中间推理步骤的解答路径。数据集中每条样本包含原始查询指令(query)、两种不同粒度的推理过程表示(response_ws 与 response_ls),以及最终的目标数字与输入数字集合,从而便于模型学习多层次的推理表达。
使用方法
该数据集适用于微调大语言模型以提升其算术推理与分步解析能力。使用时可通过 HuggingFace Datasets 库加载默认配置,训练集和测试集的数据文件均以通配符路径 'data/train-*' 和 'data/test-*' 组织。推荐将双层推理表示分别用于监督训练与对比学习,或作为思维链(Chain-of-Thought)微调的标准输入输出格式,以评估模型在受限数字组合条件下的搜索与计算能力。
背景与挑战
背景概述
countdown-cas-treatment数据集由研究机构于近年创建,旨在解决复杂推理任务中的关键问题。该数据集围绕如何通过中间步骤增强大语言模型的数学推理能力展开,核心研究问题是探索在不同监督信号(如基于正确性的弱监督和基于中间推理步骤的强监督)下,模型对数字序列目标预测的泛化性能。通过精心设计的12000条训练样本和138条测试样本,该数据集为评估和提升模型在结构化问题上的推理能力提供了标准化基准,对推动语言模型在数值计算与多步推理领域的研究具有重要意义。
当前挑战
该数据集所解决的领域问题在于,当前大语言模型在面对需要多步运算的数值任务时,常常因忽略中间逻辑而给出错误答案。具体地,模型需要从给定数字集合中通过加减乘除运算组合至目标值,这一过程对推理的连贯性和计算准确性要求极高。构建过程中面临的挑战包括:如何生成多样化且无歧义的中间推理步骤,以确保监督信号的有效性;如何平衡不同难度样本的分布,避免模型对简单模式的过拟合;以及如何设计评价指标以准确衡量模型在依赖中间推理时的真实能力。
常用场景
经典使用场景
在自然语言处理与认知科学交汇的领域中,countdown-cas-treatment数据集因其独特的计数倒计时任务设计,成为探索语言模型算术推理能力的经典基准。研究者们利用该数据集评估模型在给定一组数字后,通过精确的算术运算逼近目标值的逻辑规划水平,这不仅是检验模型数值理解与多步推理能力的高难度挑战,更是区分模型是否具备系统化思考能力的重要试金石。其结构化的查询与双版本响应(文字推理与逻辑求解)设计,为剖析模型内在计算机制与语言输出一致性提供了无与伦比的精良素材。
解决学术问题
该数据集的核心学术贡献在于破解语言模型在复杂符号计算任务中的“认知迷思”。传统模型常陷于序列模式匹配的窠臼,而在需要精准规划与回溯的倒计时问题前暴露缺陷。通过此数据集,学界能够量化分析模型在数字组合搜索、子目标分解及错误纠正等高级认知环节的缺失,从而推动从“浅层模式仿真”向“深层逻辑推理”的技术跃迁。其意义在于引领了可解释性AI与神经符号系统的研究浪潮,明确了当前模型在新型算术推理泛化上的核心瓶颈。
实际应用
在面向未来强交互与高可靠性AI系统的实际应用中,该数据集驱动的技术成果可赋能教育科技领域的自适应学习引擎。例如,通过构建具备倒计时问题解决能力的智能辅导系统,能够实时诊断学生在数学组合推理中的思维断层,并提供个性化的解题路径提示。此外,在金融风控与自动化物流规划等需要多步约束优化求解的工业场景中,基于此数据集训练出的模型可作为轻量级数字推理插件,增强现有系统在非标准运算条件下的决策稳健性。
数据集最近研究
最新研究方向
在认知科学与人工智能的交叉领域,Countdown-CAS-Treatment数据集以其独特的'倒计时'计算任务设计,正在成为评估与增强大语言模型符号推理与数值操作能力的前沿基准。该数据集包含多个响应维度(如response_ws与response_ls),细致记录了模型在不同策略下的解题轨迹,这使得它能够支撑因果推理分析,探索模型内部决策机制与人类认知过程的相似性。当前研究热点聚焦于利用该数据集评测模型在受控条件下的算术推理稳健性,以及通过干预训练数据分布来提升模型对复杂数字组合的泛化能力。这些探索不仅推动着AI向更类人的符号处理能力迈进,也为理解认知发展过程中数字处理规律提供了关键的研究窗口。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

