
diatribe00/italian-legal-lab-data
收藏官方服务:
资源简介:
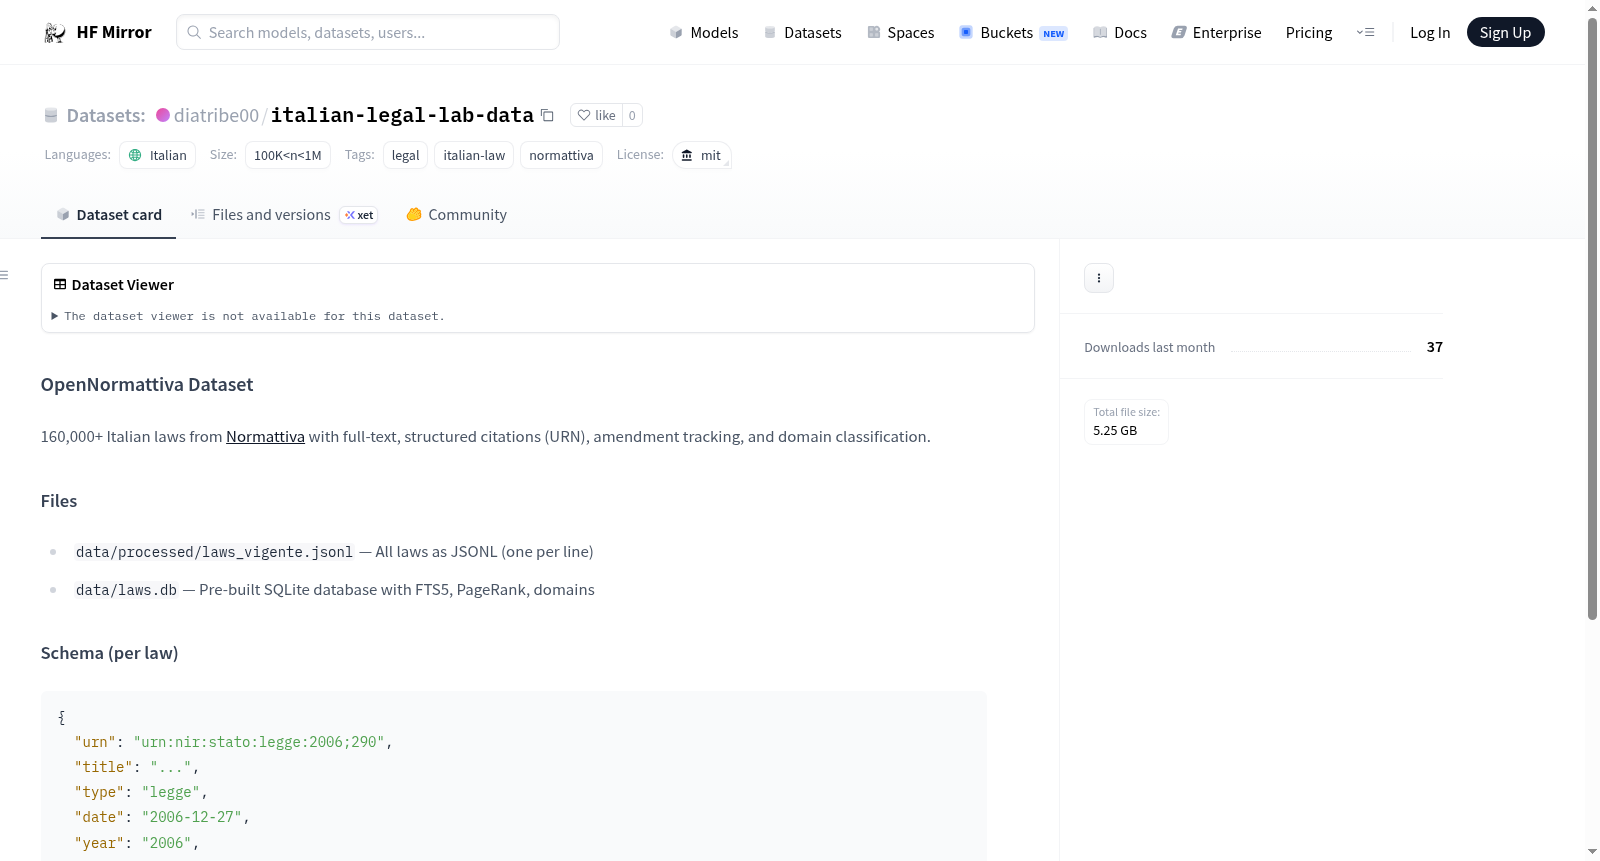
OpenNormattiva数据集包含来自Normattiva的160,000多条意大利法律,具有全文、结构化引用(URN)、修订跟踪和领域分类。数据集以JSONL和SQLite格式提供,每条法律的模式以JSON格式给出。许可证为MIT,语言为意大利语。标签表明数据集与法律和意大利法律相关。
The OpenNormattiva Dataset contains over 160,000 Italian laws from Normattiva with full-text, structured citations (URN), amendment tracking, and domain classification. The dataset is available in JSONL and SQLite formats, and the schema for each law is provided in JSON format. The license is MIT, and the language is Italian. The tags indicate that the dataset is related to legal and Italian law.
提供机构:
diatribe00搜集汇总
数据集介绍
构建方式
在意大利法律数字化进程中,OpenNormattiva数据集应运而生,其构建基于意大利官方法律门户Normattiva的公开资源。通过系统化爬取与结构化解析,数据集囊括了超过16万部意大利法律文献,每部法律均以JSONL格式存储,包含完整的文本内容、结构化URN标识、修订追踪信息以及领域分类标签。此外,数据集还提供了预构建的SQLite数据库,集成了FTS5全文检索、PageRank算法及领域分类功能,便于高效查询与管理。
特点
该数据集的核心特色在于其全面性与结构化深度。首先,它覆盖了意大利法律体系中从普通法律到立法令的多种类型,时间跨度广泛,确保了法律研究的完整性。其次,每条法律记录均包含详细的引用关系,通过URN标识精准指向被引用的法律条款,并附带通俗引用格式,极大便利了法律文献的关联分析。此外,内嵌的修订追踪机制允许用户追溯法律文本的变更历史,而领域分类则助力于专业领域的定向检索,整体上构建了一个兼具历史纵深与逻辑关联的法律知识库。
使用方法
使用OpenNormattiva数据集时,用户可直接加载JSONL文件进行逐条处理,适用于Python、R等数据分析环境,便于构建定制化的法律文本分析流水线。对于需要快速检索的场景,推荐利用预构建的SQLite数据库,其内置的FTS5全文检索引擎支持关键词搜索,PageRank算法可评估法律条款的重要性,而领域分类筛选则能缩小查询范围。此外,开发者可基于URN引用字段进行法律网络分析,挖掘法律间的互引模式,或结合修订信息研究法律演变动向,从而在法学研究、智能法律助手开发等领域发挥关键作用。
背景与挑战
背景概述
意大利法律体系庞大且繁杂,其立法文本的数字化与结构化处理一直是自然语言处理与法律人工智能领域的重要课题。OpenNormattiva数据集由意大利法律实验室(Italian Legal Lab)于近年创建,旨在将意大利官方法律数据库Normattiva中超过16万部法律条文转化为机器可读的结构化格式。该数据集不仅包含完整法律文本,还通过统一资源名称(URN)系统精确标注了法律间的引用关系与修正历史,并引入了领域分类标签。这一工作为法律信息检索、法律推理、文本生成及法律知识图谱构建等研究提供了关键数据基础,推动了意大利语法律领域的计算语言学发展。
当前挑战
该数据集主要面临的挑战包括:其一,领域问题的复杂性,即意大利法律文本具有高度结构化、多层级引用及频繁修正的特点,传统文本处理方法难以准确捕捉法律条文间的动态关联与语义网络;其二,构建过程中的技术难题,如从Normattiva平台大规模爬取法律文档时需应对反爬机制与数据异构性,同时将非结构化的法律文本转换为包含URN引用与修正追踪的标准JSON格式,需要复杂的解析与对齐算法;其三,数据质量保障,由于法律文本的严谨性,任何微小的标注错误都可能导致下游应用失效,因此对跨文档引用一致性及分类准确性的验证具有极高要求。
常用场景
经典使用场景
意大利法律数据集(Italian Legal Lab Data)汇聚了来自Normattiva平台的逾16万部意大利法律条文,涵盖完整全文、结构化URN引用、修正追踪及领域分类信息,成为法律自然语言处理研究的基石资源。其经典使用场景集中于法律信息检索、法律文本分类与法律知识图谱构建。研究者可借助该数据集训练法律专用语言模型、进行法律文本的语义相似度计算,或自动识别法律条文间的引用网络。该数据集以JSONL和预构建SQLite数据库形式提供,便捷支持大规模法律文本分析,为意大利法律AI研究奠定了数据基础。
解决学术问题
该数据集有效破解了意大利法律领域长期面临的数据稀疏与结构化不足的学术难题。在法律信息学研究中,缺乏大规模、高质量、带结构化标注的法律语料一直是制约法律文本自动推理、法律案例匹配及法规一致性检验等方向发展的瓶颈。OpenNormattiva数据集通过提供统一资源命名(URN)标识、跨文本引用链接与领域分类,使得法律引文网络分析、法律演变时序建模和多标签法律主题分类等前沿问题有了可靠的数据支撑,推动了计算法学和法律知识工程的实质性进步。
衍生相关工作
基于OpenNormattiva数据集,衍生了一系列引人瞩目的研究工作。学术社区利用其开展了意大利法律领域的语言模型预训练,如将法律文本与通用意大利语语料联合训练,产出针对法律领域的BERT变体模型。此外,研究者以该数据集为基准构建了法律文本分类的评测任务,推动法律文档自动归档与主题聚类算法的迭代。还有工作聚焦于法律引用网络的图神经网络建模,探索法律规则间的隐含关联与语义传播路径,这些衍生工作极大地促进了计算法学在意大利乃至欧洲法系下的本土化发展。
以上内容由遇见数据集搜集并总结生成


