
遇见数据集

kev-KOH/time-embed-bge-m3

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

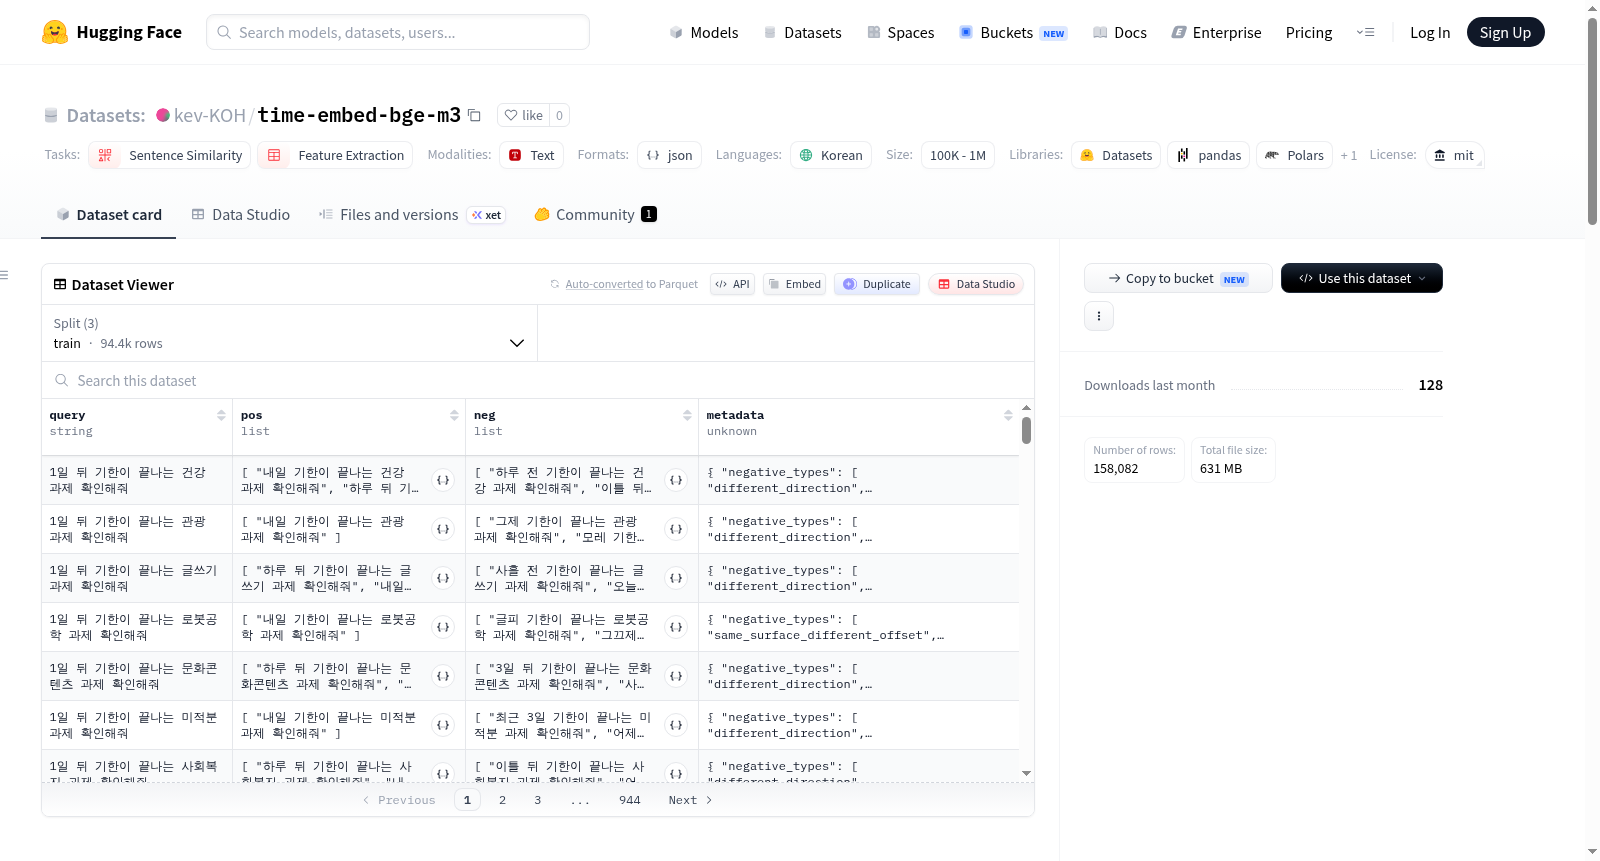
该数据集是用于FlagEmbedding/BGE-M3微调的韩语LMS时间查询数据集。目标是使语义上等价的韩语相对时间表达在嵌入空间中接近,同时区分看起来相似但时间不同的表达。数据集包含精心策划的LMS时间模板和确定性日历焦点层,用于处理硬案例,如精确持续时间偏移、日历周期、滚动窗口、相邻日历周期和条件重合边界。LLM生成的模板可能被用作提议,但除非通过意图特定的确定性验证,否则不会作为最终训练数据。排除产生格式错误字符串的截止时间模板,例如重复的까지后缀。数据集格式为JSONL,每行包含查询语句、正例和负例。

This dataset is a FlagEmbedding/BGE-M3 fine-tuning dataset for Korean LMS temporal queries. The goal is to make semantically equivalent Korean relative time expressions close in embedding space while separating similar-looking but temporally different expressions. The root files now point to the v1.7 training dataset. v1.7 keeps the curated LMS temporal templates and adds a deterministic calendar-focus layer for hard cases such as exact duration offsets, calendar periods, rolling windows, adjacent calendar periods, and conditional coincidence boundaries. LLM-generated templates may be used as proposals, but they are not trusted as final training data unless they pass intent-specific deterministic validation. Deadline templates that create malformed strings such as duplicate `까지` suffixes are excluded.

提供机构:
kev-KOH
搜集汇总
数据集介绍
kev-KOH/time-embed-bge-m3 数据集图片
构建方式
该数据集专为韩语时序查询嵌入任务而设计,旨在微调FlagEmbedding/BGE-M3模型。构建过程以v1.7版本的日历聚焦层为核心,在保留精选LMS时序模板的基础上,引入确定性规则来处理精确持续时间偏移、日历周期、滚动窗口、相邻日历周期及条件重合边界等硬性案例。数据源自LLM生成的模板,但仅通过意图特定的确定性验证后才会被采纳为最终训练样本,有效排除了包含重复‘까지’后缀等畸形字符串的截止日期模板。所有源数据经校验后转换为FlagEmbedding检索训练格式,最终形成涵盖15.8万条样本的数据集,分别存储于训练、验证与测试集中。
特点
该数据集的核心特点在于对韩语相对时间表达语义等价性的精准建模,通过精心构造的正例与硬负例,使嵌入空间中语义相近的时间表述彼此接近,而看似相似但实际时间指向不同的表述则相互分离。数据处理过程中引入了日历粒度的精细划分,涵盖年、月、周三个维度的对比,如日历周与持续时间、滚动窗口等六种聚焦桶。同时,质量审核机制剔除了带有翻译腔的不自然表达以及模糊时间标签,确保训练数据的高纯度与领域专一性。
使用方法
该数据集专用于微调BAAI/bge-m3模型,推荐使用FlagEmbedding库中encoder_only.m3的微调入口。用户可将数据集与配套代码仓库结合,一键启动训练脚本。数据以JSONL格式提供,每条记录包含查询语句、正例与负例,可直接适配FlagEmbedding的检索训练流程。建议使用默认配置文件加载数据,按训练、验证与测试拆分进行模型调优,以提升韩语时间查询嵌入效果。
背景与挑战
背景概述
在自然语言处理领域,时间语义理解对信息检索和问答系统至关重要,尤其是在韩语等资源稀缺语言中,时间表达式的嵌入对齐面临独特挑战。该数据集由研究团队于2024年发布,旨在通过微调BAAI/bge-m3模型,提升韩语时间查询的语义嵌入质量。其核心研究问题集中于如何将语义等价的相对时间表达式(如“일주일 전”与“7일 전”)在嵌入空间中紧密排列,同时区分形式相似但时间含义不同的表达式(如“일주일 전”与“지난주”)。该数据集以日历聚焦策略为核心,覆盖年度、月度、周度等粒度,并引入确定性验证机制过滤错误生成,对韩语时间理解与检索任务具有重要推动作用。
当前挑战
该数据集需解决的领域挑战在于韩语时间表达式的高度歧义性,例如“最近7天”与“7天前”在语义上的细微差异,以及相对时间与绝对日历周期(如“去年”与“一年前”)之间的边界混淆。构建过程中面临两大挑战:一是生成高质量反例样本,需通过日历聚焦方法人工设计硬负例(如“지난달” vs “한 달 전”),而非依赖LLM生成的未经验证模板;二是严格的质量控制,需排除结构错误的字符串(如重复“까지”后缀)及翻译腔表达(如“기준으로”),确保训练数据的纯净性与指令一致性。
常用场景
经典使用场景
在自然语言处理领域,时间语义理解一直是语义匹配与表示学习中的核心挑战。该数据集专为韩语环境下基于BGE-M3模型的时序查询嵌入微调而设计,其经典使用场景在于通过构造正负样本对,使语义等价的韩语相对时间表达(如‘일주일 전’与‘7일 전’)在嵌入空间中彼此靠近,同时将形似但实际时序含义不同的表达(如‘일주일 전’与‘지난주’)分离。这一任务聚焦于时间实体消歧与细粒度语义边界界定,为提升检索系统对时间敏感查询的鲁棒性提供了精准的训练数据支撑。
解决学术问题
该数据集直面语义匹配领域中时间表达模糊性与歧义性这一长期困扰学术界的难题。通过引入日历焦点确定性验证机制,系统解决了诸如精确持续时间偏移、日历周期、滚动窗口及重合边界等硬性案例的嵌入学习问题。其意义在于突破了传统语义嵌入模型对时间相对性理解不足的瓶颈,为韩语时序查询纠偏提供了可复现的评估基准,显著推动了时间感知语义匹配与跨语言时间推理的研究进展,对学术圈构建更细腻的时间认知模型具有启发性影响。
衍生相关工作
该数据集衍生了一系列关于时间感知嵌入表示的经典工作,尤其是在FlagEmbedding框架下对BGE-M3模型进行精细调优的实践。相关工作包括利用确定性日历焦点层增强硬负样本筛选策略的时序嵌入方法,以及针对韩语LMS时间模板的生成式验证与质量控制体系。这些工作进一步催生了跨日历粒度的时序推理研究,如年、月、周维度的量化边界对齐,以及条件重合边界的嵌入学习。此外,基于该数据集的微调管线已被用于探索多语言时间表达的统一表示,为后续构建更通用的时间语义理解模型奠定了数据与方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

