
遇见数据集

booru_tag_and_artist_20241208

收藏
Hugging Face2024-12-10 更新2024-12-12 收录
官方服务:

资源简介:

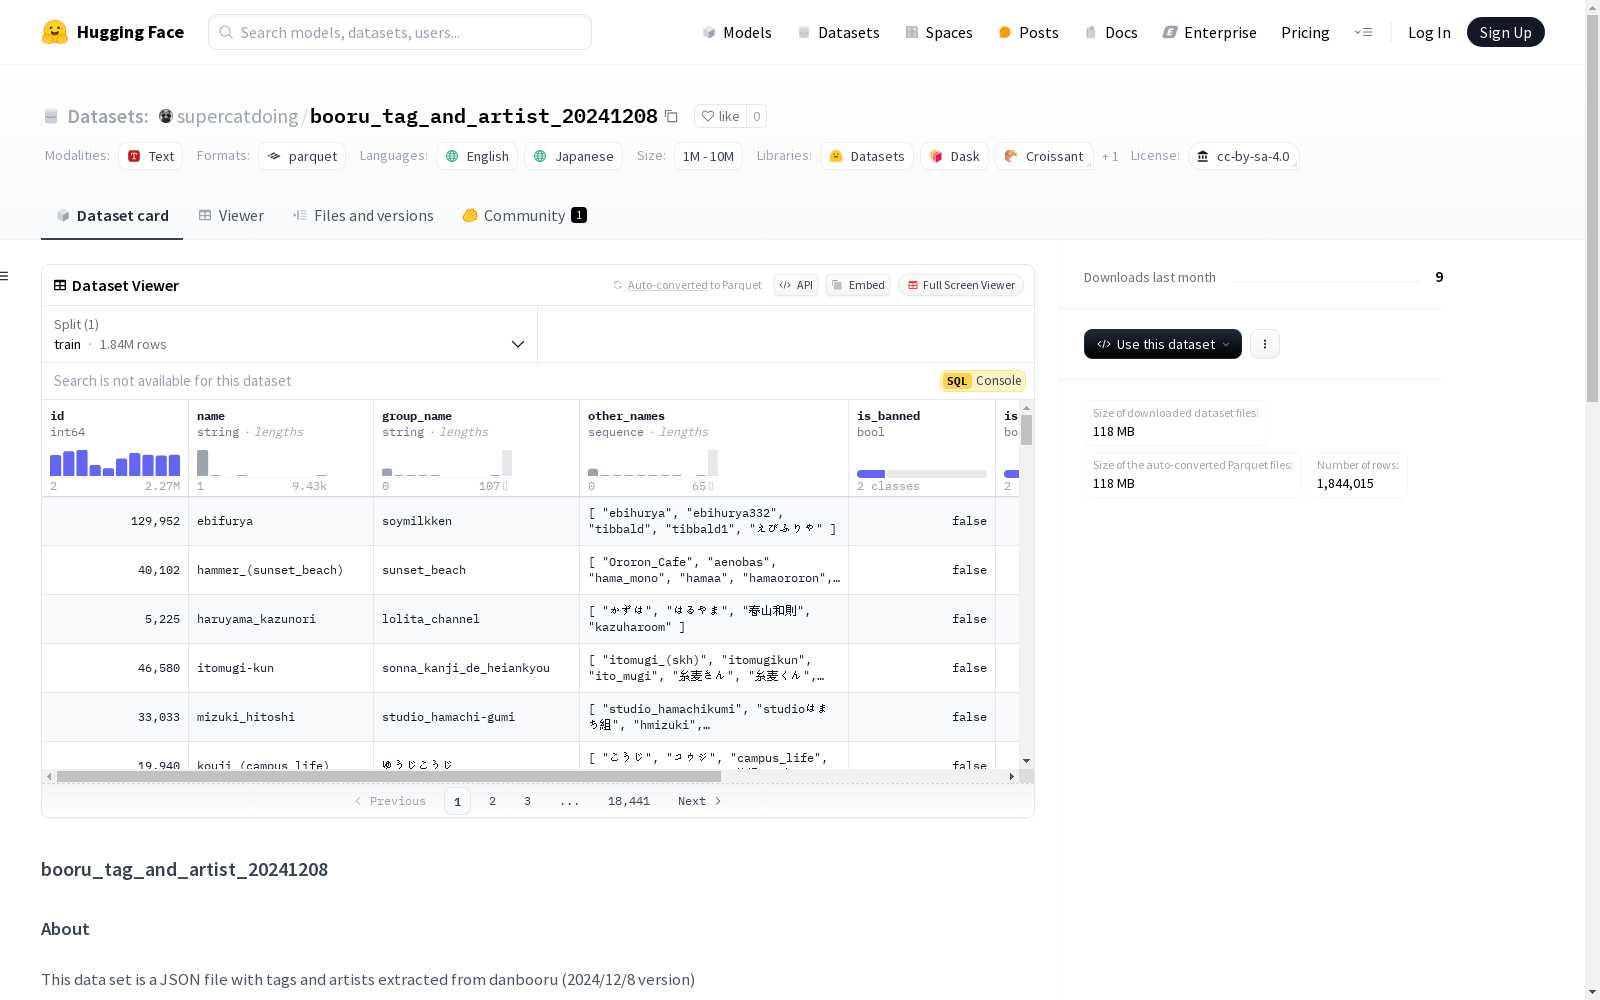
该数据集是一个JSON文件,包含从danbooru提取的标签和艺术家信息(2024/12/8版本)。所有数据按标签计数预先排序。还提供了一个JSONL文件,以便在Apache允许Parquet文件的环境中使用。请在本地处理数据(如创建CSV文件)时参考此数据集。该文件基于danbooru API创建。

This dataset is a JSON file containing tags and artist information extracted from Danbooru (version as of December 8, 2024). All data is pre-sorted by tag count. A supplementary JSONL file is also provided for use in environments supporting Apache Parquet files. This dataset should be referenced when conducting local data processing, such as creating CSV files. It is built upon the Danbooru API.

创建时间:
2024-12-08
原始信息汇总

booru_tag_and_artist_20241208

关于

该数据集是一个从danbooru(2024/12/8版本)中提取的标签和艺术家的JSON文件。所有数据按标签计数预先排序。

还提供了一个JSONL文件,以便在Apache允许Parquet文件的环境中使用。请在本地处理数据(如创建CSV文件)时参考此文件。

该文件基于danbooru API创建。

文件描述

  • artists_cooked.jsonl: 包含一些处理过的艺术家信息。不应存在未列在标签中的艺术家。
  • artists.parquet: artists_cooked.jsonl的Parquet格式。
  • tags_booru_full.jsonl: 包含所有标签信息的文件。
  • tags_booru_full.parquet: tags_booru_full.jsonl的Parquet格式。
日语部分

该数据集是从danbooru中提取的标签和艺术家的Jsonl、parquet文件(2024/12/8版)。所有数据按标签计数预先排序。

为了在Apache允许Parquet文件的环境中使用,还提供了JSONL文件。请在本地处理数据(如创建CSV文件)时参考此文件。

该文件基于Danbooru的API创建。

文件描述

  • artists_cooked.jsonl: 包含一些处理过的艺术家信息。不应存在未列在标签中的艺术家。
  • artists.parquet: artists_cooked.jsonl的Parquet格式。
  • tags_booru_full.jsonl: 包含所有标签信息的文件。
  • tags_booru_full.parquet: tags_booru_full.jsonl的Parquet格式。
搜集汇总
数据集介绍
booru_tag_and_artist_20241208 数据集图片
构建方式
该数据集名为booru_tag_and_artist_20241208,其构建基于danbooru平台的API,提取了2024年12月8日的标签和艺术家信息。数据集中的所有信息均按标签数量进行了预先排序,并提供了JSONL和Parquet两种格式的文件,以便在不同环境下使用。艺术家信息经过部分处理,确保与标签信息的一致性。
特点
该数据集的主要特点在于其内容的全面性和格式的多样性。所有数据按标签数量排序,便于用户快速定位高频标签。此外,数据集提供了JSONL和Parquet两种格式,适应不同环境的需求,尤其是在Apache允许的环境中,Parquet格式更为适用。
使用方法
用户可以通过加载JSONL或Parquet文件来使用该数据集,特别适用于需要处理大量标签和艺术家信息的研究或应用场景。数据集可用于本地数据处理,如创建CSV文件,或作为参考数据集用于机器学习模型的训练和验证。
背景与挑战
背景概述
booru_tag_and_artist_20241208数据集是由Danbooru平台上的标签和艺术家信息提取并整理而成的,创建于2024年12月8日。该数据集的核心研究问题是如何高效地组织和利用动漫文化中的标签和艺术家信息,以支持数据处理和分析任务。通过利用Danbooru的API,研究人员能够获取并预处理这些数据,使其适用于多种数据格式,如JSONL和Parquet,从而为动漫文化研究、图像识别和数据挖掘等领域提供了重要的资源。
当前挑战
该数据集在构建过程中面临的主要挑战包括:首先,从Danbooru平台提取大量标签和艺术家信息时,如何确保数据的完整性和准确性是一个关键问题。其次,将这些数据转换为多种格式(如JSONL和Parquet)以适应不同的使用环境,增加了数据处理的复杂性。此外,由于动漫文化中的标签和艺术家信息具有高度的多样性和动态变化,如何保持数据的实时性和更新频率也是一个重要的挑战。
常用场景
经典使用场景
booru_tag_and_artist_20241208数据集的经典使用场景主要体现在动漫和二次元文化领域。该数据集通过提取danbooru平台上的标签和艺术家信息,为研究者提供了丰富的元数据资源。这些数据可以用于构建动漫图像的分类模型,分析特定艺术家的创作风格,或进行大规模的图像检索任务。此外,数据集的预排序特性使得在处理大规模数据时能够显著提升效率,特别适用于需要快速检索和分析标签信息的场景。
解决学术问题
该数据集解决了动漫和二次元文化研究中的多个学术问题。首先,它为研究者提供了详尽的标签和艺术家信息,有助于深入分析特定艺术风格或主题的流行趋势。其次,通过这些数据,研究者可以探索图像与标签之间的关联性,从而改进图像分类和检索算法。此外,该数据集还为跨文化研究提供了宝贵的资源,帮助学者理解不同文化背景下动漫作品的接受度和影响力。
衍生相关工作
基于booru_tag_and_artist_20241208数据集,衍生了许多经典的研究工作。例如,有研究者利用该数据集开发了高效的动漫图像分类算法,显著提升了分类精度。此外,还有学者基于这些数据进行了跨文化研究,分析了不同地区用户对动漫作品的偏好差异。在机器学习领域,该数据集也被用于训练深度学习模型,以实现更精准的图像识别和生成任务。这些衍生工作不仅丰富了动漫文化的研究,也为相关技术的发展提供了有力支持。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

