
TyNguyen/vi-culture-composite
收藏官方服务:
资源简介:
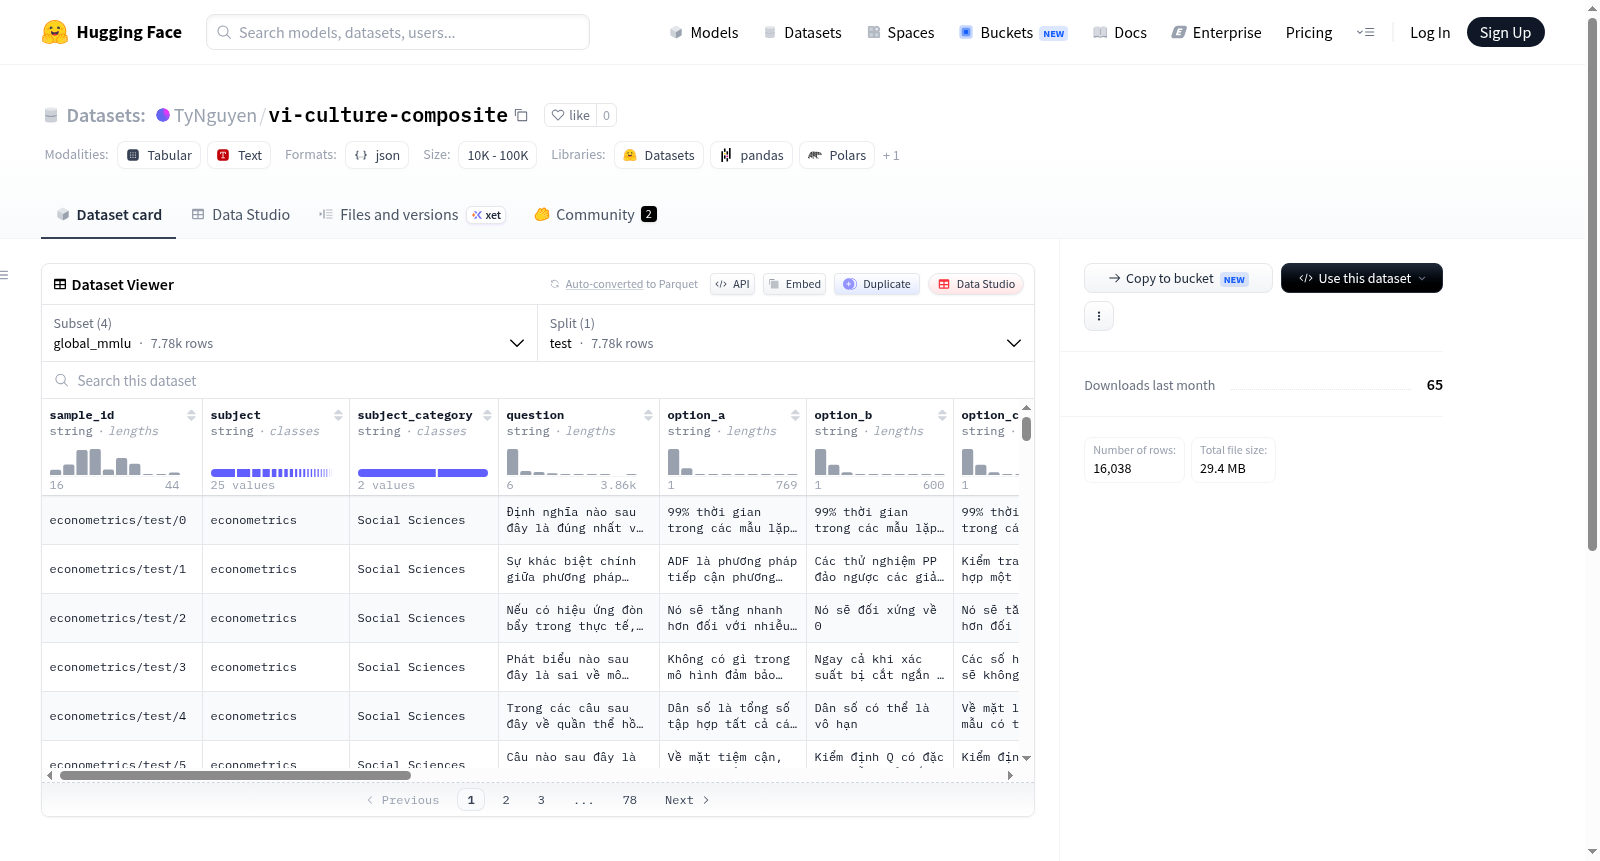
该数据集结合了四个越南语多语言QA基准,筛选了与文化相关的类别。包含四个子集:global_mmlu、mmlu_prox、vi_mqa和seaexam。
This dataset combines four Vietnamese multilingual QA benchmarks filtered for culturally related categories. Subsets include: global_mmlu, mmlu_prox, vi_mqa, and seaexam.
提供机构:
TyNguyen搜集汇总
数据集介绍
构建方式
该数据集通过整合四个越南语多语言问答基准测试中的文化相关类别子集构建而成。具体而言,从global_mmlu、mmlu_prox、vi_mqa和seaexam四个数据集中,依据文化主题类别进行筛选与合并,形成了统一的测试集合。每个子集均以JSON或JSONL格式存储,分别对应不同的问答任务与难度层级,确保数据在文化语境上的多样性与代表性。
使用方法
用户可通过HuggingFace的datasets库加载该数据集,支持按子集名称(如global_mmlu、seaexam)单独调用。每个子集均提供test划分,可直接用于模型评估。使用时需注意数据格式差异:global_mmlu与mmlu_prox为JSON格式,而vi_mqa为JSONL格式。推荐在越南文化问答、跨语言理解等任务中作为测试基准,以检验模型对越南及其周边文化知识的掌握程度。
背景与挑战
背景概述
随着越南在全球经济与文化交流中地位的日益凸显,针对其特定文化语境的语言智能评估需求愈发迫切。vi-culture-composite数据集正是在这一背景下应运而生,由致力于推动越南语自然语言处理研究的国际机构联合创建,数据集整合了global_mmlu、mmlu_prox、vi_mqa与seaexam四个多语言问答基准测试中涉及越南文化维度的子集,旨在系统评估模型对越南社会、历史、习俗与价值观等深层文化知识的理解能力。该核心研究问题的确立,填补了现有多语言评估体系缺失地域文化细腻度的空白,对于促进低资源语言文化感知技术的发展具有里程碑意义。通过构筑这一高针对性的复合基准,数据集为跨文化人工智能研究提供了独特的评测基石,其影响力已辐射至东南亚自然语言处理及其文化计算相关领域。
当前挑战
该数据集所应对的核心领域挑战在于,现有主流问答评测基准普遍忽视文化特异性,导致模型在非英语、非西方语境下表现失真,尤其难以精准衡量其理解越南本土文化内涵的广度与深度。在构建过程中,团队面临多重困难:首先,需从四个庞大多语言数据集中精确筛选出反映越南文化特质的类别实例,这一过程对分类粒度的把控与方言差异的识别提出了极高要求。其次,不同子集采用的数据格式各异,包括JSON与JSONL,结构化一致性整合无疑增添了数据清洗与对齐的技术复杂度。最后,确保各子集在文化覆盖面上的平衡性与代表性,避免引入地域或时间偏倚,亦是构建过程中不容忽视的系统性挑战。
常用场景
经典使用场景
在自然语言处理与跨文化理解的研究领域中,vi-culture-composite数据集以其对越南语文化知识的深度整合而独树一帜。该数据集汇聚了global_mmlu、mmlu_prox、vi_mqa及seaexam四个子集,专门筛选出与越南文化密切相关的问答对,为评估和提升模型在越南语语境下的文化理解能力提供了精准的测试平台。经典使用场景包括对多语言预训练模型进行文化适配性测试,通过针对越南历史、习俗、社会规范等文化范畴的问答任务,揭示模型在非英语文化背景下的知识迁移与推理表现。研究者常以此数据集为基准,衡量不同语言模型对越南独特文化概念的掌握程度,从而推动多语言AI系统在文化敏感性上的进步。
解决学术问题
vi-culture-composite数据集的核心学术价值在于解决跨文化问答系统中文化偏见与知识盲区这一关键问题。现有的大型语言模型多基于英语及西方文化语料训练,导致在越南等非西方文化语境中表现欠佳,甚至产生文化误解。该数据集通过系统性地筛选文化相关问答,使研究者能够量化模型对越南特有文化知识(如传统节日、地方民俗、历史人物)的认知水平。其意义在于为文化人工智能领域提供了首个专门针对越南文化的复合型评估基准,推动了多语言模型从通用知识向文化特定知识的纵深研究,为构建更公平、更具文化包容性的AI系统奠定了方法论基础。
实际应用
在实际应用中,vi-culture-composite数据集助力于开发面向越南市场的本土化AI服务。例如,在智能客服系统中,模型需准确理解越南用户关于传统礼仪、节日问候或本地产品使用的询问;在教育领域,该数据集可用于训练能够解析越南历史教材或民间故事的文化助教。此外,旅游翻译软件可通过该数据集优化对越南古迹解说、地方美食描述等文化专有项的翻译质量。企业可基于此数据集评估其NLP产品在越南文化场景下的表现,确保AI助手、内容推荐系统等应用既具备语言能力,又能避免文化冒犯,从而提升用户体验与市场接受度。
数据集最近研究
最新研究方向
vi-culture-composite数据集聚焦于越南语多语言问答基准中与文化相关的子集整合,为评估大语言模型在越南文化语境下的理解与推理能力提供了专项测试资源。当前前沿研究方向包括:利用该数据集检验模型对越南本土习俗、历史及社会规范的掌握程度,探索其在低资源语言文化适应性中的表现;结合东南亚跨文化对比,评估模型处理区域特有知识时的鲁棒性;该数据集的构建也推动了多语言模型在文化敏感任务中的性能优化,对促进人工智能在全球化背景下的文化包容性具有重要意义。
以上内容由遇见数据集搜集并总结生成


