
遇见数据集

winogrande-multilingual

收藏
Hugging Face2026-03-09 更新2026-03-10 收录
官方服务:

资源简介:

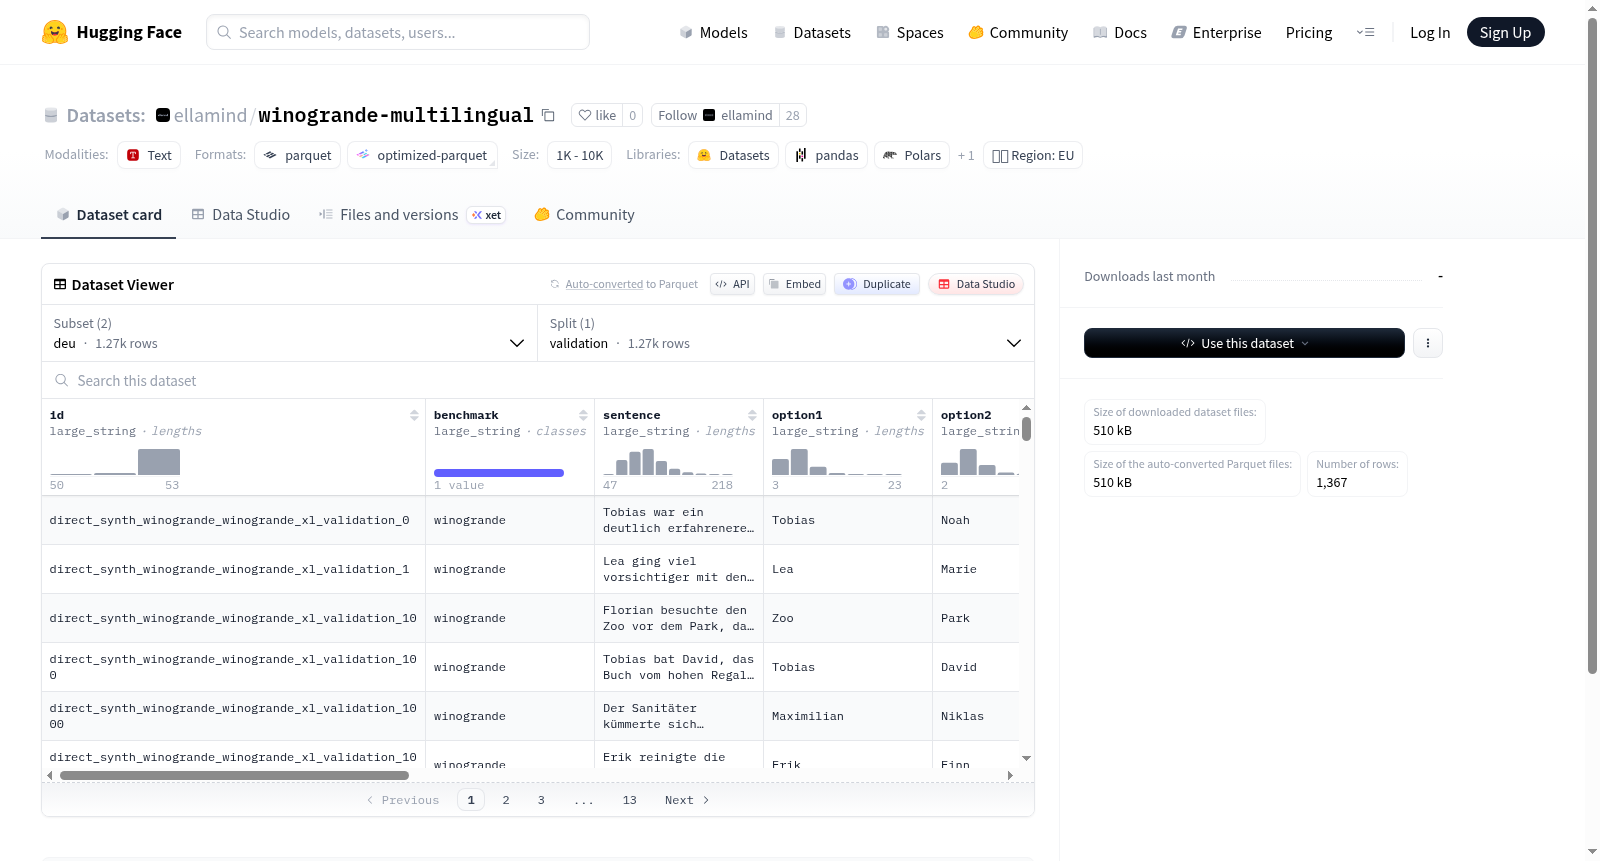
该数据集包含德语(deu)和法语(fra)两种配置的验证集,用于多选问答任务。每个样本包含13个字段:唯一标识符(id)、基准名称(benchmark)、问题句子(sentence)、两个选项(option1/option2)、正确答案(answer)、错误选项缺陷描述(wrong_option_flaw)、种子ID(seed_id)、主题描述(topic_description)、推理类型(reasoning_type)、综合注释(synthesis_notes)、审核标记(flag_for_review)和审核原因(review_reason)。德语配置包含1,267个样本(1.02MB),法语配置包含100个样本(88.8KB)。数据格式为字符串(large_string)和布尔值(bool),特别包含对错误选项的逻辑缺陷分析和多种推理类型的标注,适用于问答系统评估和推理能力研究。

This dataset includes two validation set configurations for German (deu) and French (fra) languages, targeting multiple-choice question answering tasks. Each sample comprises 13 fields: unique identifier (id), benchmark name (benchmark), question sentence (sentence), two options (option1/option2), correct answer (answer), wrong option flaw description (wrong_option_flaw), seed ID (seed_id), topic description (topic_description), reasoning type (reasoning_type), synthesis notes (synthesis_notes), review flag (flag_for_review), and review reason (review_reason). The German configuration consists of 1,267 samples (1.02 MB), while the French configuration contains 100 samples (88.8 KB). The data formats include string (large_string) and boolean (bool). Specifically, the dataset features logical flaw analyses for incorrect options and annotations for diverse reasoning types, making it suitable for question answering system evaluation and reasoning capability research.
提供机构:
ellamind
创建时间:
2026-03-09
搜集汇总
数据集介绍
winogrande-multilingual 数据集图片
构建方式
在自然语言推理领域,多语言数据集对于评估模型的跨语言理解能力至关重要。Winogrande-multilingual数据集的构建采用了严谨的翻译与本地化策略,以英语原版Winogrande为基础,通过专业翻译与人工审核流程,生成了德语和法语版本。每个样本均包含一个含有空缺的句子及两个候选填充选项,要求模型基于常识推理选择正确项。构建过程中保留了原始数据集的推理类型与主题描述等元信息,并引入了错误选项缺陷标注,确保了多语言语境下的语义一致性与逻辑完整性。
特点
该数据集显著特点在于其多语言覆盖与精细的标注体系。除了提供德语和法语两种语言的验证集外,每个样本均附有详细的元数据,包括主题描述、推理类型以及错误选项的具体缺陷分析。这种设计不仅支持模型在多语言常识推理任务上的评估,还为研究者提供了深入分析模型失败原因的线索。数据集中样本经过人工审核标记,确保了高质量与可靠性,适用于跨语言迁移学习与推理机制的可解释性研究。
使用方法
使用Winogrande-multilingual数据集时,研究者可通过HuggingFace数据集库直接加载德语或法语配置,获取验证集进行模型评估。每个样本以结构化字段呈现,包括句子、选项、答案及丰富的元数据,便于构建填空式常识推理任务。该数据集适用于多语言语言模型的零样本或微调评估,通过比较模型在不同语言上的表现,可深入探究其跨语言泛化能力与推理一致性。同时,错误选项缺陷标注支持细粒度错误分析,推动推理模型的可解释性研究。
背景与挑战
背景概述
Winogrande-multilingual数据集是自然语言处理领域针对常识推理任务的重要资源,由研究团队于近年构建,旨在扩展原始Winogrande英语基准至多语言环境。该数据集聚焦于解决代词消歧问题,通过设计包含两个候选选项的填空题,评估模型在多种语言中对常识知识的理解与推理能力。其创建推动了跨语言语义理解研究,为多语言预训练模型提供了关键的评估基准,对提升人工智能系统的语言普适性具有显著影响。
当前挑战
该数据集致力于应对多语言常识推理的挑战,核心问题在于模型需克服语言差异与文化背景的复杂性,准确解析代词所指实体。构建过程中,挑战主要体现在高质量多语言数据的采集与标注上,包括确保不同语言版本在语义和逻辑上的一致性,以及处理低资源语言的数据稀疏性问题。此外,维持推理类型的多样性与避免标注偏差也是构建阶段的关键难点。
常用场景
经典使用场景
在自然语言处理领域,多语言常识推理是评估模型跨语言理解能力的关键任务。winogrande-multilingual数据集通过提供德语和法语版本的填空式选择题,为研究者构建了一个标准化的测试平台。该数据集常用于训练和评估多语言预训练模型,如mBERT或XLM-R,以检验模型在捕捉语言间细微语义差异和常识推理方面的性能。其典型应用场景包括模型在零样本或少样本设置下的跨语言迁移学习实验,帮助揭示模型是否真正掌握了超越表层翻译的深层语义知识。
衍生相关工作
围绕winogrande-multilingual数据集,衍生出了一系列经典研究工作,这些工作主要聚焦于多语言模型的鲁棒性和可解释性。例如,有研究利用该数据集分析了预训练模型在德语和法语上的推理错误模式,提出了针对性的数据增强策略。另一项工作则结合该数据集探索了跨语言对抗训练方法,以提升模型在低资源语言上的性能。这些研究不仅推动了多语言自然语言处理技术的发展,还为构建更公平、包容的人工智能系统奠定了数据基础。
数据集最近研究
最新研究方向
在自然语言处理领域,常识推理作为衡量模型智能水平的关键维度,一直备受关注。winogrande-multilingual数据集作为多语言常识推理基准,其最新研究聚焦于跨语言迁移学习与模型泛化能力的深度探索。研究者们利用该数据集中的德语和法语等语言配置,系统分析多语言大模型在复杂推理任务中的表现差异,揭示语言特定结构对常识理解的影响机制。当前热点事件如多模态人工智能的兴起,进一步推动了结合视觉与文本信息的跨语言推理研究,旨在构建更鲁棒、更公平的全球性AI系统。这些工作不仅深化了对语言与文化多样性背景下常识表征的理解,也为开发更具包容性的人工智能应用奠定了坚实的数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

