
chairulridjal/high-accuracy-email-classifier-indonesian
收藏数据链接:
官方服务:
资源简介:
该数据集是原始高精度邮件分类数据集的印尼语翻译/适配版本,专门用于文本分类任务,特别是邮件分类,包括垃圾邮件检测。它包含印尼语翻译的邮件主题、正文和合并文本,同时保留了原始数据集的类别标签和ID。数据集适用于自然语言处理中的分类应用,支持印尼语文本分析。
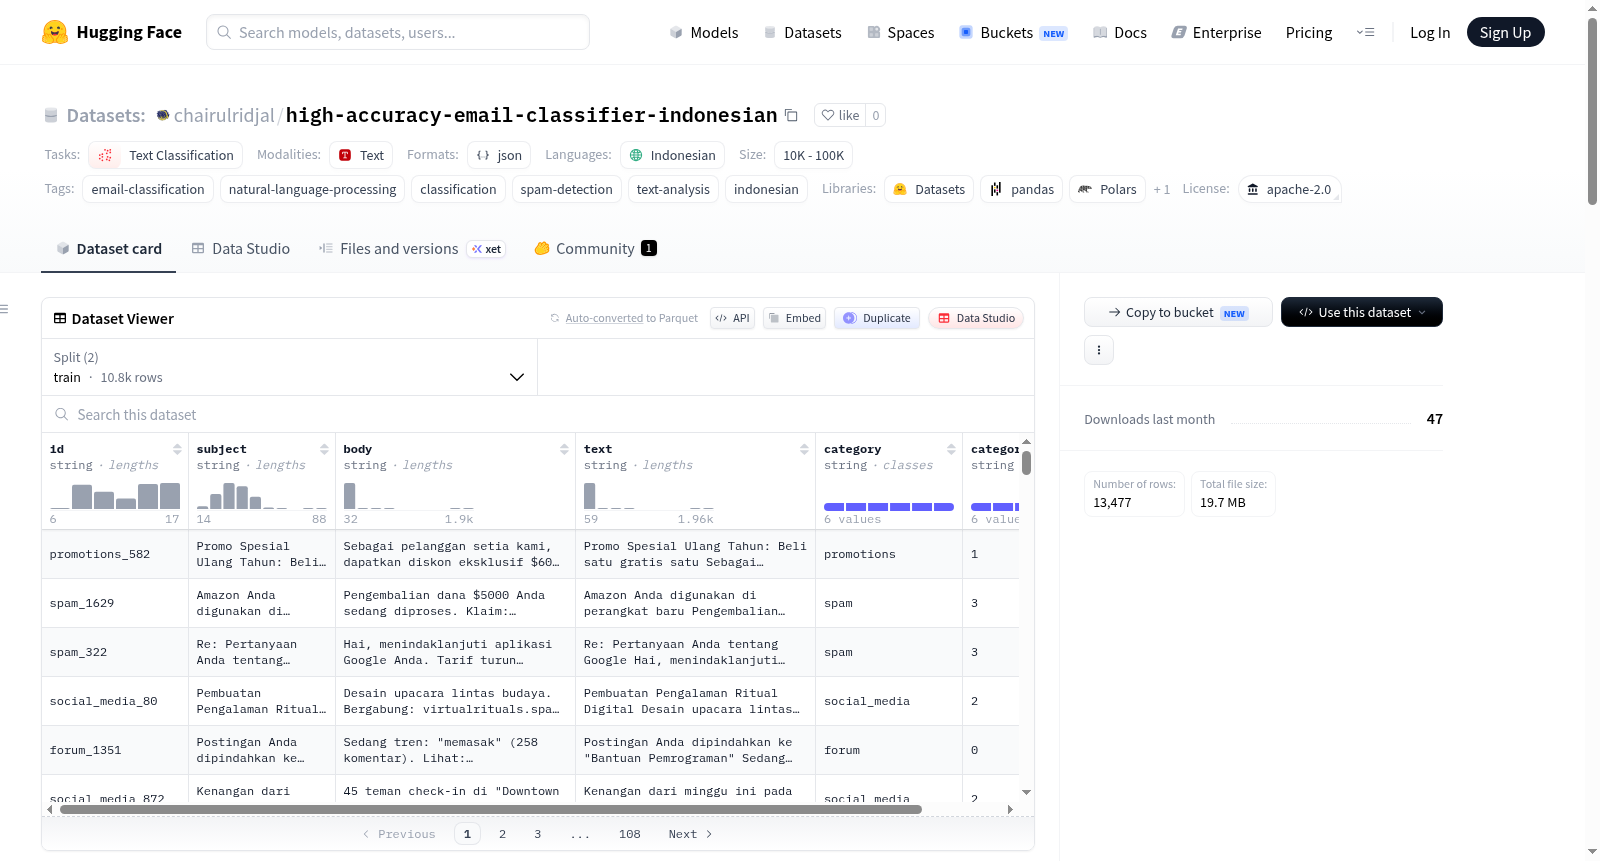
This dataset is an Indonesian translation/adaptation of the original high-accuracy email classification dataset, designed for text classification tasks, particularly email classification including spam detection. It includes Indonesian translations of email subjects, bodies, and combined text, while preserving the original category labels and IDs. The dataset is suitable for natural language processing classification applications, supporting Indonesian text analysis.
提供机构:
chairulridjal搜集汇总
数据集介绍
构建方式
该数据集是对英文原版高精度邮件分类数据集的印尼语翻译与适配版本。构建流程分为两步:首先保留原始数据集中每个样本的唯一标识符、类别标签及类别编号,然后利用GPT-5.4-mini模型将邮件主题与正文翻译为印尼语,并遵循一致性检查原则重新拼接为完整的文本字段。训练集与测试集的划分亦完全继承自源数据集,确保跨语言版本间的可比性。
特点
数据集涵盖六类印尼语邮件文本,包括论坛讨论、促销推广、社交媒体通知、垃圾邮件、系统更新及验证码,类别覆盖全面而清晰。数据规模介于1万至10万条之间,呈中等体量,足以支撑下游分类任务的训练与评估。每一条记录均同时提供主题、正文及拼接文本三种格式,便于不同预处理需求的用户灵活选用。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,仅需一行Python代码即可获得训练与测试子集。亦支持以pandas读取CSV或JSON格式的本地文件进行离线操作。数据集遵循Apache 2.0开源协议,允许自由使用与再分发,建议在出版物中引用原始数据作者及印尼语贡献者的bibtex条目以示尊重。
背景与挑战
背景概述
在自然语言处理领域,电子邮件分类任务因涉及垃圾邮件检测、意图识别及多类别文本分析而备受关注。然而,针对印度尼西亚语的电子邮件分类数据集长期匮乏,制约了该语种相关模型的性能提升。为此,Mochamad Chairulridjal于2026年基于jason23322团队构建的原始高精度英文电子邮件分类数据集,通过机器翻译与人工校验相结合的方式,推出了印度尼西亚语版本。该数据集包含约数万条标注样本,涵盖论坛、促销、社交媒体、垃圾邮件、系统更新及验证码共六大类别,为印尼语文本分类任务提供了标准化的训练与评测资源。其核心研究问题在于验证跨语言迁移与本地化翻译在低资源场景下的有效性,并对印尼语自然语言处理社区产生了积极的推动作用。
当前挑战
该数据集所应对的领域挑战在于印度尼西亚语电子邮件分类任务的稀缺性,尤其是针对多类别精细分类(如区分论坛通知与营销广告)的标注数据极度匮乏。构建过程中面临的挑战包括:原始英文数据集依赖特定文化语境,直接翻译可能导致语义偏差或类别歧义;使用GPT-5.4-mini等模型进行机器翻译时,需确保术语一致性并避免丢失类别信息,例如‘spam’与‘verify_code’等标签的准确传达;此外,翻译后的文本需保持主题与正文的结构对齐,并验证行数、标签映射及数据划分的完整性,以保证数据集的可复现性与下游应用效果。
常用场景
经典使用场景
在印尼语自然语言处理领域,电子邮件文本分类是信息过滤与组织的基础任务。该数据集提供了涵盖论坛讨论、促销资讯、社交媒体通知、垃圾邮件、系统更新及验证码等六类印尼语电子邮件样本,每一条记录均包含翻译后的主题与正文内容。研究者可借此构建端到端的文本分类模型,例如采用预训练多语言模型进行微调,实现对印尼语电子邮件类别的精准判别。经典使用范式是将'text'字段作为输入特征,'category'或'category_id'作为监督标签,在给定的训练-测试划分下进行有监督学习,以验证模型对多类别语义差异的捕捉能力。
实际应用
在实际应用领域,该数据集可直接用于开发面向印尼语用户的智能邮件管理系统。企业可基于此训练垃圾邮件过滤器,自动拦截钓鱼与欺诈邮件,降低网络安全风险;电商平台能够通过促销类别识别实现精准营销,提升用户触达率;社交媒体应用则能借此自动归类来自平台的通知,优化用户体验。此外,验证码类别的区分有助于辅助身份验证系统的异常检测,增强账户安全。该数据集的类别设计贴合真实业务场景,使得从学术实验到工业部署的转化路径尤为顺畅。
衍生相关工作
基于该数据集,研究者可衍生出一系列深度挖掘工作:例如,利用零样本或小样本学习框架探索类别扩展的可能性,验证模型对未见过类别的泛化能力;亦可结合多任务学习范式,将邮件分类与情感分析、意图识别联合建模,提升语义理解的精细度。在跨语言迁移领域,该印尼语版本与原始英语版本构成了天然的平行语料对,为评估模型在翻译噪声下的鲁棒性提供了实验基础。此外,针对数据集中于主体与正文拼接后的文本结构,可开展基于段落级别注意力的文档分类研究,推动对长文本结构表征的深入探索。
以上内容由遇见数据集搜集并总结生成


