
遇见数据集

SINAI/ALIA-es-clinical-psychology-dialogues

收藏
Hugging Face2026-06-30 更新2026-07-22 收录
官方服务:

资源简介:

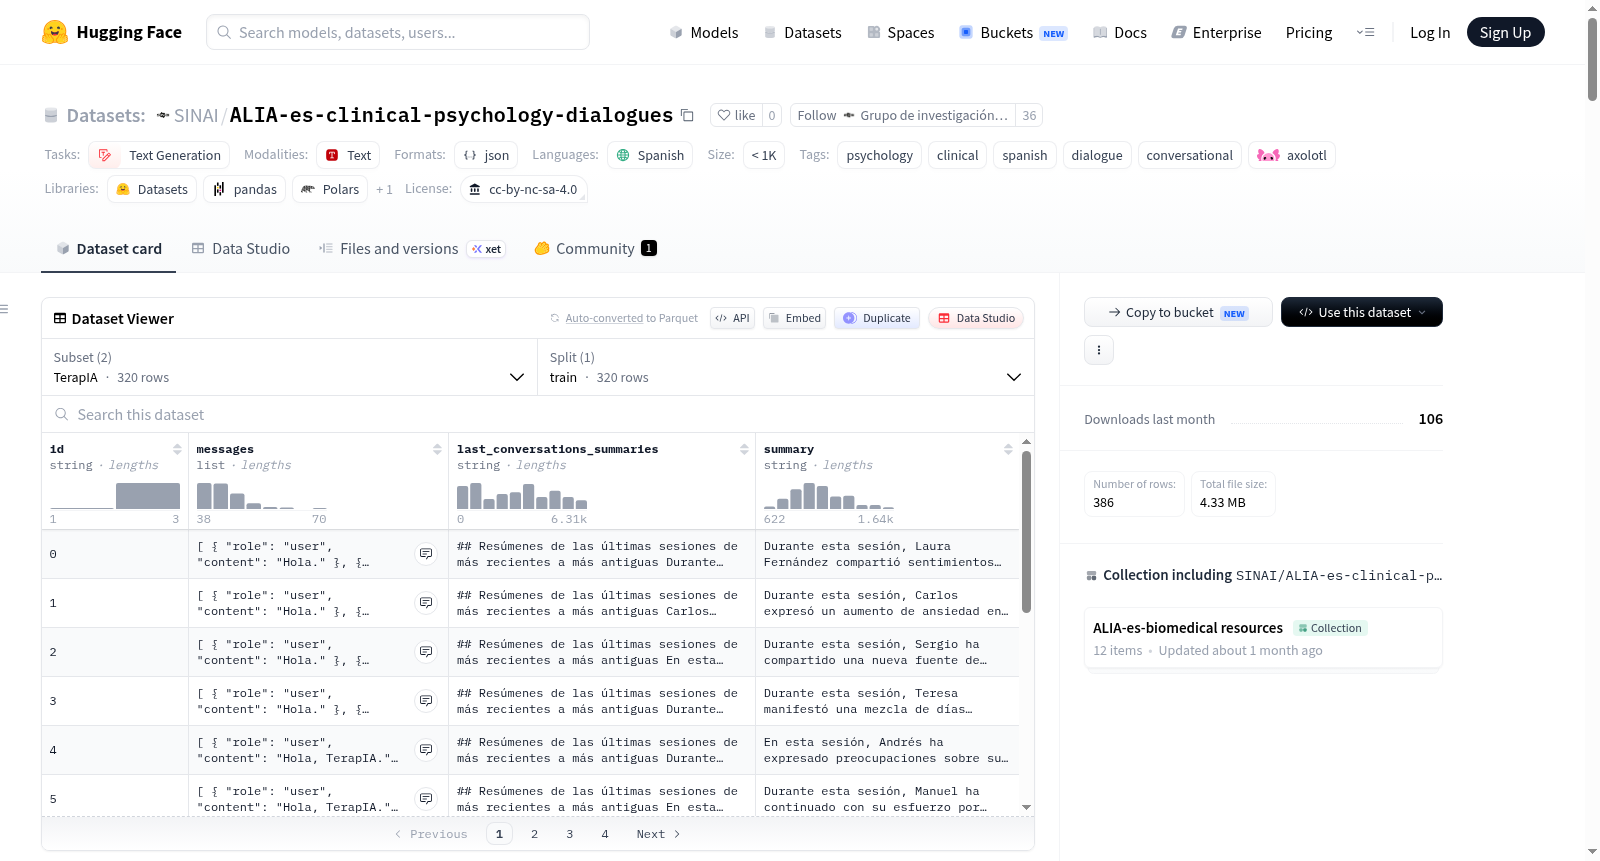
ALIA西班牙临床心理学对话语料库是一个在ALIA项目下创建的西班牙语对话指令调优资源,旨在训练和评估语言模型在共情治疗对话和心理咨询方面的能力。该数据集包含两个子集:1) clinic-roleplay(大学心理学诊所):包含66个多轮临床对话,由大学心理健康专业人员通过角色扮演开发;2) TerapIA(TerapIA应用对话):包含320个匿名真实世界多轮对话交互,来自用户与TerapIA应用中数字AI助手Pía的互动。这些对话覆盖了典型的心理和情感问题(如焦虑、压力、人际关系问题、自尊、抑郁),并展示了共情、积极倾听和临床指导策略。数据集用于西班牙语心理咨询和积极倾听的对话LLM监督微调、共情沟通研究以及临床对话策略评估。

The ALIA Spanish Clinical Psychology Dialogues Corpus is a curated conversational instruction-tuning resource in Spanish created under the ALIA project. It was designed to train and evaluate language models in empathetic therapeutic dialogue and psychological counseling. This dataset consists of two distinct subsets (configurations): 1) clinic-roleplay (University Psychology Clinic): 66 multi-turn clinical dialogues developed through roleplay by mental health professionals at the University. 2) TerapIA (TerapIA App Conversations): 320 anonymized real-world multi-turn conversational interactions between users and the digital AI assistant Pía in the TerapIA application. The dialogues cover typical psychological and emotional concerns (e.g., anxiety, stress, relationship issues, self-esteem, depression) and showcase empathetic, active-listening guidance and clinical strategies. It is intended for Supervised Fine-Tuning (SFT) of conversational LLMs for psychological counseling in Spanish, research in empathetic communication, and evaluation of clinical dialogue capabilities.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-clinical-psychology-dialogues 数据集图片
构建方式
ALIA西班牙语临床心理学对话语料库的构建融合了两种截然不同的数据来源。其一为“clinic-roleplay”子集,由大学心理学诊所的心理健康专业人员通过角色扮演,模拟患者与治疗师之间的多轮互动,并精心设计了系统提示以确立治疗情境,最终生成66段高质量的临床对话。其二为“TerapIA”子集,源自TerapIA应用程序中用户与数字助理Pía的真实匿名对话,收集时间跨度为2024年11月至2025年5月,提取了320段完整的交互历史及会话临床摘要。两种数据均经过严格的匿名化处理,并整理为符合Axolotl等框架指令微调格式的JSONL文件。
使用方法
研究人员可便捷地利用HuggingFace Datasets库加载该语料库,通过指定不同的数据文件路径来分别获取两个子集。建议将数据集应用于西班牙语对话式大语言模型的监督微调(SFT),特别是针对心理咨询与积极倾听场景。模型在训练时可优先学习“clinic-roleplay”中的专业治疗性回话模式,再结合“TerapIA”中的真实会话多样性进行泛化。研究者亦可利用该数据集验证模型在移情交流与安全临床引导方面的表现,但需严格遵循其非临床验证的科研用途定位,避免将其视为诊断或临床决策替代品。
背景与挑战
背景概述
ALIA-es-clinical-psychology-dialogues是由西班牙ALIA项目资助、SINAI研究小组与Inteligencia Artificial Generativa y Procesamiento de Lenguaje Natural, S.L.机构联合创建的西班牙语临床心理学对话语料库,发布于2026年。该数据集旨在为西班牙语环境下的共情式治疗对话与心理辅导提供高质量的指令微调资源,核心研究问题聚焦于如何使语言模型在心理支持场景中展现真实的共情、主动倾听与情感验证,而非生成泛化的AI建议。数据集包含由心理健康专业人员角色扮演的66个临床对话(clinic-roleplay子集)以及来自TerapIA应用中真实用户与数字助手Pía的320段匿名化交互(TerapIA子集),覆盖焦虑、压力、人际关系、自尊与抑郁等典型心理困扰。作为ALIA项目的重要组成部分,该数据集为西班牙语心理对话系统的监督微调与评估提供了基准数据,推动了自然语言处理在心理健康领域的跨语言应用。
当前挑战
该数据集所解决的领域问题核心在于克服西班牙语心理支持场景中缺乏高质量、专业化对话数据的困境,以往模型往往生成干瘪的通用建议,难以模拟治疗师所具备的共情、情感验证与认知重构等复杂策略。构建过程中面临多重挑战:首先是数据来源的差异使得角色扮演对话与真实用户交互在风格、结构和隐私处理上需要分别设计标准化流程;其次,TerapIA子集需在确保用户隐私安全的前提下对对话进行去标识化处理,并提取临床摘要与历史会话摘要作为上下文信息,这对匿名化流水线的精度提出了严苛要求;此外,两子集的对话轮次深度不一(平均30至44轮),需保持语料中治疗策略的一致性与专业性,避免因模板化导致风格同质化,同时需控制文化特定语言与临床模式的偏差,以确保数据集在不同西班牙语区域的迁移适用性。
常用场景
经典使用场景
ALIA-es-clinical-psychology-dialogues语料库是面向西班牙语临床心理对话场景的指令微调资源,由两大部分构成:一部分是基于大学心理诊所专业人员角色扮演生成的66段多轮临床对话,另一部分来自真实用户在TerapIA应用中与数字助手Pía的320段匿名化交互。该数据集最经典的用途在于为大规模语言模型提供带有共情策略和监督信号的会话数据,使其能够学习如何以西班牙语进行主动倾听、情绪验证和认知重构等心理辅导行为,从而在对话中展现出专业且富有温度的治疗性回应。
解决学术问题
该数据集致力于解决西班牙语心理对话领域缺乏高质量、专业化会话监督数据的学术瓶颈。长期以来,心理支持场景下的语言模型训练多依赖英语资源或通用对话语料,导致模型在西班牙语情绪识别、跨文化共情表达以及安全临床引导策略上表现欠佳。ALIA-es-clinical-psychology-dialogues通过提供角色扮演和真实用户两种来源的对话实例,为研究人员探索共情对齐、主动倾听机制以及心理辅导对话的语用结构提供了宝贵的实验基础,显著推动了多语言临床自然语言处理的发展。
实际应用
在实际应用中,该数据集可用于训练面向西班牙语人群的智能心理健康助手,使其能够在低压情境下为用户提供初步的情绪支持和心理疏导。例如,集成该数据微调后的模型可以被部署于在线咨询平台、心理健康应用程序或社区服务热线中,辅助缓解专业心理资源短缺的压力。此外,其高质量的会话样本还可用于构建虚拟病人系统,支持心理治疗师培训中的角色扮演练习,提升临床教学的交互真实性和多样性。
数据集最近研究
最新研究方向
在西班牙语临床心理学领域,该数据集的最新研究方向聚焦于通过多轮对话语料库对大型语言模型进行监督微调,以赋能AI在共情治疗与主动倾听方面的能力。研究前沿正探索利用角色扮演与真实应用场景数据,优化模型在焦虑、压力、抑郁等情感问题中的回应策略,推动认知重构与放松技术的自动化实施。这一工作与欧盟资助的ALIA项目紧密关联,旨在构建经伦理校验、文化适配的数字心理健康助手,其意义在于突破传统临床资源的语言与地域限制,为西班牙语社区提供可扩展、可访问的初步心理支持工具,同时为评估模型的情感对齐与角色扮演有效性树立标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

