Objaverse-XL-Rigged-Animated
收藏资源简介:
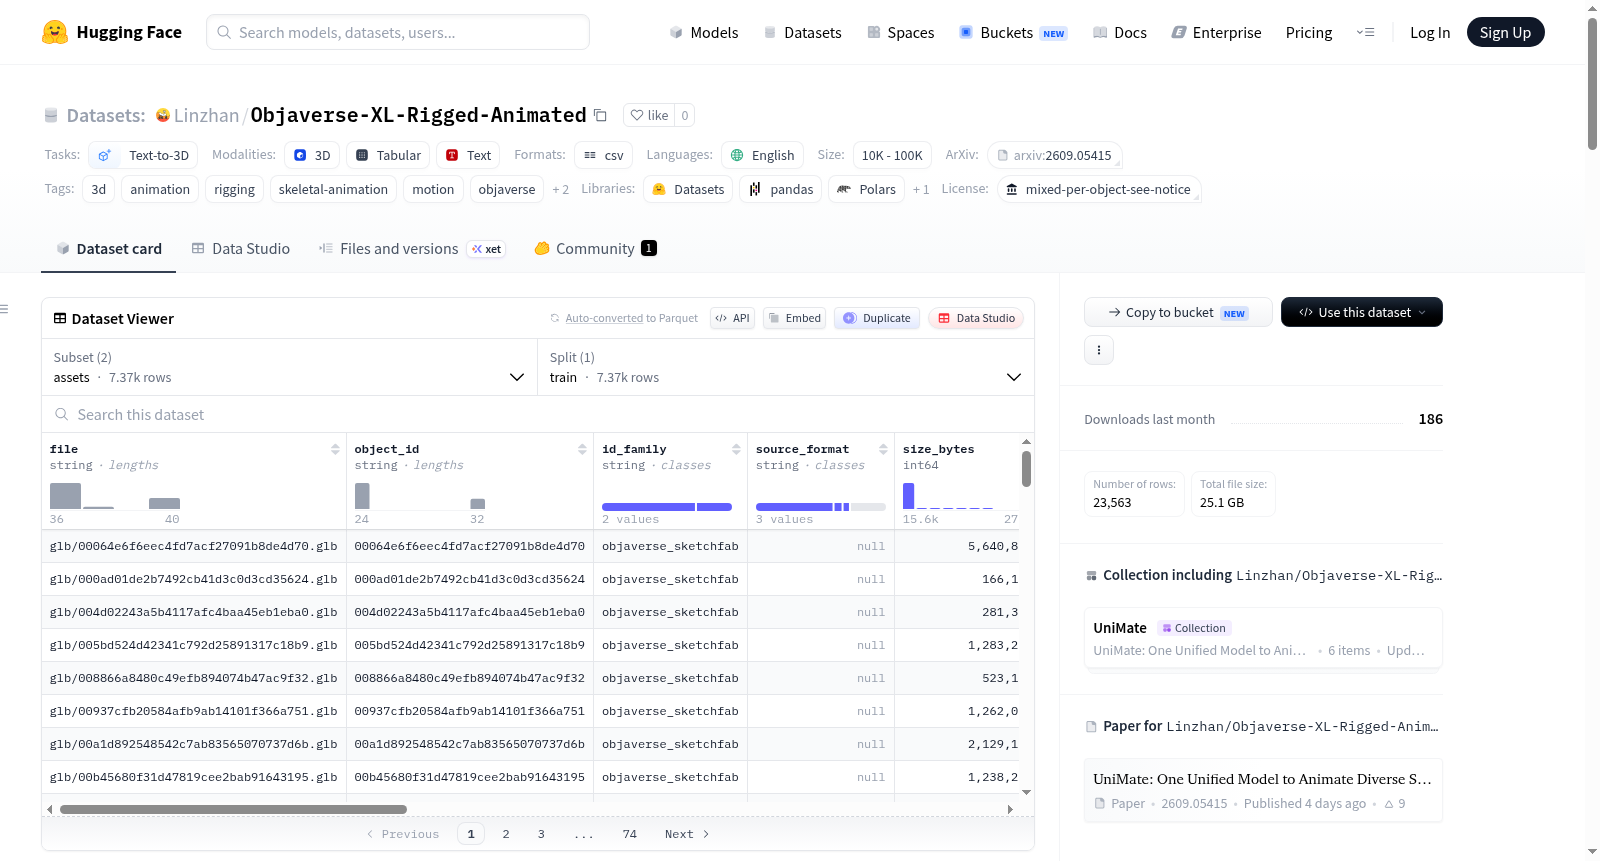
Objaverse-XL Rigged & Animated Subset 是一个从大规模 3D 对象库 Objaverse / Objaverse-XL 中精心筛选的子集,专注于同时包含骨架(rig)和动画剪辑(animation clip)的 3D 资产。该数据集由 Linzhan Mou 等人创建,作为 UniML3D 训练语料的一部分,用于支持多样骨架的动画生成研究(如 UniMate 模型,SIGGRAPH Asia 2026)。数据内容:资产总数 7,373 个 GLB 文件(约 23 GB),动画剪辑共 16,190 个,总时长约 21.0 小时。骨架范围:每个资产的关节数从 3 到 344 不等,中位数 44,95 分位数 78。动画时长:每个剪辑的中位数时长 2.03 秒,95 分位数 17.1 秒,最长 745 秒。所有资产均经过检查,确保至少包含一个带关节的蒙皮和至少一个能驱动它们的动画剪辑。资产以原始下载形式提供,未进行过滤、重定向、规范化或关节重命名。文件结构包括 glb/ 目录、metadata.csv、animations.csv、excluded.csv 和 scripts/。数据字段:metadata.csv 包含 file、object_id、id_family、source_format、num_vertices、num_joints 等;animations.csv 包含 file、object_id、clip_index、clip_name、duration_sec 等。适用任务:文本到 3D 动画生成、骨架动画重定向、运动检索、角色动画研究、多模态 3D 理解等。使用许可:资产本身保留各自的上游许可,衍生数据采用 ODC-BY 1.0 许可,渲染数据集继承各资产的上游许可。
The Objaverse-XL Rigged & Animated Subset is a carefully curated subset from the large-scale 3D object library Objaverse / Objaverse-XL, focusing on 3D assets that contain both rigs and animation clips. Created by Linzhan Mou et al. as part of the UniML3D training corpus, it supports research on diverse skeleton-driven animation generation (e.g., UniMate model, SIGGRAPH Asia 2026). Data content: 7,373 GLB files (approximately 23 GB), 16,190 animation clips totaling about 21.0 hours. Skeleton range: each asset has 3 to 344 joints, median 44, 95th percentile 78. Animation duration: median clip duration 2.03 seconds, 95th percentile 17.1 seconds, max 745 seconds. All assets are verified to contain at least one jointed skin and at least one animation clip driving them. Assets are provided as originally downloaded, without filtering, retargeting, normalization, or joint renaming. File structure includes glb/ directory, metadata.csv, animations.csv, excluded.csv, and scripts/. Data fields: metadata.csv contains file, object_id, id_family, source_format, num_vertices, num_joints, etc.; animations.csv contains file, object_id, clip_index, clip_name, duration_sec, etc. Applicable tasks: text-to-3D animation generation, skeleton animation retargeting, motion retrieval, character animation research, multimodal 3D understanding, etc. License: assets retain their respective upstream licenses, derived data is under ODC-BY 1.0, and rendered datasets inherit upstream licenses.
Objaverse-XL Rigged & Animated Subset 数据集详情
数据集概述
该数据集是从 Objaverse / Objaverse-XL 中筛选出的一个子集,专门收录同时具备骨骼(skeleton) 与至少一段动画片段的 3D 资产。骨骼数量范围从 3 至 344 个关节,涵盖角色模型及可活动的刚性物体。所有文件均经过验证,确保至少含有一个带关节的蒙皮和至少一段实际驱动关节的动画。
数据规模与统计
| 指标 | 数值 |
|---|---|
| 资产总数(GLB) | 7,373 个(总大小 23 GB) |
| 动画片段总数 | 16,190 段(合计约 21.0 小时) |
| 同时具备骨骼与动画的资产占比 | 100%(7,373 个) |
| 单一运动学树结构资产 | 7,128 个(96.7%),其余 245 个需修剪 |
| 每资产关节数 | 中位数 44 · 最大 344 · 最小 3 |
| 片段时长 | 中位数 2.03 秒 · 最大 745 秒 |
| 近静态片段(< 0.1 秒) | 803 段 |
| 每资产顶点数 | 中位数 6,628 · 最大 1.52M |
文件与目录结构
glb/ 7,373 个原始 .glb 文件(保留原名) metadata.csv 每个资产一行记录 animations.csv 每个动画片段一行记录 excluded.csv 18 个已知无法处理的资产(3 个因导入错误,15 个因动画静止或过短) scripts/ 用于提取表格的 glTF 探针脚本
文件名规则:
<24-hex>_{fbx,glb,gltf}.glb:共 5,305 个,来源于 Objaverse-XL(GitHub),后缀表示原始格式<32-hex>.glb:共 2,068 个,来源于 Objaverse 1.0 / Sketchfab UID
所有资产均按原始格式提供(未做筛选、重定向、归一化或关节重命名),以便用户自行预处理。
数据结构说明
metadata.csv(每资产一行)
关键列包括:file(路径)、object_id、id_family(来源家族)、source_format(转换前格式)、num_joints(关节数)、single_tree(是否为单一运动学树)、num_animations(动画数量)、total_duration_sec(总时长)以及 generator(导出器信息)等,旨在提供结构属性以辅助预处理规划。
animations.csv(每动画片段一行)
关键列包括:clip_name、duration_sec、keyframes、animated_joints、drives_skeleton(是否驱动骨骼)等。其中 5,615 / 16,190 段动画仅驱动非关节节点(如物体级变换),并非直接作用于角色骨骼;每个资产至少有一段动画会驱动其骨骼。
渲染资源
渲染文件存放在独立仓库 Objaverse-XL-Rigged-Animated-Renders 中,含:
- 每个动画片段的四视图 MP4(共 10,355 个文件夹)
- 每个资产的 2×2 静止姿势网格(
tpose/,7,373 张 PNG)
文件名与主数据集一致,可无缝对接。
使用示例
python from datasets import load_dataset
assets = load_dataset("Linzhan/Objaverse-XL-Rigged-Animated", "assets", split="train") clips = load_dataset("Linzhan/Objaverse-XL-Rigged-Animated", "animations", split="train")
筛选无需修剪且关节数在 20~100 的资产
clean = assets.filter(lambda r: r["single_tree"] == "true" and 20 <= r["num_joints"] <= 100)
筛选驱动骨骼且时长 ≥ 0.5 秒的动画
usable = clips.filter(lambda r: r["drives_skeleton"] == "true" and r["duration_sec"] >= 0.5)
关联资源与处理流程
该数据集是 UniML3D 训练语料的一部分,配套处理管线开源在 UniMate/data_process:可将每个动画片段导出为 NPZ、生成预览、通过视觉语言模型生成描述并清洗关节标签。处理后的发布版本为 UniML3D。
许可证与版权
glb/中的资产保留各第三方创作者的上游个人许可证(多为 Sketchfab 的各类 CC 协议,或 GitHub 来源适用的条款),无统一许可证覆盖合集,发布不代表授予许可。使用前须通过 Objaverse-XL 注释查询特定object_id的许可证。- 衍生材料
metadata.csv、animations.csv、scripts/及数据集说明卡片采用 ODC-BY 1.0 协议(与上游 Objaverse 元数据一致)。 - 配套仓库中的渲染因描绘资产本身,继承各资产上游许可证,不在上述授权范围内。
- 权利方如需移除资产,可在仓库中发起 issue,完整政策见
NOTICE.md。
引用方式
该数据集所属论文为 UniMate: One Unified Model to Animate Diverse Skeletons(SIGGRAPH Asia 2026),论文页面见 arXiv,同时请引用本数据集仓库及 Objaverse-XL 作为资产来源。