humanitys-second-last-exam
收藏资源简介:
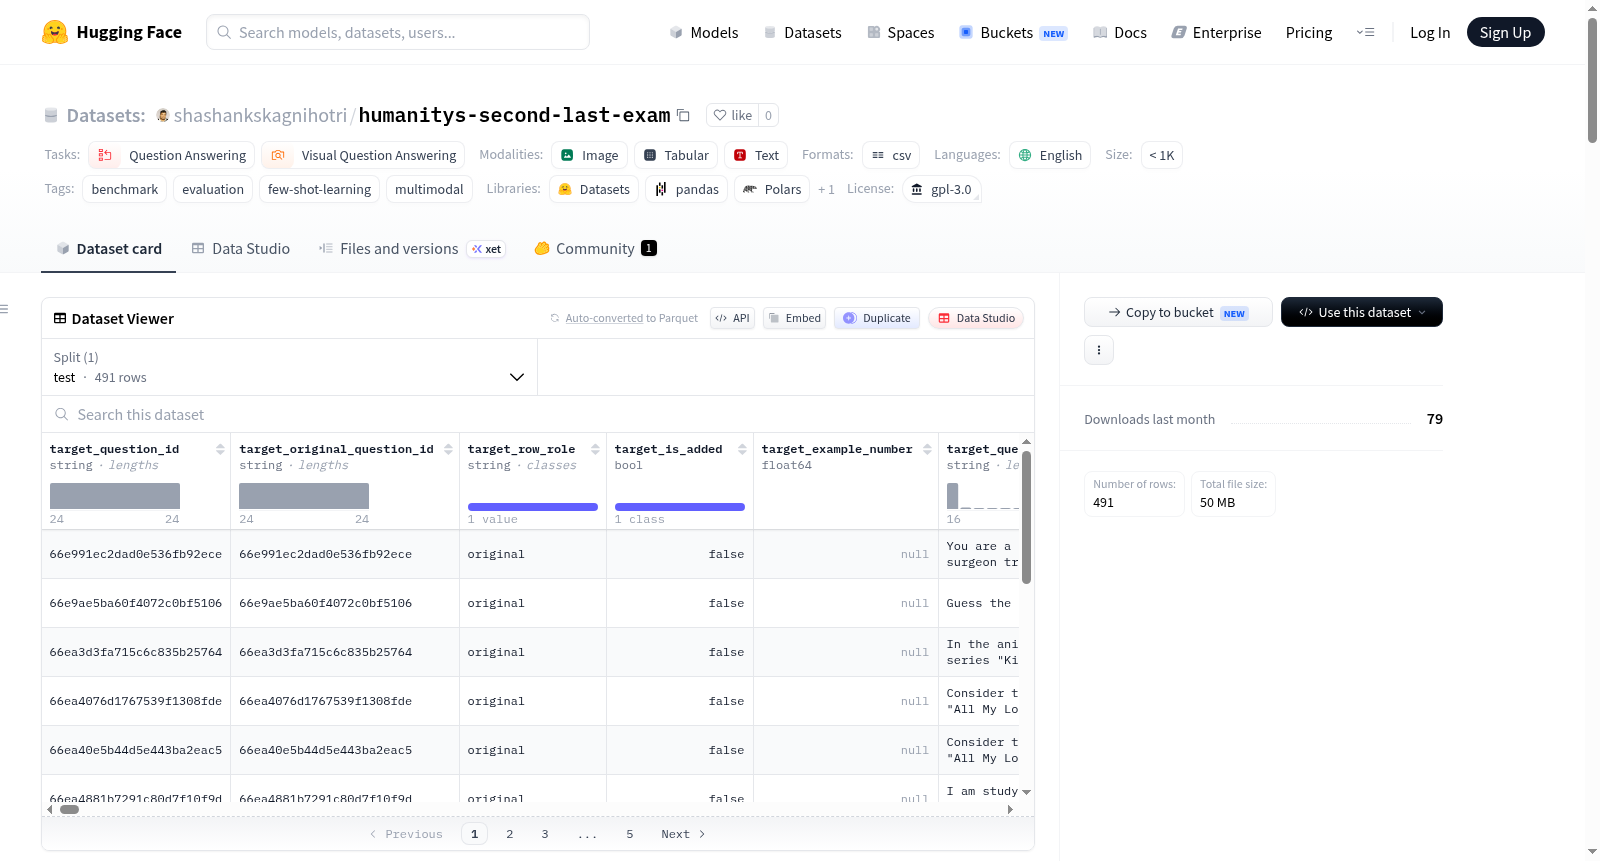
本数据集是“人类第二最后考试”(Humanitys Second Last Exam, HSLE)基准测试的科学输入数据,旨在复现该基准测试。数据集包含491个最终目标问题,其中417个为纯文本问题,74个涉及图像引用。每个目标问题附带两个上下文示例(共982个),用于进行上下文学习评估。数据以CSV文件形式呈现,主要文件为`data/hsle_consolidated.csv`,包含491行和174列,每行包括目标记录、实例1记录和实例2记录,每个记录有58个字段(如问题、答案、推理等)。所有问题、答案和推理值均非空或保持原始空白状态。此外,还提供了处理后的CSV文件(如问题、上下文示例、链接记录)、图像文件(258个唯一图像)以及详细的更正记录(针对172个目标问题的文本、答案或推理进行了更正)。数据集适用于文本问答和视觉问答任务,支持少样本学习评估。数据来源于cais/hle、HLE-Verified等外部数据集,并进行了版本固定和完整性校验。许可证为GNU通用公共许可证v3.0。
This dataset is the scientific input data for the Humanitys Second Last Exam (HSLE) benchmark, designed to reproduce the benchmark. The dataset contains 491 final target questions, of which 417 are pure text questions and 74 involve image references. Each target question is accompanied by two context examples (982 in total) for in-context learning evaluation. The data is presented in CSV format, with the main file `data/hsle_consolidated.csv` containing 491 rows and 174 columns, each row including a target record, instance 1 record, and instance 2 record, each with 58 fields (e.g., question, answer, reasoning). All question, answer, and reasoning values are either non-empty or remain in their original blank state. Additionally, processed CSV files (e.g., questions, context examples, link records), image files (258 unique images), and detailed correction records (with corrections to text, answers, or reasoning for 172 target questions) are provided. The dataset is suitable for text question answering and visual question answering tasks, supporting few-shot learning evaluation. The data originates from external datasets such as cais/hle and HLE-Verified, with version pinning and integrity checks. The license is GNU General Public License v3.0.
数据集概述:Humanitys Second Last Exam: Scientific Inputs
基本信息
- 数据集名称:Humanitys Second Last Exam: Scientific Inputs
- 创建者与维护者:Shashank Agnihotri
- 语言:英语(en)
- 许可证:GNU General Public License v3.0
- 任务类别:问答(Question-Answering)、视觉问答(Visual Question-Answering)
- 标签:基准测试、评估、少样本学习、多模态
数据集内容
本数据集包含复现 Humanitys Second Last Exam (HSLE) 基准所需的科学输入数据,不包含任何模型响应、评审响应、聚合指标或图表等生成产物。
核心统计
| 项目 | 数量 |
|---|---|
| 目标问题总数 | 491 |
| 纯文本目标问题 | 417 |
| 引用图像的目标问题 | 74 |
| 上下文示例 | 982(每个目标问题关联2个) |
| 目标与上下文示例合并总行数 | 1,473 |
| 目标到上下文示例的链接记录 | 491 |
| 唯一引用图像文件 | 258 |
数据构成
主数据集
- 文件:
data/hsle_consolidated.csv - 规模:491行 × 174列
- 结构:每行包含完整的58字段目标记录、58字段实例1记录和58字段实例2记录,原始
rationale字段以reasoning形式呈现,无任何源字段被省略。
其他文件
| 路径 | 行数/文件数 | 用途 |
|---|---|---|
processed/hsle_original_questions.csv |
491 | 修正后的目标问题 |
processed/hsle_context_examples.csv |
982 | 每个目标的上下文示例 |
processed/hsle_all_rows.csv |
1,473 | 归一化的完整表 |
processed/hsle_question_example_links.csv |
491 | 目标与示例映射 |
processed/hsle_image_manifest.csv |
491 | 图像来源与匹配信息 |
processed/dataset_metadata.json |
1 | 计数、修订、哈希等元数据 |
images/ |
258 | 引用的唯一图像文件 |
corrections/ |
多个 | 修正审计与来源追踪文件 |
质量说明
- 所有491个目标问题及答案、982个关联实例问题及答案均非空。
- 489/491 目标推理值、417/982 实例推理值为非空,其余源推理单元格本身为空白,未被虚构或静默填充。
- 目标集是为本研究筛选的交集,而非完整的2,500行HLE测试集。
修正信息
- 172个目标问题至少有一个组件被修正,各组件修正数量有重叠:
- 问题文本修正:22
- 答案修正:93(其中91个改变语义答案,2个仅规范化)
- 推理修正:160
- 同时修正问题与答案的目标:9
- 982个上下文示例中,有1行有文档化的手动科学修正。
来源与追溯
| 来源 | 范围 | 固定修订版本 |
|---|---|---|
cais/hle |
test;2,500行 | 5a81a4c7271a2a2a312b9a690f0c2fde837e4c29 |
skylenage-ai/HLE-Verified |
选定目标的验证证据 | 0bc83643672d4f68a5f89998617a639d85e7318b |
futurehouse/hle-gold-bio-chem |
重叠ID的附加金标准证据 | 1feb9e1d545731dba81e594438330406830e5260 |
数据集还提供了多个关键的SHA-256哈希值,用于识别历史合并输入、整合数据集、修正清单及选定的目标内容。
加载方式
可通过 load_dataset 直接加载主表,或使用 pandas 直接读取 CSV 文件。图像引用字符串为 data/images/<filename> 形式,在独立数据集中需将文件名解析至 images/ 目录。文本评估可使用 target_has_image 为 false 的417行;视觉评估需使用 has_image 及图像引用字段。
引用方式
bibtex @misc{agnihotri2026hsle, author = {Shashank Agnihotri}, title = {Humanitys Second Last Exam}, year = {2026}, howpublished = {Hugging Face dataset and GitHub software release}, url = {https://huggingface.co/datasets/shashankskagnihotri/humanitys-second-last-exam} }