
tsiiiing/ShiJiJiaYuanDataset
收藏官方服务:
资源简介:
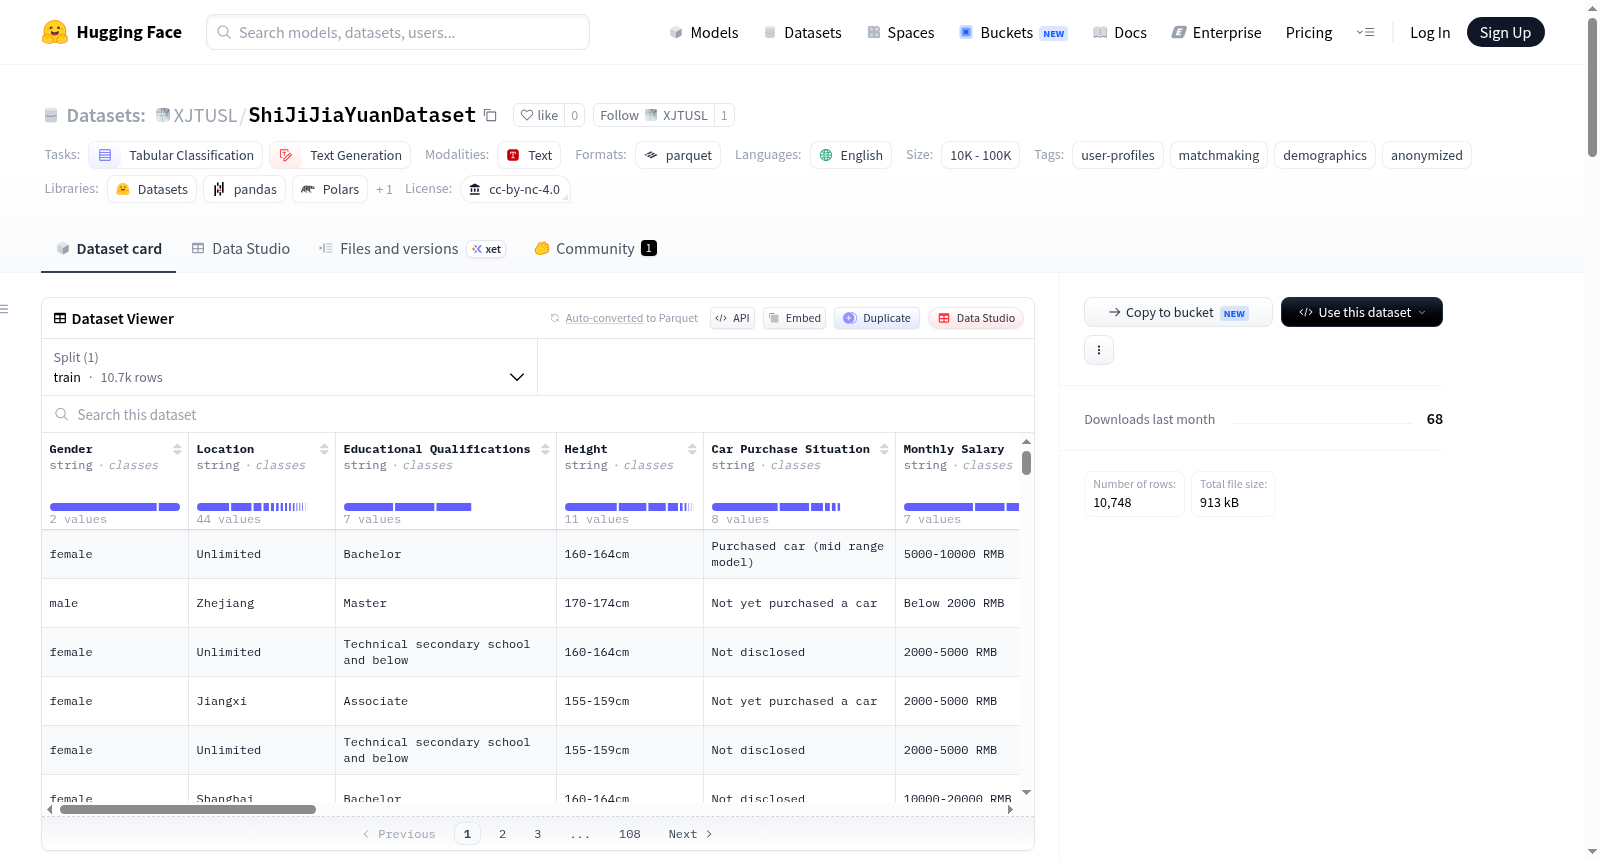
一个包含10,748条匿名用户个人资料的数据集,源自一个婚恋/交友平台。每条记录包含人口统计属性、生活习惯和偏好。该数据集已进行去标识化处理,以满足k-匿名性(k >= 5)。
A collection of 10,748 anonymized user profiles from a matchmaking/dating platform. Each record contains demographic attributes, lifestyle habits, and preferences. The dataset has been de-identified to satisfy k-anonymity (k >= 5).
提供机构:
tsiiiing搜集汇总
数据集介绍
构建方式
该数据集源自某婚恋交友平台,共计收录10,748份经过匿名化处理的用户档案。在构建过程中,原始用户标识符被彻底移除,记录顺序被随机打乱。为保障隐私安全,对年龄、身高、所在地与籍贯等准标识符进行了多轮泛化处理,例如将精确年龄转换为5岁或10岁区间、将城市级地点泛化为省级或区域级。同时,通过记录抑制策略剔除了321条即使经过最大泛化仍无法满足k≥5条件的记录,最终确保每一组(性别、年龄、所在地、身高)组合在数据集中至少出现5次,达成k-匿名性保护。所有缺失或保密值统一替换为“Not disclosed”,以提升数据一致性。
特点
该数据集包含24个字段,涵盖用户的人口统计学属性(如性别、年龄、学历)、生活方式特征(如吸烟饮酒习惯、运动频率、作息规律)以及择偶偏好(如是否接受子女、与父母同住的意愿)。数据整体呈现两大显著偏向:年龄分布集中在50至65岁之间,性别构成中女性用户占比约83%。尽管已满足k-匿名性要求,但数据未实现l-多样性与t-紧邻性保障,敏感属性(如薪资、婚姻状况)在等价类内可能分布不均衡,使用时需谨慎对待。其中年龄与婚姻状况两个敏感字段在默认视图预览中隐藏,仅在完整数据集中提供。
使用方法
用户可通过HuggingFace Datasets库快速加载默认配置,该配置包含22个字段,不包含年龄与婚姻状况,代码示例为`dataset = load_dataset("tsiiiing/ShiJiJiaYuanDataset")`。若需获取包含全部24个字段的完整数据集,可借助`huggingface_hub`库显式下载`full/train.parquet`文件,利用`pd.read_parquet()`读入,也可通过Datasets库直接指向该文件路径进行加载。此外,支持通过CLI命令`hf download tsiiiing/ShiJiJiaYuanDataset --type dataset --include "full/*"`下载完整数据。该数据集仅限科研用途,严禁用于个体画像或商业匹配推荐。
背景与挑战
背景概述
在线婚恋匹配领域长期面临用户隐私保护与个性化推荐之间的张力,如何在不泄露敏感信息的前提下挖掘用户偏好成为核心研究问题。ShiJiJiaYuanDataset数据集由研究者于2022年创建,源自真实婚恋平台,汇集了10,748份经匿名化处理的用户档案,涵盖人口统计特征、生活方式习惯及择偶偏好等24个维度。该数据集通过k-匿名性(k≥5)技术实现了身份去关联化,为推荐系统、人口统计分析等研究提供了兼具真实性与合规性的数据基础,其发布推动了隐私保护机制在社交计算领域的实践探索。
当前挑战
该数据集的核心挑战在于平衡数据效用与隐私安全。领域层面,婚恋匹配需处理非线性、高维度的用户偏好交互,而匿名化带来的属性泛化(如年龄精确值转为区间)削弱了特征粒度,可能影响推荐算法的区分度。构建过程中,原始数据面临准标识符组合导致的重识别风险,需通过多轮泛化与记录抑制(移除2.9%记录)达到k≥5的隐私阈值,同时年龄与婚姻状态等敏感属性被列为隐藏字段,进一步限制了直接特征工程的可能。此外,样本分布偏斜(约83%女性、年龄集中于50-65岁)加剧了模型泛化困难,且当前仅满足k-匿名性而未实现l-多样性或t-近似性,使敏感属性在等价类内仍存在分布不均的隐患。
常用场景
经典使用场景
ShiJiJiaYuanDataset作为一款经过严格匿名化处理的婚恋交友平台用户画像数据集,其经典使用场景集中于基于人口统计学属性与生活方式偏好的匹配推荐系统研究。该数据集囊括了性别、年龄、教育背景、收入水平、星座、吸烟饮酒习惯、运动频率、宠物喜好、子女观念等24个维度的结构化特征,为构建多模态用户相似度计算模型提供了理想的数据基础。研究者常将其用于训练分类器以预测用户间的兼容性得分,或作为强化学习环境中用户偏好的状态表示,从而探索个性化匹配策略的优化路径。
解决学术问题
该数据集直面了婚恋推荐领域中因隐私保护而导致的细粒度用户特征缺失这一核心学术困境。通过k-匿名(k≥5)机制的引入,它解决了在保障用户身份不可重识别的前提下,如何保留足够丰富的异质性特征以支撑统计推断与模型泛化的难题。此外,数据集中性别比例严重失衡(约83%为女性)、年龄分布集中于50-65岁等现实偏差,为社会网络分析与群体推荐公平性研究提供了珍贵的样本,推动了针对非平衡分布与选择偏差矫正方法的探索。
衍生相关工作
围绕该数据集衍生出的经典工作包括:基于非平衡性别比例的推荐系统去偏算法(如重加权与对抗学习)、面向区间型数据的用户兼容性预测模型、以及融合星座与血型等文化特征的多视角聚类方法。在隐私计算方向,研究者借鉴该数据集的泛化策略(5年或10年年龄分段)提出了自适应匿名化管线,并结合差分隐私机制进一步发展了第二代隐私保护用户画像数据集生成技术。此外,部分工作将之与文本匹配、图像偏好等非结构化数据结合,探索了跨模态婚恋推荐的融合框架。
以上内容由遇见数据集搜集并总结生成


