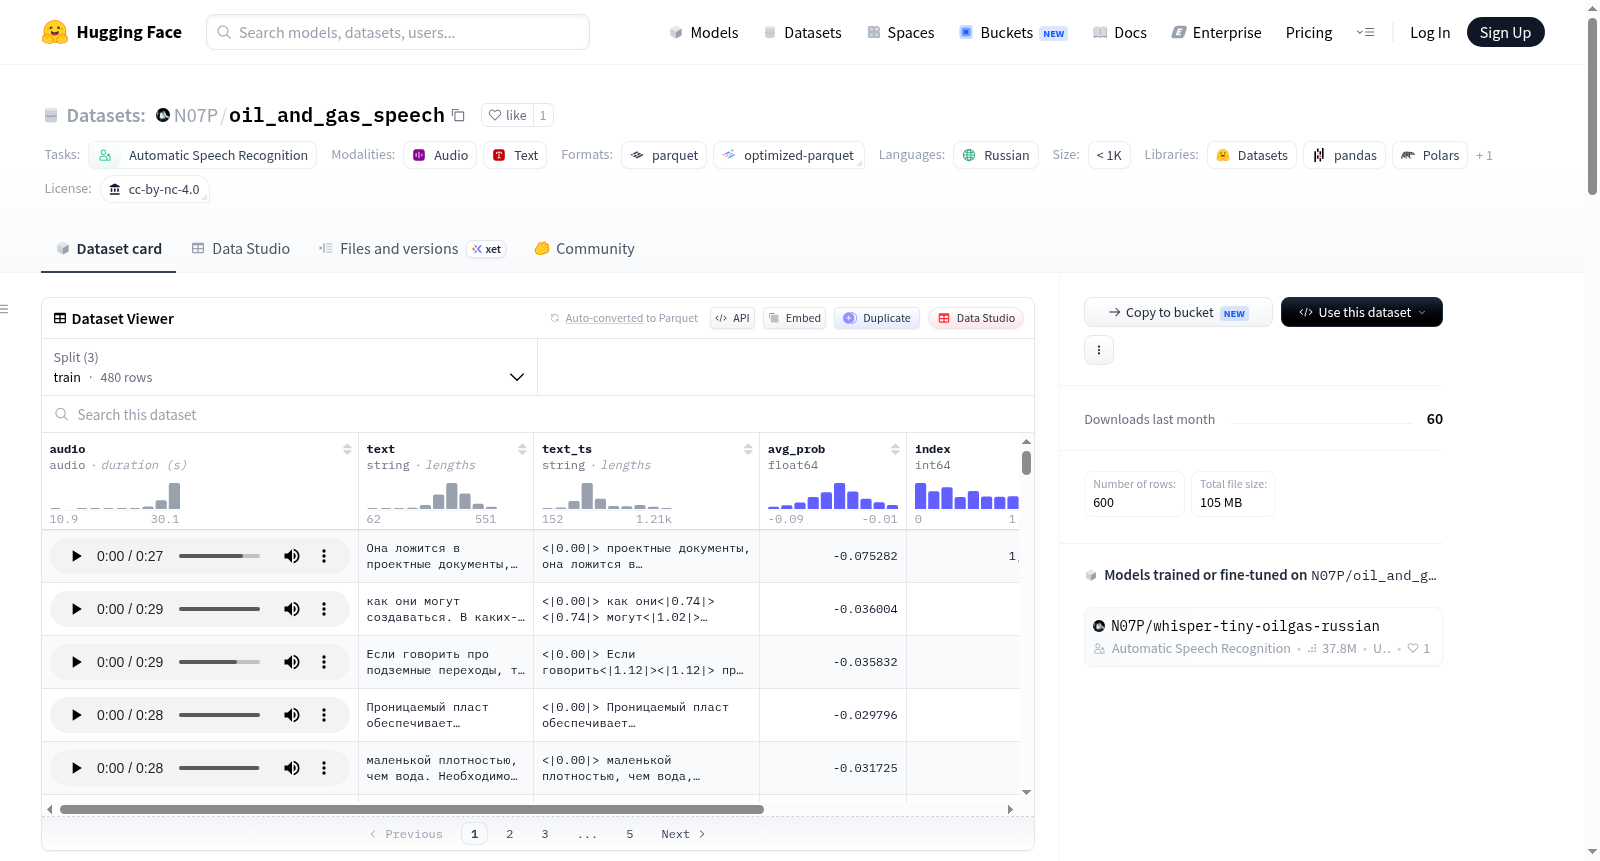
oil_and_gas_speech
收藏资源简介:
俄语石油和天然气语音数据集是一个专门用于微调俄语自动语音识别模型的专业领域数据集。该数据集旨在帮助模型更好地识别和理解石油和天然气行业的专业术语及特定语境下的语音表达。数据集包含600个音频片段及其对应的文本转录,每个样本都按照上下文类型进行了分类标注,包括:行业术语、连接词和引导结构、疑问句表达,以及噪音、感叹词和难以辨别的语音。数据按80/10/10的比例划分为训练集(480个样本)、验证集(60个样本)和测试集(60个样本)。每个样本包含音频文件路径、文本转录、带时间戳的转录、Whisper模型识别的平均对数概率(置信度指标)、上下文类型标签、原始索引和人工验证标志等字段。数据准备过程中,从1000多个原始音频中筛选出模型置信度最高的600个样本,并保持了特定的类型分布比例。所有验证集和测试集样本以及训练集中置信度最低的20%样本都经过了人工验证,确保数据质量。音频采样率为16kHz,总数据集大小约52.5MB。该数据集适用于石油和天然气领域的专业语音识别任务,能够帮助模型适应行业特定的术语和沟通模式。
The Russian Oil and Gas Speech Dataset is a specialized domain dataset designed for fine-tuning Russian automatic speech recognition models. It aims to help models better recognize and understand professional terminology and speech expressions in specific contexts within the oil and gas industry. The dataset includes 600 audio clips with corresponding text transcriptions, each annotated by context type, covering: industry terminology, connectors and guiding structures, interrogative expressions, as well as noise, interjections, and hard-to-distinguish speech. The data is split into an 80/10/10 ratio for training set (480 samples), validation set (60 samples), and test set (60 samples). Each sample contains fields such as audio file path, text transcription, timestamped transcription, average log probability (confidence metric) recognized by the Whisper model, context type label, original index, and manual verification flag. During data preparation, the 600 samples with the highest model confidence were selected from over 1,000 original audio clips, maintaining specific type distribution proportions. All validation and test set samples, along with the 20% of training samples with the lowest confidence, have been manually verified to ensure data quality. The audio sampling rate is 16kHz, and the total dataset size is approximately 52.5MB. This dataset is suitable for professional speech recognition tasks in the oil and gas field, helping models adapt to industry-specific terminology and communication patterns.
数据集概述:Нефтегазовый речевой датасет (Oil & Gas Russian Speech Dataset)
- 语言:俄语 (ru)
- 任务类别:自动语音识别 (automatic-speech-recognition)
- 数据集规模:n<1K
- 许可证:cc-by-nc-4.0
- 数据集名称(英文):Oil & Gas Russian Speech Dataset
数据集描述
该数据集专为在石油天然气行业术语上对俄语语音识别神经网络模型进行微调而设计。包含 600 个音频片段及其转录文本,并按上下文类型分类:
- term:行业词汇
- connector:连接词和引入结构
- question:疑问句
- noise:噪音、感叹词、不清语音
数据划分
数据按 80/10/10 的比例划分为训练集 (train)、验证集 (validation) 和测试集 (test):
- 训练集:480 个音频文件 (~42.1 MB)
- 验证集:60 个音频文件 (~5.2 MB)
- 测试集:60 个音频文件 (~5.3 MB)
质量控制:手动检查了验证集和测试集中的所有样本,以及训练集中模型置信度最低的 20% 样本(基于 avg_prob 字段)。
数据集结构
my_dataset/ ├── dataset_info.json ├── README.md ├── train/ │ ├── audio/ # 480 个音频文件 (~41.6 MB) │ └── metadata.jsonl ├── validation/ │ ├── audio/ # 60 个音频文件 (~5.2 MB) │ └── metadata.jsonl └── test/ ├── audio/ # 60 个音频文件 (~5.6 MB) └── metadata.jsonl
每个 metadata.jsonl 文件包含以下字段:
| 字段 | 类型 | 描述 |
|---|---|---|
audio |
string | 音频文件的相对路径(例如 "train/audio/train_0.mp3")。 |
text |
string | 音频的转录文本。 |
text_ts |
string | 带时间戳的转录文本。 |
avg_prob |
float | Whisper 模型识别的平均对数概率(值从 -∞ 到 0,0 表示完全确信)。 |
type |
string | 上下文类型:"term", "connector", "question", "noise"。 |
index |
int | 划分前在原始语料库中的索引。 |
human_verified |
bool | 标识 text 字段是否经过人工审核。 |
创建目的
用于对自动语音识别 (ASR) 模型进行微调,使其适应石油天然气行业的专业术语和沟通特点。按上下文类型分类有助于评估模型在不同语音场景下的鲁棒性。
准备过程
- 使用 Whisper 模型(whisper.cpp)从超过 1000 个原始音频片段中获得转录文本和
avg_prob值。 - 选出 600 个置信度最高的片段,并保持类型比例:term (50%), connector (30%), question (15%), noise (5%)。
- 进行分层抽样划分(train/val/test),确保每份数据都保持原始类型分布。
- 进行人工验证:所有验证集和测试集样本,以及训练集中
avg_prob值最低的 20% 样本。
下载与使用
数据集可通过 Hugging Face 的 datasets 库加载:
python from datasets import load_dataset, Audio
dataset = load_dataset("N07P/oil_and_gas_speech", split="train") dataset = dataset.cast_column("audio", Audio(sampling_rate=16000)) print(dataset[0])
数据集大小
- 下载大小(音频文件):46,392,372 字节 (~46.6 MB)
- 数据集大小(元数据):1,063,945 字节 (~1.01 MB)
作者
- 普罗沃托罗夫 N. R. (provotorovnikita@gmail.com, @prog_by_onion, https://vk.com/progbyonion)
补充信息
- 额外链接:数据准备脚本可在 https://github.com/nikita-2727/ai_learning_workspace 获取。
- 处理工具:使用 whisper.cpp 进行初始处理,所有转录文本都经过后处理以去除多余标签。