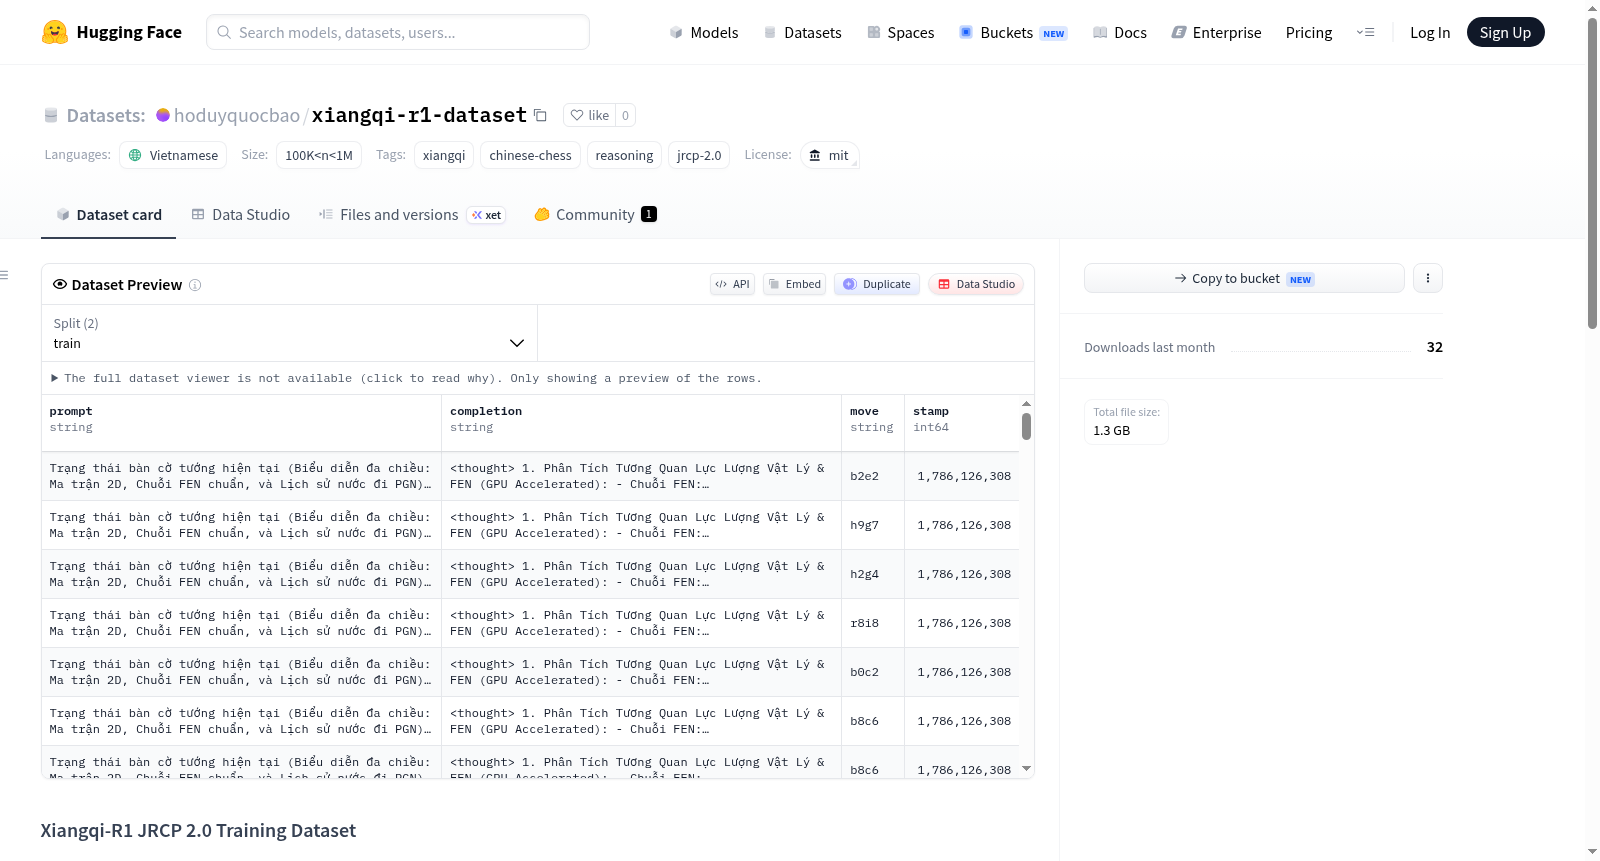
xiangqi-r1-dataset
收藏资源简介:
这是一个用于训练中国象棋(象棋)推理模型的高质量数据集,名为 Xiangqi-R1 JRCP 2.0 训练数据集。数据集包含 29,774 个样本,覆盖开局、中局、残局等多种阶段,以及胜、负、平局结果。每个样本采用 JSONL 格式,遵循 JRCP 2.0 对话标准,包含系统提示、用户输入(二维棋盘矩阵、FEN、PGN)和助手输出(结构化 JSON),并附带移动表示、评估值、结果、阶段、搜索深度、节点数和时间戳等元信息。数据来源于 Native Rust 引擎(xiangrust)以深度 4 自我对弈,并对每个棋盘位置进行 14 维 JRCP 2.0 分析。该数据集适用于训练大语言模型进行中国象棋的推理、决策和局面评估任务。许可证为 MIT,可自由用于研究和商业用途。
This is a high-quality dataset for training Chinese Chess (Xiangqi) reasoning models, named Xiangqi-R1 JRCP 2.0 Training Dataset. The dataset contains 29,774 samples covering various stages such as opening, middle game, and endgame, as well as win, loss, and draw results. Each sample is in JSONL format, following the JRCP 2.0 conversation standard, including system prompts, user inputs (2D board matrix, FEN, PGN) and assistant outputs (structured JSON), along with metadata such as move representation, evaluation value, result, stage, search depth, node count, and timestamp. The data originates from self-play at depth 4 using the native Rust engine (xiangrust), with 14-dimensional JRCP 2.0 analysis performed on each board position. The dataset is suitable for training large language models for Chinese Chess reasoning, decision-making, and position evaluation tasks. Licensed under MIT, it is freely available for research and commercial use.
Xiangqi-R1 JRCP 2.0 训练数据集
该数据集是一个用于训练中国象棋(Cờ Tướng)推理模型 Xiangqi-R1 的高质量训练数据集,支持多维度推理分析。
数据集规模
| 指标 | 数值 |
|---|---|
| 总样本数 | 29,774 |
| 开局(Opening) | 251 |
| 中局(Midgame) | 2,902 |
| 残局(Endgame) | 18,687 |
| 胜局(Win) | 317 |
| 负局(Loss) | 304 |
| 和局(Draw) | 21,219 |
数据格式
每个样本为JSONL格式的一行,符合JRCP 2.0对话标准,包含以下字段:
- messages:包含system、user、assistant三部分对话内容
- move:棋步(如 "b2e2")
- eval:评估值
- outcome:棋局结果(如 "draw")
- phase:棋局阶段(如 "opening")
- depth:搜索深度
- nodes:搜索节点数
- stamp:时间戳
数据来源
数据由原生Rust引擎(xiangrust)以深度(depth=4)自我对弈生成,并使用JRCP 2.0对每个棋盘位置进行14个维度的分析。
许可协议
采用 MIT License,允许免费用于研究和商业用途。