
遇见数据集

proxectonos/patrimonio_instruct

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

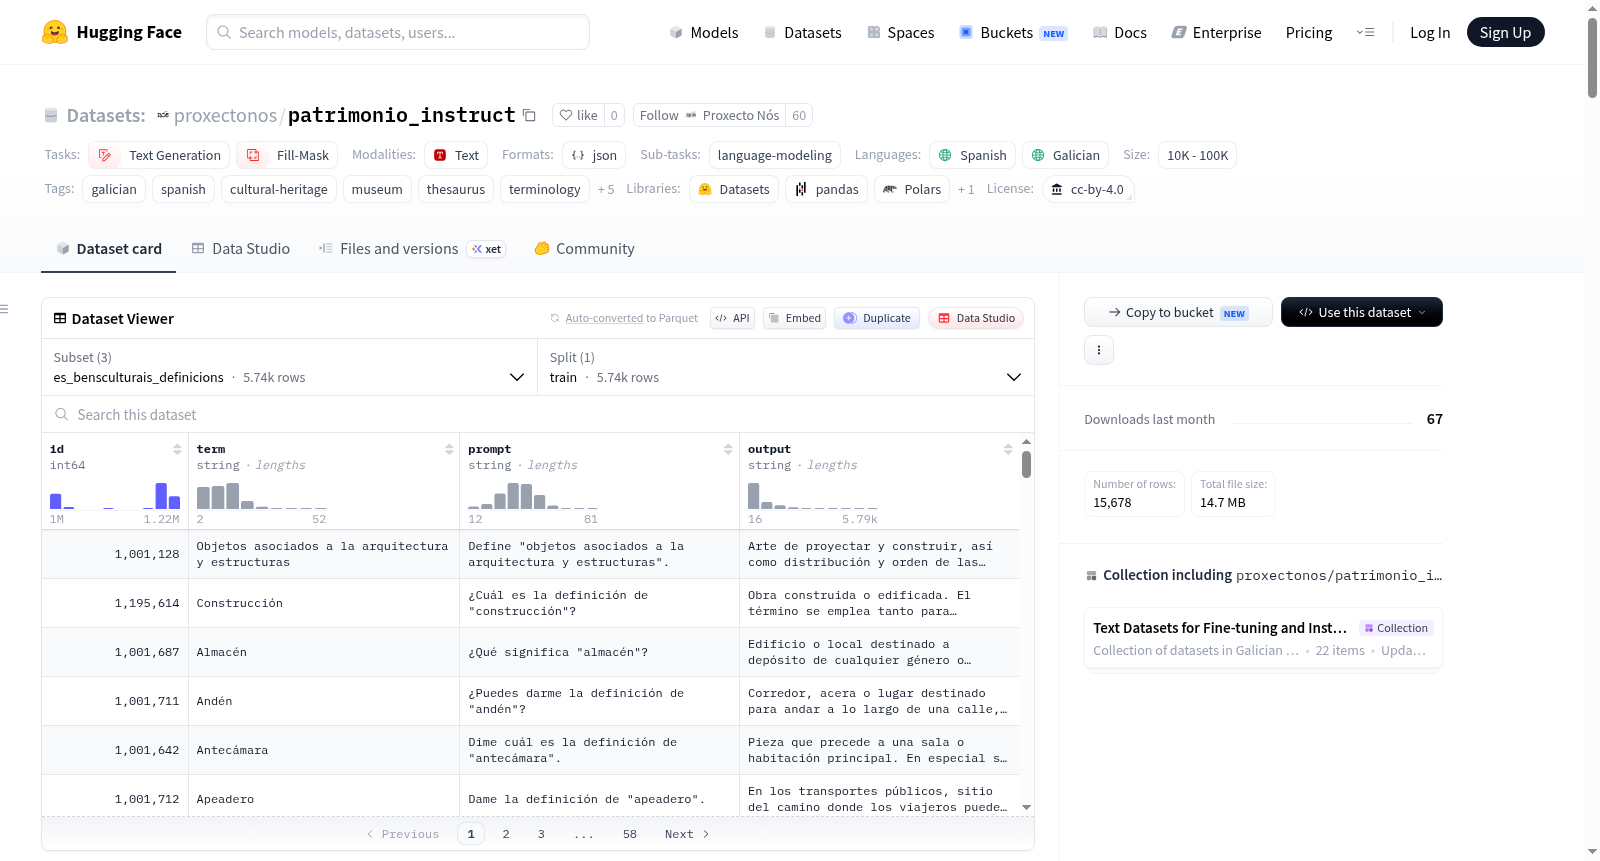
Patrimonio Instruct 是一个专注于文化遗产、博物馆术语以及文化对象和概念描述的指令式数据集。该数据集主要源自“文化遗产词库”(Tesauro de bienes culturales / Tesauro de bens culturais),这是一个专门用于文化遗产和博物馆领域的词库。它包含西班牙语和加利西亚语的定义生成示例,以及基于加利西亚语定义的完形填空示例。该资源旨在支持文化遗产领域的领域适应、指令调优、评估和术语聚焦实验,特别是针对加利西亚语和西班牙语语言模型。数据集包含三种配置:西班牙语定义生成示例、加利西亚语定义生成示例和加利西亚语完形填空定义示例。定义生成配置包含要求定义文化遗产术语的提示,而完形填空配置包含定义文本,其中术语被掩码,模型需要恢复正确答案。数据集设计用于支持专业文化遗产术语、博物馆文档以及加利西亚语/西班牙语领域特定生成的语言模型训练和评估。

Patrimonio Instruct is an instruction-style dataset focused on cultural heritage, museum terminology, and the description of cultural objects and concepts. The dataset is derived mainly from the Tesauro de bienes culturales / Tesauro de bens culturais, a specialized thesaurus for the cultural heritage and museum domain. It contains instruction-response examples for definition generation in Spanish and Galician, as well as Galician cloze-style examples based on heritage definitions. The resource is intended for domain adaptation, instruction tuning, evaluation, and terminology-focused experiments in the cultural heritage domain, especially for Galician and Spanish language models. The dataset contains three configurations: Spanish definition-generation examples, Galician definition-generation examples, and Galician cloze-definition examples. The definition-generation configurations contain prompts asking for the definition of a cultural heritage term, while the cloze configuration contains definitions where a term has been masked and the model is expected to recover the correct answer. The dataset is designed to support language-model training and evaluation in specialized cultural heritage terminology, museum documentation, and Galician/Spanish domain-specific generation.
提供机构:
proxectonos
搜集汇总
数据集介绍
proxectonos/patrimonio_instruct 数据集图片
构建方式
Patrimonio Instruct 数据集的构建依托于西班牙文化部发布的《文化遗产术语词典》,该资源涵盖文化遗产与博物馆领域的受控术语及定义。构建过程首先从原始术语词典中提取结构化的术语-定义对,随后将其转换为指令-响应的格式,形成西班牙语的定义生成样本。加利西亚语部分则通过对源术语及定义进行翻译与语言适配而生成,并进一步从定义中自动掩蔽相关术语或表达,创建了完形填空风格的样本。所有样本均以 JSONL 格式存储,保留了原始概念的标识符,确保可追溯至源条目。
特点
该数据集包含三个配置:西班牙语定义生成、加利西亚语定义生成以及加利西亚语完形填空,共计约1.5万个样本。其核心特点在于聚焦文化遗产这一高度专业化领域,术语严谨、定义详实,且跨双语(西班牙语与加利西亚语)覆盖。完形填空配置通过自动掩蔽关键术语,提供了评估模型术语掌握程度的独特视角。数据来源权威,遵循CC-BY-4.0许可,确保了学术使用的合法性与开放性。
使用方法
该数据集主要用于文化遗产领域的语言模型指令微调、术语生成评估及掩码语言建模。用户可通过 HuggingFace 的 `datasets` 库加载,例如 `load_dataset("proxectonos/patrimonio_instruct", "gl_bensculturais_definicions", split="train")` 即可获取加利西亚语定义生成子集。三个配置分别适用于定义生成、术语理解及完形填空任务。建议结合原始术语词典进行参考,以充分发挥其在领域适应和术语建模中的价值。
背景与挑战
背景概述
Patrimonio Instruct 数据集由西班牙 Proxecto Nós 研究团队于近年创建,依托西班牙文化部发布的《文化遗产叙词表》(Tesauro de bienes culturales),聚焦于文化遗产领域的术语定义与指令微调。该数据集以西班牙语和加利西亚语为语言载体,包含定义生成与完形填空两类任务,旨在推动低资源语言(如加利西亚语)在博物馆文档、文化遗产术语建模等专业场景中的自然语言处理研究。作为面向领域适配与指令微调的资源,Patrimonio Instruct 不仅填补了文化遗产术语方向高质量指令数据的空白,也为多语言模型在文化遗产领域的生成能力提供了重要评测基准。
当前挑战
该数据集面临的核心挑战包括:其一,文化遗产术语具有高度专业性和概念复杂性,定义文本常夹杂历史语境与分类体系,使模型准确生成或补全定义面临语义精准性难题;其二,加利西亚语为低资源语言,术语翻译与语言适配过程可能引入语义偏差,且缺乏独立撰写的权威术语库作为参照;其三,构建中自动从叙词表提取定义并生成完形填空示例,易受术语歧义与掩码策略影响,导致训练样本难度不均;此外,数据集源于单一叙词表,难以全面覆盖文化遗产领域的多元知识体系,限制了模型的泛化能力。
常用场景
经典使用场景
在文化遗产与博物馆领域,Patrimonio Instruct 数据集的核心应用场景涵盖指令微调与术语建模。研究者可基于该数据集中的西班牙语与加利西亚语定义生成配置,训练语言模型精准产出文化遗产术语的规范性释义。此外,加利西亚语完形填空配置支持遮蔽语言模型任务,使模型能够在博物馆专业描述中复原被掩码的术语,从而强化其对领域概念关联与上下文语义的理解能力。该数据集尤其适用于低资源语言(如加利西亚语)在专门领域内的生成式语言模型适配与评估。
衍生相关工作
围绕 Patrimonio Instruct 已衍生出一系列经典研究工作,主要集中于低资源语言的文化遗产领域模型适配与评估。基于该数据集,研究者进行了加利西亚语大型语言模型的指令微调实验,验证了领域术语知识对生成质量的正向影响。其完形填空配置还被用于开发专门的术语理解基准,以衡量模型对博物馆概念的深层语义掌握程度。此外,该数据集促成了跨语言知识蒸馏方法的探索,即将西班牙语定义知识迁移至加利西亚语生成管道,为多语言文化遗产自然语言处理提供了可复现的范例。
数据集最近研究
最新研究方向
当前,Patrimonio Instruct数据集引领了面向文化遗产领域的指令微调与小样本术语生成研究新浪潮。该数据集依托西班牙文化部发布的《文化遗产资产叙词表》,构建了双语言(西班牙语与加利西亚语)的专业术语定义生成与完形填空任务,尤其聚焦于博物馆文献学与文化遗产本体描述。在生成式AI与低资源语言保护交叉的热点背景下,该资源为跨语言领域模型适配、术语知识蒸馏及指令遵循能力评测提供了关键基准,显著推动了加利西亚语等小语种在专业数字人文中的语料建设与模型优化,对文化遗产数字化叙事与智能知识服务具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

