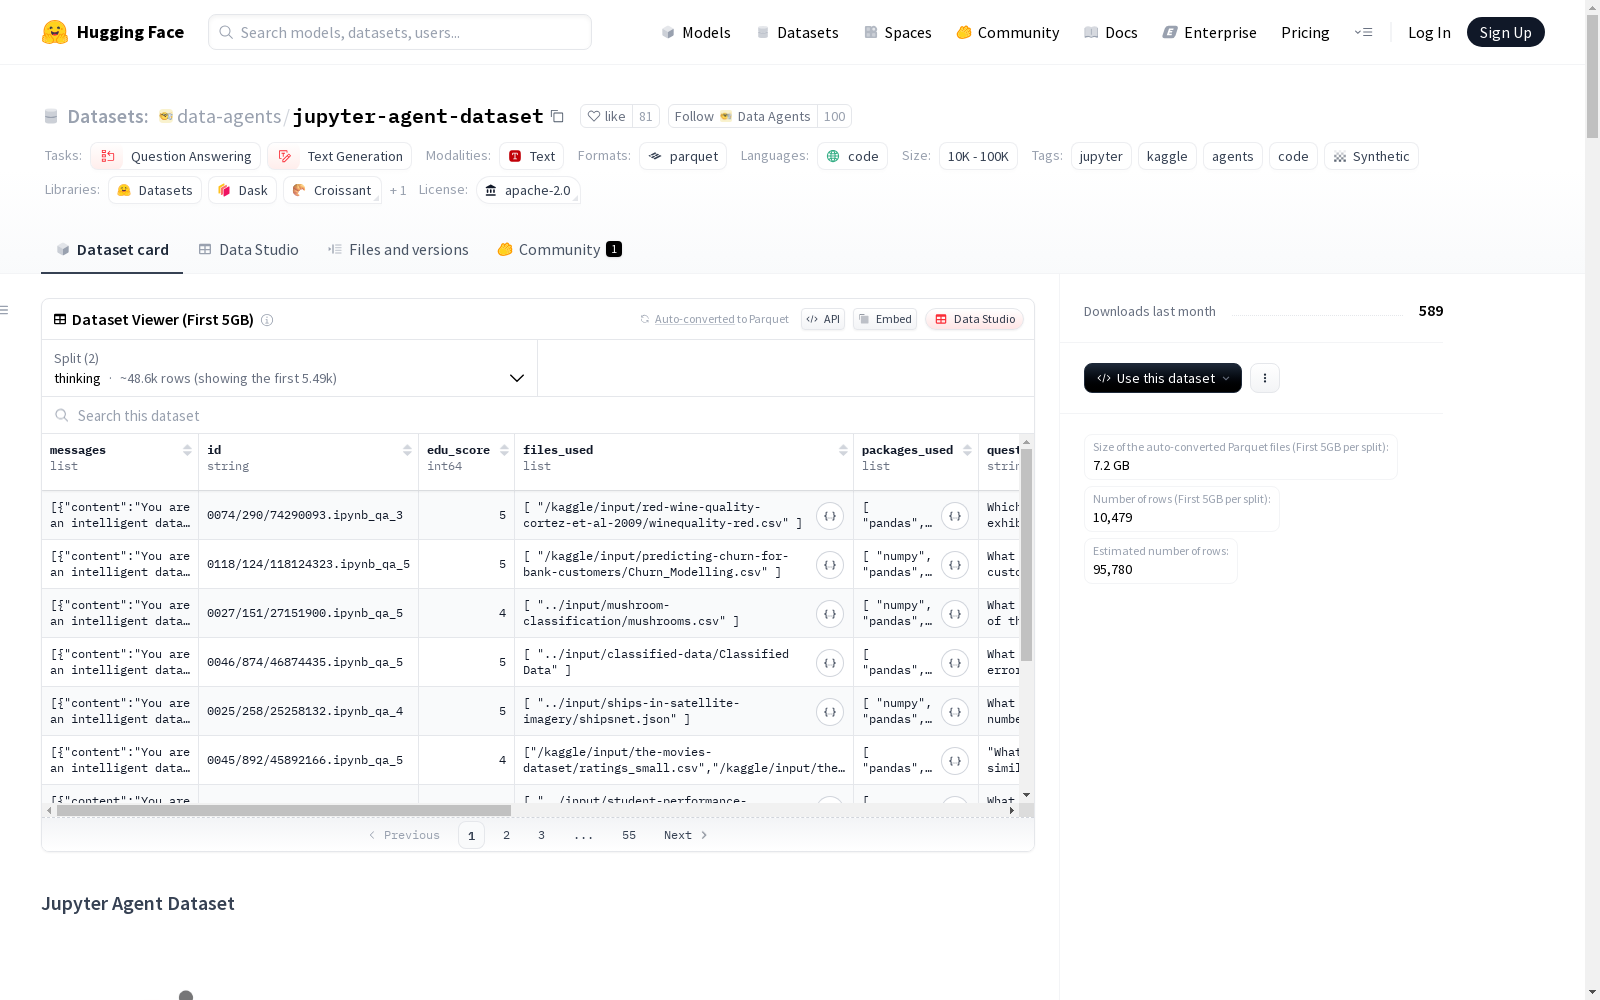
jupyter-agent-dataset
收藏资源简介:
Jupyter Agent Dataset是一个基于Kaggle笔记本的合成数据集,包含去重、引用数据集、教育质量评分、数据分析相关内容过滤、问题回答对和可执行推理轨迹。数据集分为两个子集:'thinking'和'non-thinking',适合不同类型的模型训练。每个例子包含一个合成笔记本和相应的自然语言问题和验证过的答案。
Jupyter Agent Dataset is a synthetic dataset based on Kaggle notebooks. It includes deduplication, referenced datasets, educational quality scoring, data analysis-related content filtering, question-answer pairs, and executable reasoning traces. The dataset is split into two subsets: 'thinking' and 'non-thinking', which are suitable for training different types of models. Each example contains a synthetic notebook, along with corresponding natural language questions and verified answers.
Jupyter Agent Dataset 概述
数据集基本信息
- 名称:Jupyter Agent Dataset
- 创建者:Hugging Face Data-Agents Team
- 语言:代码
- 许可证:Apache-2.0
- 多语言性:单语言
- 标注创建方式:机器生成
- 标签:jupyter, kaggle, agents, code, synthetic
- 任务类别:问答、文本生成
- 规模类别:10K<n<100K
数据集规模与结构
- 总样本数:51,389个合成笔记本
- 训练标记数:约20亿
- 下载大小:71,781,735,066字节
- 数据集大小:102,156,900,168字节
- 特征:
id:笔记本和问题对的唯一标识符messages:ChatML格式的合成笔记本question:基于笔记本/数据集的自然语言问题answer:经过验证的简短最终答案edu_score:教育质量评分files_used:原始Kaggle笔记本中使用的文件packages_used:原始Kaggle笔记本中使用的包kaggle_dataset_name:Kaggle源数据集名称executor_type:代码执行器类型original_notebook:原始Kaggle源笔记本tools:用于笔记本生成的工具调用
数据子集
- thinking子集:
- 字节数:51,081,197,281
- 样本数:51,389
- non_thinking子集:
- 字节数:51,075,702,887
- 样本数:51,389
用途
- 训练能够阅读笔记本和数据集上下文的代码代理
- 执行Python代码回答基于数据集的问题
- 生成带有中间计算的逐步解决方案
数据集创建过程
-
数据来源与准备:
- 大规模去重Kaggle笔记本
- 通过Kaggle元数据自动获取链接数据集
- 使用Qwen-32B进行教育质量评分
- 过滤不相关的笔记本
-
合成笔记本生成:
- 使用Qwen-32B生成基于数据集的问答对
- 使用Qwen-Coder-480B生成代码/思考执行轨迹
- 使用E2B进行安全沙箱执行
技术工具
- Datatrove:大规模处理Kaggle笔记本和数据集
- Qwen-32B:评分和问答生成
- Qwen-Coder-480B:笔记本和代码执行轨迹生成
- E2B:安全沙箱执行
许可信息
- 数据集使用Apache-2.0许可证
- 使用引用的Kaggle笔记本或数据集必须遵守Kaggle服务条款和原始作者许可
引用信息
@misc{jupyteragentdataset, title={Jupyter Agent Dataset}, author={Baptiste Colle and Hanna Yukhymenko and Leandro von Werra}, year={2025} }