Hamana0509/UIT-VSMEC
收藏资源简介:
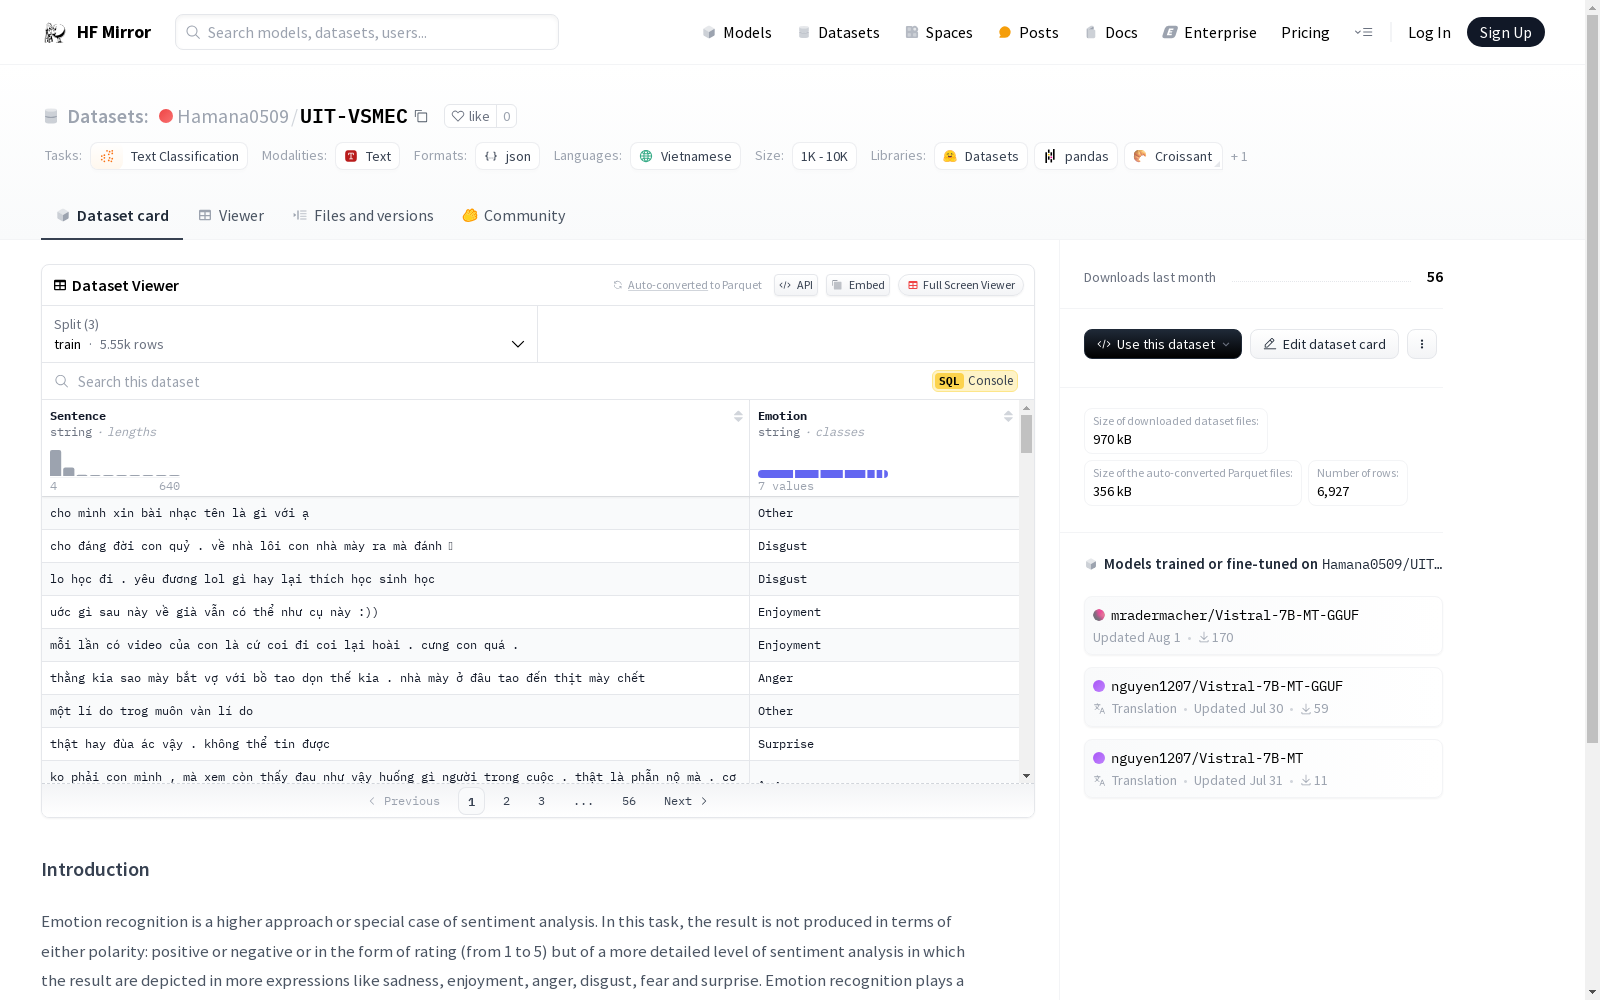
--- task_categories: - text-classification language: - vi size_categories: - 1K<n<10K --- # Introduction Emotion recognition is a higher approach or special case of sentiment analysis. In this task, the result is not produced in terms of either polarity: positive or negative or in the form of rating (from 1 to 5) but of a more detailed level of sentiment analysis in which the result are depicted in more expressions like sadness, enjoyment, anger, disgust, fear and surprise. Emotion recognition plays a critical role in measuring brand value of a product by recognizing specific emotions of customers’ comments. In this study, we have achieved two targets. First and foremost, we built a standard Vietnamese Social Media Emotion Corpus (UIT-VSMEC) with about 6,927 human-annotated sentences with six emotion labels, contributing to emotion recognition research in Vietnamese which is a low-resource language in Natural Language Processing (NLP). Secondly, we assessed and measured machine learning and deep neural network models on our UIT-VSMEC. As a result, Convolutional Neural Network (CNN) model achieved the highest performance with 57.61% of F1-score.
任务类别: - 文本分类(text-classification) 语言: - 越南语(vi) 样本量范围: - 样本数量介于1000至10000之间 # 引言 情感识别是情感分析(sentiment analysis)的高阶范式或特殊子任务。与仅以极性(积极/消极)或评分(1至5分)作为输出结果的任务不同,本任务属于更细粒度的情感分析范畴,其输出结果以更丰富的情绪类别呈现,具体包括悲伤、愉悦、愤怒、厌恶、恐惧与惊讶。通过识别用户评论中的特定情绪,情感识别可在产品品牌价值评估中发挥关键作用。 本研究达成两项核心目标:其一,构建了标准化的越南语社交媒体情感语料库(UIT-VSMEC),包含约6927条经人工标注的句子,涵盖6种情绪标签,为自然语言处理(Natural Language Processing,简称NLP)领域内低资源语言越南语的情感识别研究提供了重要支撑。其二,基于所构建的UIT-VSMEC语料库,我们对机器学习与深度神经网络模型开展了评估与性能测试。实验结果显示,卷积神经网络(Convolutional Neural Network,简称CNN)取得了最优性能,其F1值达到57.61%。
数据集概述
任务类别
- 文本分类
语言
- 越南语
数据规模
- 1K<n<10K
数据集介绍
情感识别是情感分析的一种高级方法或特殊情况。在这项任务中,结果不是以极性(正面或负面)或评分形式(从1到5)呈现,而是以更详细的情感分析级别呈现,结果以悲伤、享受、愤怒、厌恶、恐惧和惊讶等更丰富的表达形式呈现。情感识别在通过识别客户评论的特定情感来衡量产品品牌价值方面起着关键作用。在本研究中,我们实现了两个目标。首先,我们构建了一个标准的越南社交媒体情感语料库(UIT-VSMEC),包含约6,927个人工标注的句子,带有六个情感标签,为越南语这一自然语言处理(NLP)中的低资源语言的情感识别研究做出了贡献。其次,我们在UIT-VSMEC上评估和测量了机器学习和深度神经网络模型。结果显示,卷积神经网络(CNN)模型以57.61%的F1分数取得了最高性能。