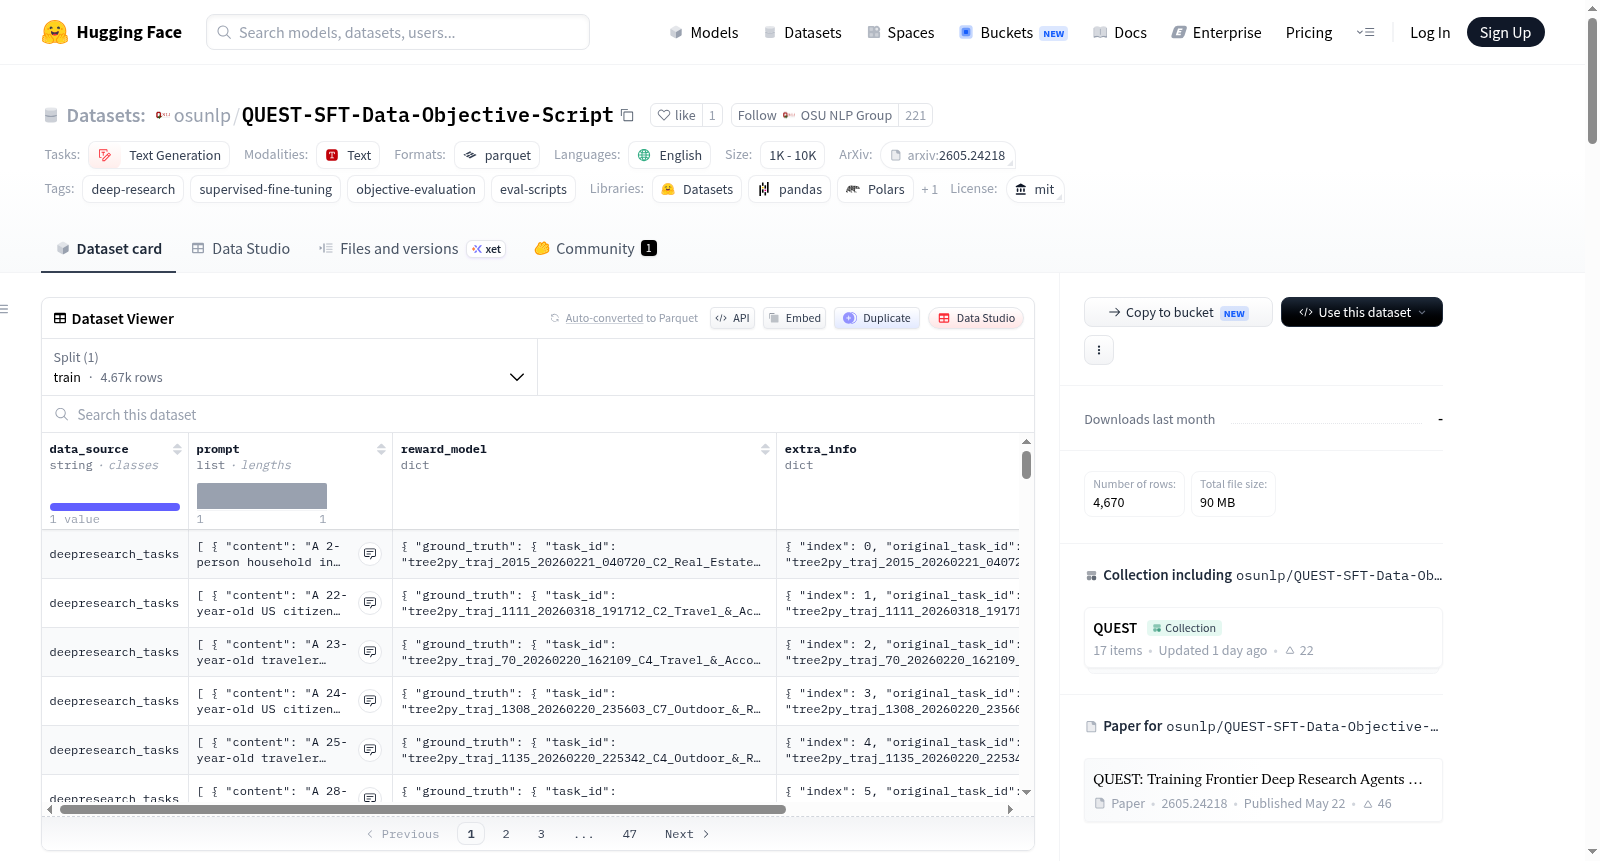
QUEST-SFT-Data-Objective-Script
收藏资源简介:
QUEST SFT Data Objective Script 是一个用于QUEST/DeepResearch目标任务的监督微调(SFT)数据集。该数据集专门为客观评估任务设计,每个数据样本包含一个SFT对话、从中提取的真实用户问题,以及对应的Python目标评估脚本。数据集遵循与QUEST-RL-Data类似的宽泛模式,包含prompt、reward_model、extra_info和rl_task_category等字段,并额外增加了messages、question、eval_script、eval_script_path和eval_script_sha256等关键列,用于完整记录对话、问题和评估脚本的对应关系及验证信息。数据集规模为4,670个已发布样本,来源于5,070个唯一源问题,另有410个因中间文件被意外删除而无法验证对应关系的问题未被包含在内。数据集适用于训练和评估能够执行深度研究、回答客观问题的大型语言模型,特别是那些需要基于给定脚本进行自动化客观评估的任务。使用本数据集时,需要同时下载配套的eval_scripts/目录下的Python评估脚本,并确保正确配置PYTHONPATH以导入QUEST代码库中的评估框架(obj_task_eval)。
QUEST SFT Data Objective Script is a supervised fine-tuning (SFT) dataset for QUEST/DeepResearch objective tasks. The dataset is specifically designed for objective evaluation tasks, with each data sample containing an SFT dialogue, the real user question extracted from it, and the corresponding Python objective evaluation script. The dataset follows a broad pattern similar to QUEST-RL-Data, including fields such as prompt, reward_model, extra_info, and rl_task_category, and adds key columns like messages, question, eval_script, eval_script_path, and eval_script_sha256 to fully record the correspondence and verification information between dialogues, questions, and evaluation scripts. The dataset consists of 4,670 published samples derived from 5,070 unique source questions, with an additional 410 questions not included due to the accidental deletion of intermediate files preventing verification of correspondence. It is suitable for training and evaluating large language models capable of performing deep research and answering objective questions, particularly those requiring automated objective evaluation based on given scripts. When using this dataset, it is necessary to download the accompanying Python evaluation scripts from the eval_scripts/ directory and ensure proper configuration of PYTHONPATH to import the evaluation framework (obj_task_eval) from the QUEST codebase.
数据集概述:QUEST SFT Data Objective Script
该数据集是 QUEST / DeepResearch 项目中用于监督微调(SFT) 的客观任务数据子集。它包含了SFT对话、提取的用户问题以及对应的客观评估脚本。
- 许可证: MIT
- 语言: 英语
- 任务类别: 文本生成
- 数据规模: 1K < n < 10K(共4,670行)
- 数据文件: 单个Parquet文件 (
data/train.parquet)
主要特征
该数据集遵循与 osunlp/QUEST-RL-Data 相似的宽模式,并额外增加了以下关键列:
| 列名 | 描述 |
|---|---|
prompt |
包含提取问题的聊天式输入(list[{"role", "content"}])。 |
messages |
原始的SFT对话消息。 |
question |
提取出的真实用户问题(已移除附加的研究状态/历史)。 |
eval_script |
完整的Python客观评估脚本文本。 |
eval_script_path |
该评估脚本在数据集仓库中的路径。 |
eval_script_sha256 |
评估脚本内容的SHA-256哈希值。 |
reward_model |
指向客观脚本的奖励配置。 |
rl_task_category |
始终为 "objective"。 |
数据规模与匹配
- 发布行数: 4,670
- 考虑的独特源问题: 5,070
- 评估脚本数量: 4,670个(位于
eval_scripts/目录下,均为.py文件) - 未发布的源问题: 410个(因中间文件意外丢失,无法验证问题与脚本的对应关系)
匹配流程: 通过SFT任务ID与脚本文件名匹配、评估脚本源代码或Python字符串常量中精确匹配问题文本、以及轨迹JSON文件名匹配等至少一种方式,确认问题与脚本的对应关系。
数据加载
该数据集可通过 datasets 库加载,支持流式和非流式模式,也可直接读取Parquet文件。
- 流式加载(低内存):
load_dataset("osunlp/QUEST-SFT-Data-Objective-Script", split="train", streaming=True) - 非流式加载(全量加载):
load_dataset("osunlp/QUEST-SFT-Data-Objective-Script", split="train") - 下载评估脚本:
可使用
snapshot_download函数下载eval_scripts/*.py文件,确保SFT行与对应脚本一起使用。
评估脚本说明
评估脚本基于 obj_task_eval 框架,该框架在 QUEST 代码库的 training_scripts/rl/recipe/deepresearch/obj_task_eval 目录下。运行这些脚本需要将相应路径添加到 PYTHONPATH,以便导入 Evaluator、AggregationStrategy 等模块。