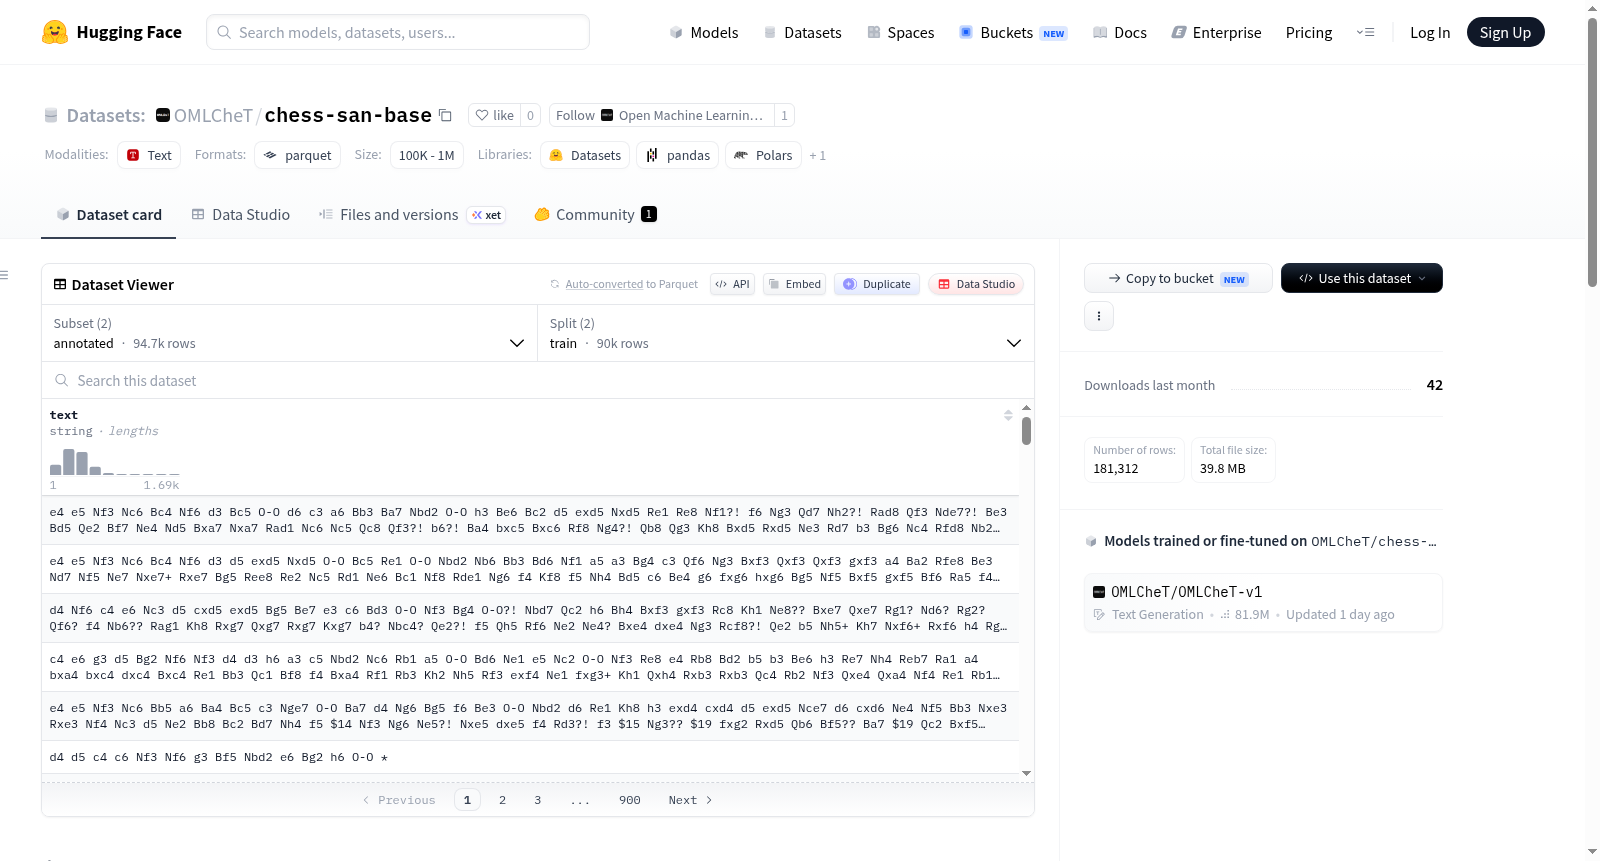
chess-san-base
收藏资源简介:
OMLCheT Chess SAN Base数据集是一个专为训练轻量级语言模型和强化学习代理而设计的国际象棋对局序列数据集,采用纯标准代数记谱法格式。数据来源于Lichess/tournament-chess-games仓库的高质量对局,移除了元数据、时间戳、时钟评估标记和步数编号,以提供简洁的棋步序列。数据集包含两个独立配置:clean配置提供原始、严格合法的棋步字符串,适用于基础文本生成模型或需要无错误句法移动历史的强化学习设置;annotated配置保留人类评估标记(如?!、?、!!)和数字注释标记(如$14、$19),使高级模型能够学习上下文战术评估。数据集分为训练集和测试集,其中annotated配置包含89,976个训练样本和4,736个测试样本,clean配置包含82,270个训练样本和4,330个测试样本。每个样本仅包含一个文本字段,存储棋步序列。该数据集适用于国际象棋移动预测、游戏生成、战术分析等任务,旨在促进机器学习在棋类游戏中的应用。
The OMLCheT Chess SAN Base dataset is designed for training lightweight language models and reinforcement learning agents, focusing on chess game sequences in pure Standard Algebraic Notation format. It sources high-quality games from the Lichess/tournament-chess-games repository, removing metadata, timestamps, clock evaluation markers, and move numbers to provide concise move sequences. The dataset includes two configurations: the clean configuration offers raw, strictly legal move strings suitable for basic text generation models or reinforcement learning settings requiring error-free syntactic move histories; the annotated configuration retains human evaluation markers (e.g., ?!, ?, !!) and numeric annotation markers (e.g., $14, $19), enabling advanced models to learn contextual tactical assessments. It is split into training and test sets, with the annotated configuration containing 89,976 training samples and 4,736 test samples, and the clean configuration containing 82,270 training samples and 4,330 test samples. Each sample consists of a single text field storing the move sequence. The dataset is suitable for tasks like chess move prediction, game generation, and tactical analysis, aiming to promote the application of machine learning in board games.
数据集概述:OMLCheT Chess SAN Base
这是一个为训练轻量级语言模型(LMs)和强化学习(RL)代理而设计的国际象棋棋局序列数据集,所有棋步均使用标准代数记法(SAN)。数据源自 Lichess/tournament-chess-games 仓库中的高质量对局,并已去除元数据、时间戳、时钟评估标记和棋步编号。
数据集配置
该数据集包含两个独立的子集,每个子集都有独立的训练/测试划分。
-
clean配置- 内容: 仅包含严格合法的纯棋步字符串,无任何注释。
- 用途: 适用于基础文本生成模型或需要错误语法棋步历史的强化学习设置。
- 示例:
e4 e5 Nf3 Nc6 Bc4 Nf6 d3 Bc5 O-O d6 c3 a6
-
annotated配置- 内容: 保留了人类评估符号(如
?!,?,!!)和数字注释字形(NAGs,如$14,$19)。 - 用途: 允许高级模型学习上下文战术评估,例如识别被标记为错误或优势的棋步。
- 示例:
Nf1?! d5 c4 e6 Nc3 Nf6 Nf3 Be7 Bf4 O-O e3 c5 Bg5 #5 $14
- 内容: 保留了人类评估符号(如
数据规模与划分
| 配置 | 训练集行数 | 测试集行数 | 总行数 |
|---|---|---|---|
annotated |
89,976 | 4,736 | 94,712 |
clean |
82,270 | 4,330 | 86,600 |
注意: clean 配置的行数略少,原因是在严格解析过程中,少数短对局或带有大量注释的求和棋谱被过滤掉了。
数据特征
所有配置均只包含一个特征:
text:字符串类型,存储棋局序列文本。
快速加载
可通过 Hugging Face datasets 库直接加载:
python from datasets import load_dataset
加载纯棋步数据
dataset_pure = load_dataset("OMLCheT/chess-san-base", "clean")
加载带评估注释的数据
dataset_eval = load_dataset("OMLCheT/chess-san-base", "annotated")