
遇见数据集

MA-tokenweights/all-the-news-2-tfidf-invfreq-topic-stratified-v1-articles

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

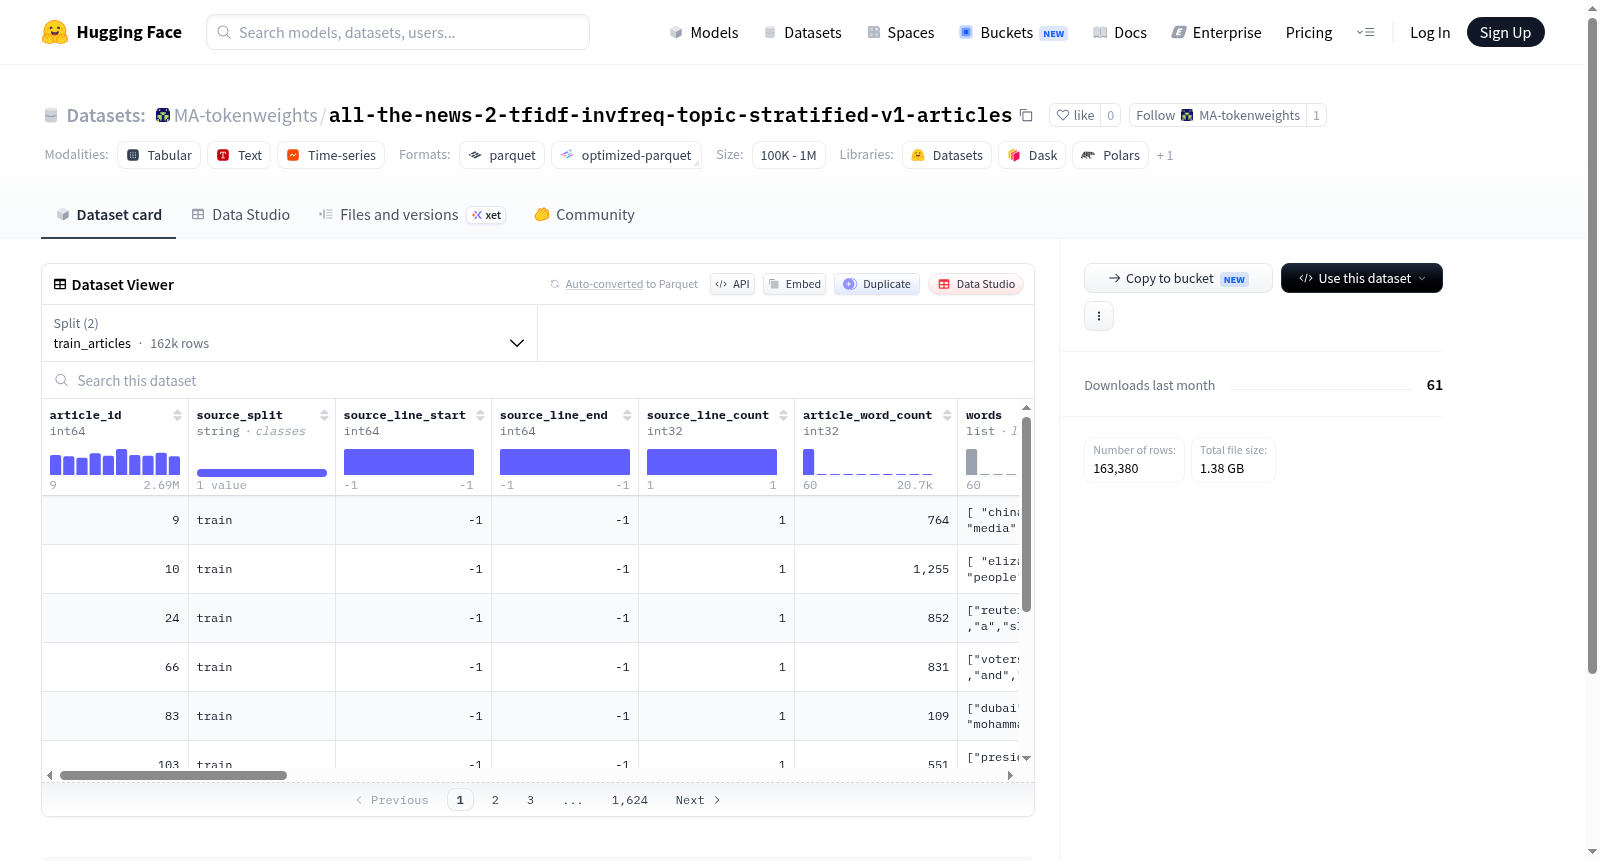
--- dataset_info: features: - name: article_id dtype: int64 - name: source_split dtype: string - name: source_line_start dtype: int64 - name: source_line_end dtype: int64 - name: source_line_count dtype: int32 - name: article_word_count dtype: int32 - name: words list: string - name: tf_idf_scores list: float32 - name: token_ids list: int32 - name: token_weights list: float32 - name: article_token_count dtype: int32 - name: article_text dtype: string - name: meta_idx dtype: string - name: meta_article_idx dtype: string - name: meta_title dtype: string - name: meta_publication dtype: string - name: meta_date dtype: string - name: meta_url dtype: string - name: meta_section dtype: string splits: - name: train_articles num_bytes: 2587829773 num_examples: 162393 - name: validation_articles num_bytes: 40515683 num_examples: 987 download_size: 1384843986 dataset_size: 2628345456 configs: - config_name: default data_files: - split: train_articles path: data/train_articles-* - split: validation_articles path: data/validation_articles-* ---

This is a news article dataset containing article IDs, source splits, start and end line numbers, line counts, word counts, word lists, TF-IDF scores, token IDs, token weights, token counts, full article texts, and metadata (such as index, article index, title, publication, date, URL, and section). The data is divided into training articles and validation articles, suitable for natural language processing tasks like text analysis, keyword extraction, and information retrieval.
提供机构:
MA-tokenweights
搜集汇总
数据集介绍
MA-tokenweights/all-the-news-2-tfidf-invfreq-topic-stratified-v1-articles 数据集图片
构建方式
该数据集以大规模新闻语料库‘All the News 2’为基础,通过TF-IDF算法对每篇文章进行向量化表征,并依据逆文档频率加权后的词项重要性进行主题分层抽样,最终构建出具有均衡主题分布的新闻文章集合。数据集中每个样本不仅包含原始文本与元数据,还存储了词项、TF-IDF分数、分词后的token标识符及其权重,为后续文本分析提供了多层次的结构化信息。
特点
数据集涵盖162,393篇训练样本与987篇验证样本,总数据量超过2.6GB,规模宏大。每个样本均包含文章的唯一标识、来源分割信息、词与token计数、TF-IDF得分序列以及完整的元数据(如标题、出版物、日期、URL和板块),这使得研究者能够从词汇分布、主题权重、时间跨度等多维度对新闻内容进行深入挖掘,兼顾了微观的词项特征与宏观的语料结构。
使用方法
数据集以HuggingFace Datasets库的格式托管,用户可通过加载‘train_articles’与‘validation_articles’两个分割直接使用。所有特征字段如‘words’、‘tf_idf_scores’、‘token_ids’等均可作为模型输入,特别适用于主题建模、文本分类、信息检索等自然语言处理任务。同时,丰富的元数据字段支持对新闻来源、发布时间等进行过滤与切片,便于构建针对性的实验子集。
背景与挑战
背景概述
在自然语言处理与信息检索领域,新闻文本作为高时效性、多主题且富含社会信息的语料,一直是文本挖掘与机器学习研究的重点对象。all-the-news-2-tfidf-invfreq-topic-stratified-v1-articles数据集发布于近年来,由关注新闻语料表征优化的研究团队构建,其核心研究问题在于如何在大规模多源新闻文本中,实现基于TF-IDF与逆文档频率的主题分层抽样,从而获得更具代表性的子集用于下游任务。该数据集整合了来自多家出版物的历史新闻文章,经预处理后提供了词序列、TF-IDF分数及分层后的训练与验证划分,对提升新闻文本分类、主题建模与信息检索等研究的可复现性与统计稳健性具有显著推动作用。
当前挑战
该数据集所解决的领域挑战主要体现在两方面。其一,新闻数据天然存在主题分布极不均衡与噪声严重的问题,传统随机采样容易导致少数主题被忽视,构建过程中需设计有效的主题分层策略以确保各主题在子集中得到合理呈现。其二,大规模新闻语料的预处理面临存储与计算效率的双重压力,从原始文本到TF-IDF稀疏表示及主题分层的转换,涉及特征维度膨胀与内存瓶颈,本数据集通过预计算词级TF-IDF权重并进行分层存储,部分缓解了在后续分析中反复计算的开销,但如何在保持低冗余的同时保留语义连贯性,仍是此类数据集构建中的持续挑战。
常用场景
经典使用场景
该数据集汇聚了来自多家主流新闻媒体的海量英文文章,经过TF-IDF向量化与主题分层处理,为自然语言处理领域提供了一份兼具广度与深度的文本资源。其最经典的使用场景当属文本分类与主题建模研究,研究者可借助文章内嵌的TF-IDF特征与主题分布信息,训练出能够精准识别新闻所属板块或主题类别的模型,从而在纷繁复杂的舆论场中快速梳理出信息脉络。
衍生相关工作
围绕这一数据集,衍生出诸多具有影响力的经典工作。在文本表示学习方面,研究者以此为基础训练了用于新闻主题分类的轻量级神经网络模型;在可解释人工智能领域,基于TF-IDF特征解析模型决策路径的研究也借力于此;此外,将新闻文本与动态时间序列结合的舆情演化预测模型同样取材于该语料,充分彰显了其作为基准数据集的广泛兼容性。
数据集最近研究
最新研究方向
该数据集汇聚了来自多源新闻刊物的海量文本,并基于TF-IDF与逆文档频率特征进行了主题分层处理,为新闻语料的语义挖掘与主题建模提供了高质量支撑。当前前沿研究聚焦于利用此类结构化语料库推动新闻事件的自动摘要、跨域情感分析以及社会舆论趋势预测,尤其是在虚假信息检测与媒体立场识别等热点议题上展现出重要价值。通过词频-逆文档频率加权的词元表征,研究者能够更精准地捕捉新闻报道的主题演变与关键实体关联,从而助力生成式模型在新闻内容理解与事实一致性核查方面取得突破。这一数据集的出现,不仅丰富了大规模多源新闻分析的实验基底,也为计算社会科学中的舆情动态监测与新闻叙事结构解析奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

