
遇见数据集

abnerh/TORGO-database

收藏
Hugging Face2024-11-29 更新2024-12-14 收录
官方服务:

资源简介:

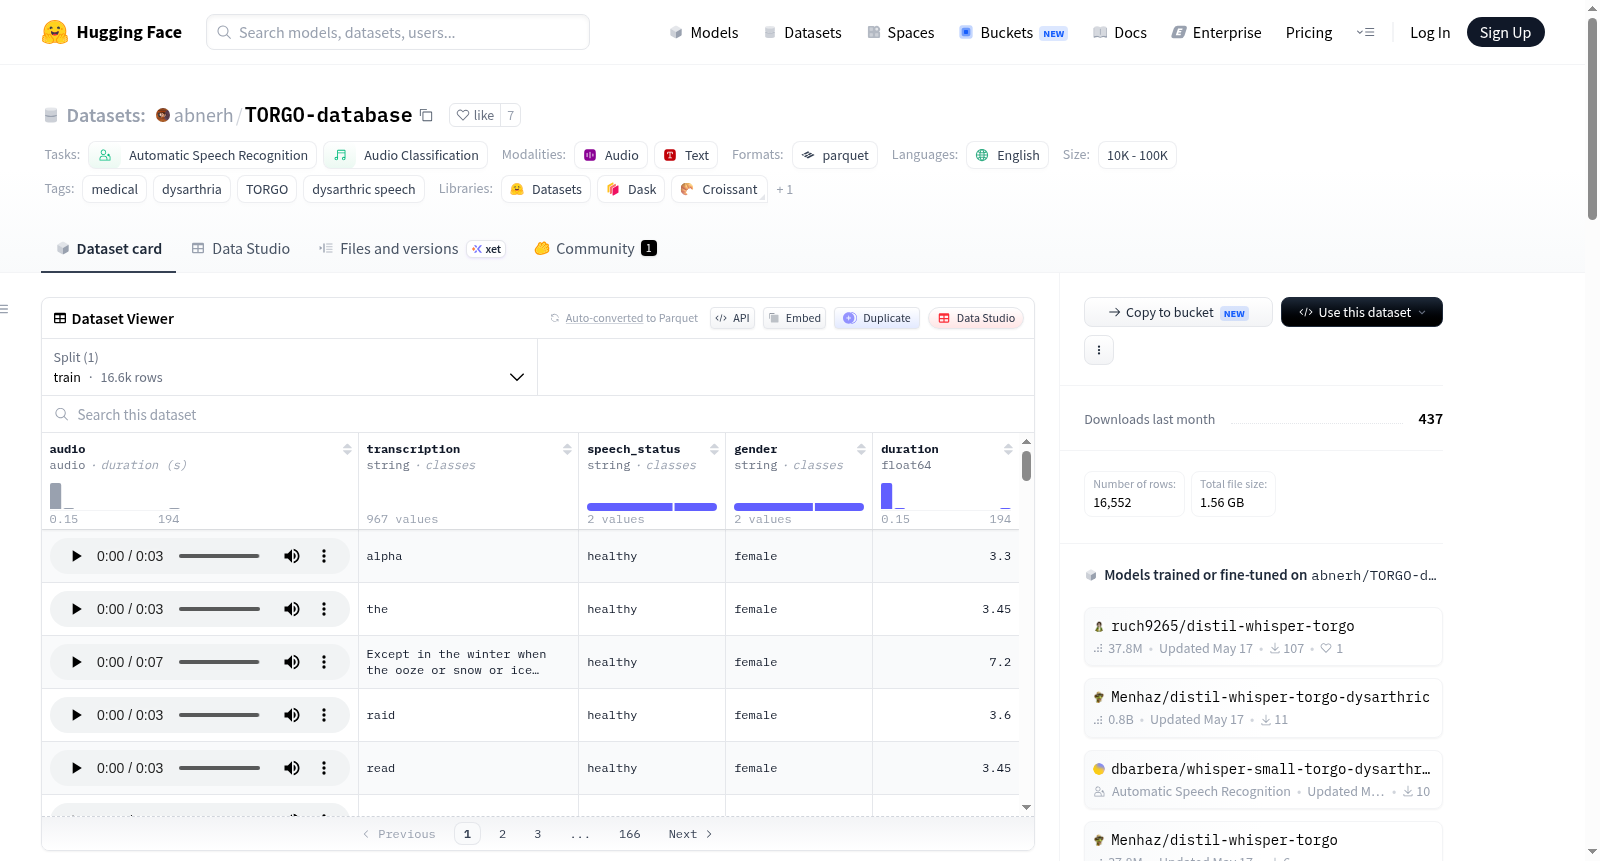
TORGO数据库包含发音障碍患者和健康人的语音数据,数据包括音频文件路径、转录文本、语音状态(健康或发音障碍)、性别和音频时长等信息。数据集主要用于自动语音识别(ASR)和音频分类任务。语音内容包括短词和受限句子,这些内容有助于研究语音声学特征和语音识别技术。数据集的结构包括音频文件路径和转录文本,以及额外的字段如性别、语音状态和时长。数据集的下载和使用是免费的,但要求在使用时引用相关的研究论文。

The TORGO database contains speech data from individuals with dysarthria and healthy controls, including audio file paths, transcriptions, speech status (healthy or dysarthric), gender, and audio duration. The dataset is primarily used for automatic speech recognition (ASR) and audio classification tasks. The speech content includes short words and restricted sentences, which are useful for studying speech acoustics and speech recognition technologies. The dataset structure includes audio file paths and transcriptions, along with additional fields such as gender, speech status, and duration. The dataset is free to download and use, but requires citation of relevant research papers when used in publications.
提供机构:
abnerh
搜集汇总
数据集介绍
abnerh/TORGO-database 数据集图片
构建方式
TORGO数据库专注于构音障碍语音的声学与发音特征研究,其构建源自多伦多大学团队对构音障碍及健康说话者的系统性采集。该数据集精选了短词与受限句子的语音片段,涵盖约5.5小时构音障碍语音与8小时健康语音。短词部分包括英语数字、指令词、国际无线电字母表、Frenchay构音障碍评估及Yorkston-Beukelman可懂度测试中的词汇,以及英国国家语料库高频词。受限句子则纳入了富含音素的预设句、祖父段落、Yorkston-Beukelman句子可懂度测试句及MOCHA-TIMIT数据库中的TIMIT衍生句,旨在支持语音识别中的词汇、句法和语义处理。
特点
该数据集的核心特点在于其针对构音障碍语音的精细标注与结构化设计。每个数据点包含音频文件路径、转录文本、说话者性别、语音状态(构音障碍或健康)及音频时长,便于多维度分析。音频文件命名规则编码了说话者编号、会话次数、麦克风类型及话语序号,确保了数据的可追溯性。数据集未预设开发集与测试集划分,以适应用户自定义的实验需求。此外,转录文本已标准化处理(去除标点、保留大小写),并剔除了仅含'xxx'的无效样本,提升了数据质量。
使用方法
研究者可通过HuggingFace的datasets库便捷加载该数据集,使用`load_dataset('abnerh/TORGO-database')`即可获取包含16552条样本的训练集。每条样本以字典形式返回音频数组、采样率(16kHz)、转录文本、性别、语音状态及时长信息。该数据集适用于自动语音识别与音频分类任务,尤其适合构音障碍语音的声学建模与可懂度评估研究。用户可依据speech_status字段筛选构音障碍或健康语音子集,或利用gender字段进行性别相关的语音分析。学术用途免费,使用时需引用相关文献。
背景与挑战
背景概述
TORGO数据库是由多伦多大学的研究人员Frank Rudzicz、Graeme Hirst和Pascal van Lieshout等人于2012年创建的专业语音资源,专注于构音障碍患者(如脑瘫患者)的发音与声道运动数据采集。该数据库的核心研究问题在于探索构音障碍语音的声学特征与发音机制,为开发高鲁棒性的自动语音识别(ASR)系统提供基础数据支持。TORGO数据库包含了约5.5小时的构音障碍语音和8小时的健康对照语音,涵盖短词、受限句子以及非词和自由句子等多种语料类型,其独特之处在于同时记录了声学信号和声道运动数据(如电磁发音描记)。这一数据集在言语病理学、辅助技术以及人机交互领域产生了深远影响,成为研究构音障碍语音识别和发音障碍诊断的重要基准资源,推动了针对特殊人群的语音技术发展。
当前挑战
TORGO数据库所解决的领域问题主要集中在构音障碍语音的自动识别与理解,这类语音因发音不清晰、变异性高而给传统ASR系统带来巨大挑战。具体挑战包括:1) 构音障碍语音的声学特征与健康语音存在显著差异,如发音时间延长、音素替换和省略,导致标准声学模型泛化能力不足;2) 数据集构建过程中面临多重困难,例如招募不同严重程度的构音障碍受试者(如脑瘫患者)并确保数据的多样性和代表性,同时需要同步采集高精度的声道运动数据(如使用电磁发音仪),增加了实验复杂性和成本;3) 转录标注的一致性维护,特别是对不清晰发音的准确转写,需要专业言语病理学家的参与,而不同标注者之间可能存在主观偏差。这些挑战使得TORGO数据库成为评估构音障碍语音处理算法鲁棒性的关键测试平台。
常用场景
经典使用场景
TORGO数据库作为构音障碍语音领域的标杆性资源,其经典使用场景集中于基于深度学习的自动语音识别(ASR)系统的鲁棒性评估与优化。该数据集精心收录了构音障碍患者与健康对照者的短词与受限语句语音,涵盖清晰标注的音频、文本转写及说话人属性,为研究者提供了探究非典型发音模式对声学-语言映射关系影响的理想实验平台。通过对比分析构音障碍语音与正常语音在声学特征空间中的分布差异,学者们能够系统性地评估传统ASR模型在面对发音变异时的性能退化程度,进而设计更具包容性的声学模型架构。
衍生相关工作
围绕TORGO数据库已衍生出多项具有里程碑意义的经典工作。Rudzicz等人基于该数据集率先提出声道几何参数在构音障碍语音识别中的表征方法,揭示了发音器官运动受限对声道传递函数的非线性调制规律。后续研究进一步拓展了该数据集的学术边界,包括基于生成对抗网络的构音障碍语音增强技术、利用注意力机制的端到端声学模型架构,以及融合多模态发音运动数据的说话人自适应方法。这些工作不仅深化了对病理语音生成机制的理解,更构建了从数据采集到算法验证的完整研究范式,使TORGO成为构音障碍语音处理领域不可或缺的基准测试平台。
数据集最近研究
最新研究方向
TORGO数据库作为构音障碍语音研究的标杆资源,当前前沿方向聚焦于将多模态声学与发音特征融入端到端自动语音识别系统,以应对非典型发音的变异性挑战。结合深度学习中的自监督预训练模型与迁移学习策略,研究者致力于提升对脑瘫等神经运动障碍患者语音的鲁棒识别能力。近期热点事件包括可及性辅助技术的快速发展,如基于该数据库开发的语音控制界面,显著改善了运动障碍人士的交互体验。该数据库在推动临床语音评估标准化、促进人机交互包容性方面具有深远影响,为构建更具普适性的语音技术奠定了基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

