
BleachNick/MIC_full
收藏官方服务:
资源简介:
--- license: unknown --- ```bibtex @misc{zhao2023mmicl, title={MMICL: Empowering Vision-language Model with Multi-Modal In-Context Learning}, author={Haozhe Zhao and Zefan Cai and Shuzheng Si and Xiaojian Ma and Kaikai An and Liang Chen and Zixuan Liu and Sheng Wang and Wenjuan Han and Baobao Chang}, year={2023}, eprint={2309.07915}, archivePrefix={arXiv}, primaryClass={cs.CL} } ```
许可证:未知 bibtex @misc{zhao2023mmicl, title={MMICL: 借助多模态上下文学习(Multi-Modal In-Context Learning)赋能视觉语言模型(Vision-language Model)}, author={赵浩哲、蔡泽凡、施舒政、马晓健、安恺恺、陈亮、刘子轩、王盛、韩文娟、常宝宝}, year={2023}, eprint={2309.07915}, archivePrefix={arXiv}, primaryClass={cs.CL(计算机科学 - 计算语言学)} }
提供机构:
BleachNick原始信息汇总
数据集概述
数据集名称
MMICL: Empowering Vision-language Model with Multi-Modal In-Context Learning
作者
- Haozhe Zhao
- Zefan Cai
- Shuzheng Si
- Xiaojian Ma
- Kaikai An
- Liang Chen
- Zixuan Liu
- Sheng Wang
- Wenjuan Han
- Baobao Chang
年份
2023
相关信息
- 预印本编号: 2309.07915
- 存档前缀: arXiv
- 主要类别: cs.CL
许可
未知
搜集汇总
数据集介绍
背景与挑战
背景概述
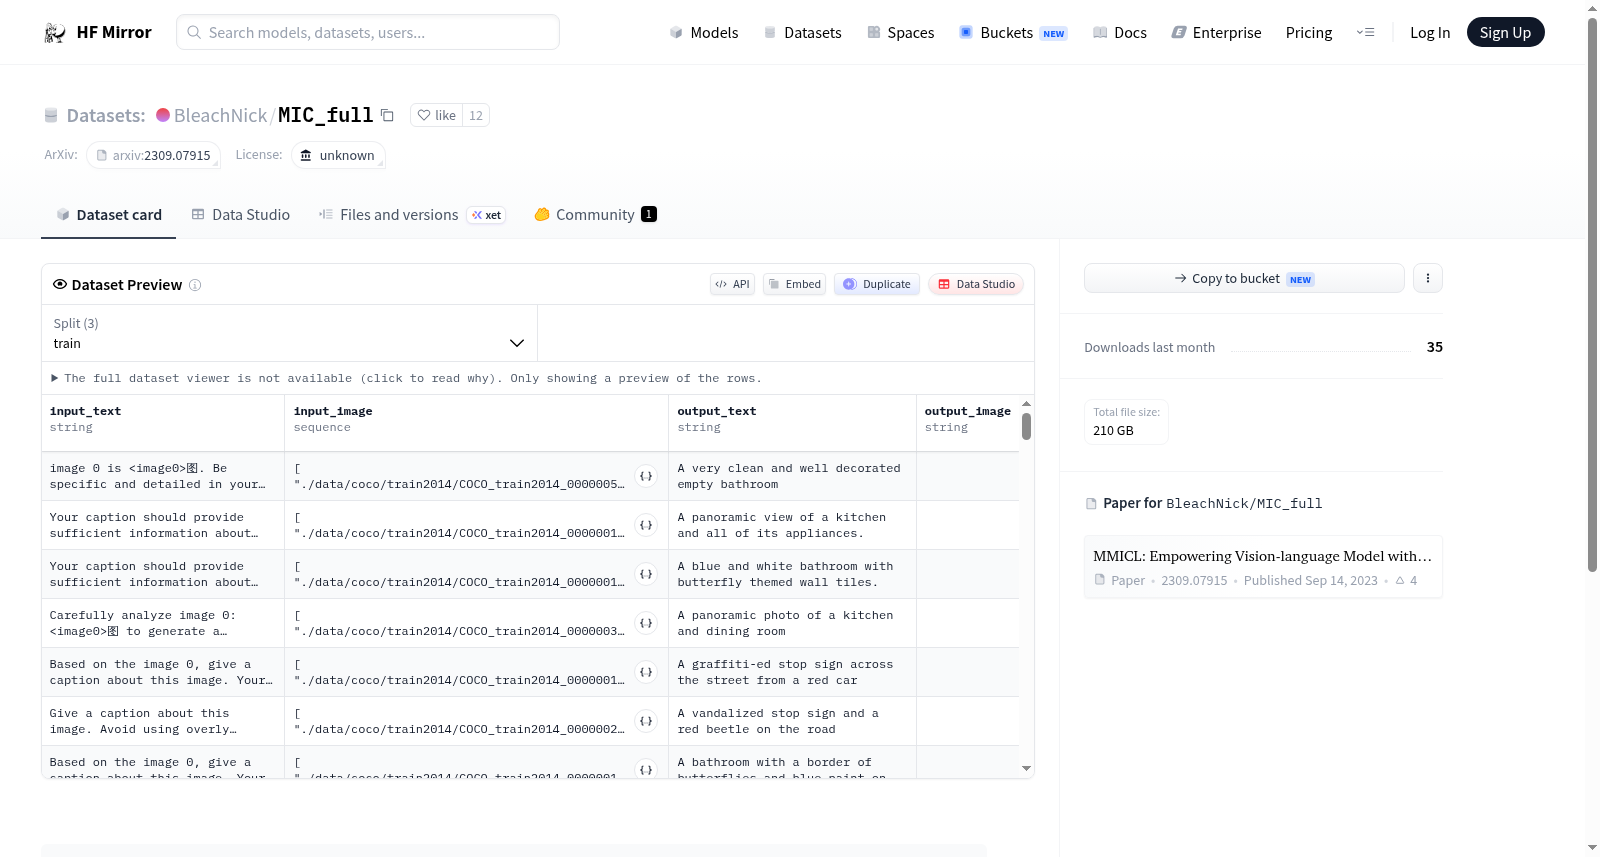
该数据集是一个多模态视觉-语言数据集,用于支持上下文学习任务,包含文本指令和对应的图像路径作为输入,以及生成的文本描述作为输出。数据基于COCO数据集图像,总大小约210GB,但存在数据生成错误,可能导致部分数据无法正常加载。
以上内容由遇见数据集搜集并总结生成


