
遇见数据集

wuqi28/Knowledge-Tracing-QA-Chinese

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

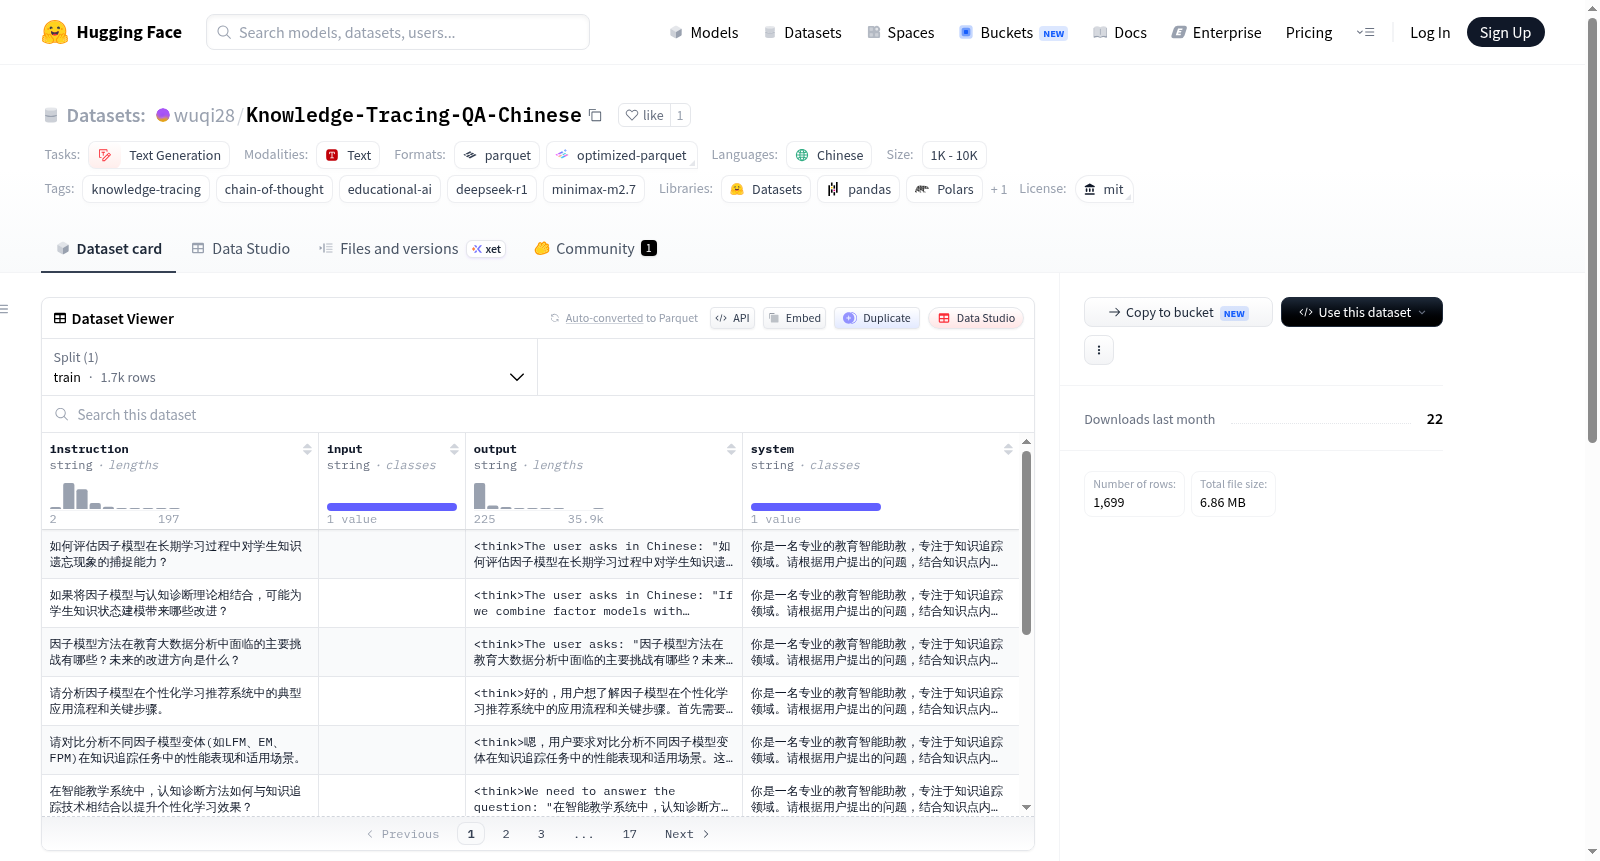
这是一个用于知识追踪(KT)领域的高质量思维链(CoT)微调数据集,采用标准JSONL格式。每条数据包含四个核心字段:system(动态系统提示词,用于锚定模型在知识追踪、智能教育或数据挖掘领域的专家身份)、instruction(核心交互指令,涵盖知识追踪领域的模型评估方法、公式推导、算法对比等高难度专业问题)、input(补充上下文或外部输入数据,如学生答题序列,若无可为空字符串)以及output(黄金标准回复,全量包含原生推理思维链,包裹在`<think>...</think>`标签内,并输出极高质量的结构化学术级解答)。数据集旨在支持大模型在知识追踪相关任务中的微调,提升其专业问答和推理能力。

This is a high-quality Chain-of-Thought (CoT) fine-tuning dataset for the Knowledge Tracing (KT) domain, in standard JSONL format. Each data entry contains four core fields: system (dynamic system prompt to anchor the models expert identity in knowledge tracing, educational AI, or data mining), instruction (core interaction instruction covering high-difficulty professional problems in KT such as model evaluation methods, formula derivation, and algorithm comparison), input (supplementary context or external input data, e.g., student answer sequences, empty if not available), and output (gold-standard response, fully including native reasoning chain-of-thought wrapped in `<think>...</think>` tags, followed by extremely high-quality structured academic-level answers). The dataset is designed to support fine-tuning of large models for knowledge tracing-related tasks, enhancing their professional question-answering and reasoning capabilities.
提供机构:
wuqi28
搜集汇总
数据集介绍
wuqi28/Knowledge-Tracing-QA-Chinese 数据集图片
构建方式
该数据集以JSONL格式构建,每一行代表一条完整的专业问答或专家对话数据,包含四个核心字段:system、instruction、input和output。system字段提供了动态系统提示词,明确模型在知识追踪领域的专家身份;instruction字段包含知识追踪领域的高难度专业问题,涉及模型评估、公式推导、算法对比等;input字段补充上下文或外部输入数据,如学生答题序列;output字段则包含黄金标准回复,其中嵌入了原生的推理思维链标签。数据集共包含1699条训练样本,数据规模适中,且已按标准格式进行划分。
特点
数据集的核心特点在于其高质量的专业性和结构化设计。所有output均包含包裹在<think>标签内的原生推理思维链,随后输出结构化学术级解答,确保了回复的逻辑严谨性和可解释性。此外,数据集专注于知识追踪领域,覆盖模型评估方法、公式推导、算法对比等专家级内容,适合用于微调大型语言模型以提升其在教育智能领域的推理能力。数据集的字段设计动态化,通过system字段锚定模型身份,进一步增强了任务的针对性。
使用方法
该数据集适用于文本生成任务,特别是知识追踪领域的链式思维微调。用户可以将数据加载为标准JSONL格式,并结合深度学习框架进行模型训练。例如,在HuggingFace环境下,可使用datasets库读取train分片数据,并将instruction和input拼接后作为模型输入,output作为监督标签。训练时需注意保留<think>标签的结构,以强化模型的推理链生成能力。数据集的MIT许可协议允许自由使用,支持教育与研究场景下的微调实验。
背景与挑战
背景概述
该数据集创建于2025年,由教育人工智能领域的研究人员精心构建,旨在填补知识追踪(Knowledge Tracing)方向高质量中文推理链数据的空白。知识追踪作为智能教育系统的核心组件,致力于通过学生历史答题序列动态建模其知识状态演变。然而,现有数据集多聚焦于英文语境的简单预测任务,缺乏能够引导大语言模型进行复杂因果推理与多步骤分析的训练资源。Knowledge-Tracing-QA-Chinese通过整合因子模型遗忘能力评估、算法性能对比等专业问题,并将原生思维链(CoT)嵌入回复中,为教育大模型从“答案匹配”迈向“深度推理”提供了关键的微调基础。该数据集采用MIT开源协议发布,覆盖1K至10K量级的高质量问答对,其引入的专家级动态系统提示与结构化输出范式,为后续智能辅导系统的精准性与可解释性研究奠定了重要的数据基石。
当前挑战
该数据集所解决的领域问题是大语言模型在知识追踪场景中的深度推理能力缺失。传统知识追踪模型(如DKT、DKVMN)虽能预测学生表现,却难以生成可解释的推理过程,无法应对“为何遗忘发生”或“如何设计干预策略”等元认知问题。构建过程中的核心挑战包括:1)数据稀缺性——知识追踪领域的高质量中文专家对话难以获取,需依赖研究人员手动设计涵盖公式推导、模型对比的复杂指令集;2)推理链标注复杂性——确保每条回复包含完整的<think>标签内推理链条,且需平衡学术严谨性与可读性,例如针对“因子模型评估”问题需同时描述数据收集、遗忘度量定义及滚动窗口实验设计;3)字段对齐难题——动态system提示需精准锚定专家身份,instruction与output之间必须呈现严格的逻辑映射关系,以避免模型在微调时产生幻觉。
常用场景
经典使用场景
在智能教育领域,知识追踪旨在通过学生历史答题序列动态建模其知识状态演变,而该数据集专为大模型在知识追踪任务上的指令微调与思维链对齐而设计。其典型使用方式是将包含学生交互矩阵、习题特征等输入的指令输入模型,要求模型输出带有逐步推理过程的学术级解答,从而训练模型掌握知识状态预测、遗忘曲线建模等核心能力。数据集中的每一条样本均包含经过精心设计的系统提示、专业指令以及嵌套<think>标签的结构化思维链,为模型提供了从问题解析到最终结论的完整推理范式。
实际应用
在实际教育场景中,该数据集训练出的模型可深度集成至智能辅导系统与自适应学习平台,承担个性化知识诊断与学习路径规划的核心引擎角色。例如,当学生完成一组习题后,系统能自动生成包含知识点掌握度、遗忘风险区域及推荐复习内容的诊断报告,而模型输出的思维链可作为诊断依据的透明化解释,增强教育者的信任度。同时,该数据集的系统提示机制可灵活适配不同教学模式,支撑从K12学科辅导到高等教育专业训练的多层次应用,显著降低构建专属知识追踪模型的数据与算力成本。
衍生相关工作
基于此数据集,研究者已衍生出多个方向的前沿工作,包括将大模型与经典知识追踪模型(如DKT、DKVMN)进行协同集成,利用语言模型的语义理解能力增强交互序列的特征表达;以及探索强化学习与思维链推理的融合,使模型能基于当前知识状态动态生成下一道最优诊断习题。此外,该数据集还催生了跨语言知识追踪对齐研究,通过对比中英文数据下的思维链模式差异,揭示了知识追踪任务中语言无关的认知推理规律。这些工作共同推动了教育人工智能从“预测驱动”向“解释驱动”的范式转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

