
遇见数据集

ScholarScope-data

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

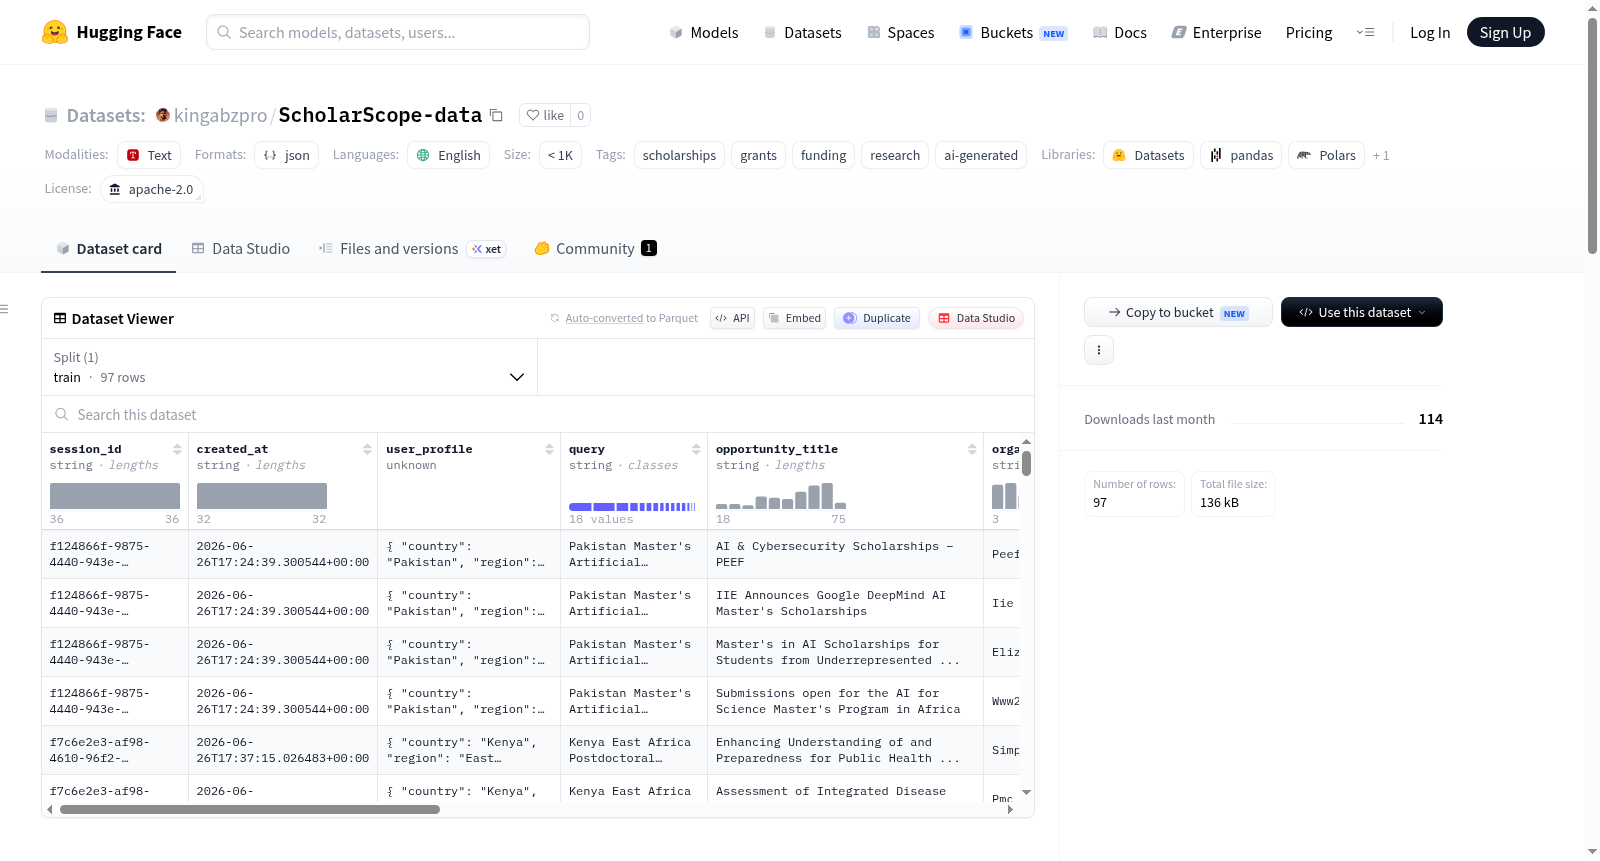
ScholarScope Data 是一个研究会话日志数据集,源自ScholarScope(一款AI驱动的资助与奖学金研究助手)。该数据集记录了为用户资金需求档案匹配并呈现的资助机会信息,包含约40个研究会话中的100多条机会记录。每条记录代表一个由ScholarScope流水线从实时网络资源中提取和排序的资助机会,以JSON Lines格式存储,并自动生成Parquet格式镜像。数据集语言为英语,采用Apache-2.0许可证。 记录字段包括:会话唯一标识符(session_id)、会话创建时间戳(created_at)、用户提交的四字段资金需求档案(user_profile,包含申请人来源国家/地区、教育水平、研究领域、研究/资金目标、资助类型、资金需求、额外资格限制、截止日期偏好等)、规范化搜索查询(query)、机会名称(opportunity_title)、组织(organization)、直接链接(source_url)、截止日期(deadline)、奖励金额(funding_amount)、AI生成的资格说明(eligibility_summary)、匹配度评分(match_score,0-100分)和AI生成的匹配理由摘要(reasoning_summary)。 数据来源于ScholarScope Space,每个研究会话仅记录评分最高的机会。AI生成的字段可能不准确或过时,截止日期可能为滚动或无明确日期;该数据集是操作性的研究日志数据,并非精心策划的基准数据集。

ScholarScope Data is a dataset containing research session logs from ScholarScope, an AI-driven funding and scholarship research assistant. It records information on funding opportunities matched and presented to users based on their funding need profiles. The dataset includes over 100 opportunity records from approximately 40 research sessions, each representing a funding opportunity extracted and ranked by the ScholarScope pipeline from real-time web sources. Data is stored in JSON Lines format with an automatically generated Parquet mirror. The dataset is in English and licensed under Apache-2.0. Each record contains fields such as session unique identifier (session_id), session creation timestamp (created_at), user-submitted four-field funding need profile (user_profile, including key information like applicants country/region, education level, research field, research/funding goals, funding type, funding needs, additional eligibility constraints, deadline preferences, and other preferences), normalized search query (query), opportunity title (opportunity_title), organization (organization), direct link to provider page (source_url), application deadline (deadline), funding amount (funding_amount), AI-generated short eligibility summary (eligibility_summary), match score (match_score, 0-100), and AI-generated reasoning summary (reasoning_summary). Data is sourced from ScholarScope Space, with only the highest-scoring opportunity recorded per research session. AI-generated fields may be inaccurate or outdated; deadlines may be rolling or unspecified; this dataset is operational research log data and not a curated benchmark dataset.

创建时间:
2026-06-27
搜集汇总
数据集介绍
ScholarScope-data 数据集图片
构建方式
ScholarScope-data数据集源自一款名为ScholarScope的智能奖学金与科研资助检索代理系统,其构建过程根植于对实时网络资源的动态采集与智能化处理。当用户提交涵盖国家、教育层次、研究领域、资金需求等多维度的资助画像后,系统自动将其转化为标准化的搜索查询,随后从活网络资源中批量提取潜在资助机会。每条记录对应一个研究会话中得分最高的机会,经由排序器赋以匹配度评分,并借助人工智能技术从资助方页面摘录截止日期、资助金额及资格摘要等关键元数据,最终以JSON Lines格式封装为97条运营研究日志。
特点
该数据集最显著的特点在于其真实性和动态性,忠实记录了ScholarScope系统在实际查询场景下的行为轨迹。每条记录不仅包含机会标题、主办机构、原始来源链接等结构化字段,更附有AI生成的资格说明与匹配理由摘要,辅以0至100的匹配度评分。user_profile子对象细致捕获了用户国别、教育层次、研究领域及资金诉求等多维偏好,使得数据集能够反映个性化检索的全貌。但需注意,AI生成字段可能存在时效性偏差,截止日期亦可能为滚动状态,要求使用者对源链接加以核实。
使用方法
研究者可借助HuggingFace Datasets库无缝加载该JSON Lines数据集,或利用自动生成的Parquet镜像进行高效分析。典型应用包括训练或微调面向奖学金检索的排序模型、验证AI驱动的资格推断管线、以及分析不同资助画像与匹配机会之间的关联模式。使用前应仔细审视match_score与reasoning_summary等AI生成字段的潜在误差,并建议结合source_url进行人工复核。数据集以Apache-2.0许可发布,适用于学术研究与工程原型搭建,但不宜作为经过人工校正的评测基准。
背景与挑战
背景概述
在学术资助与奖学金申请领域,研究者与学生们常面临信息碎片化与匹配效率低下的困境。为应对这一挑战,ScholarScope 数据集于近期由研究者 kingabzpro 及其团队构建,旨在通过人工智能代理技术,实现资助机会的智能化检索与个性化推荐。该数据集源自同名 AI 代理系统 ScholarScope 的真实运行日志,记录了 97 条资助机会记录,每条均包含用户档案、搜索查询、资助详情及匹配得分等信息。数据集以 Apache-2.0 许可公开,为学术资助匹配系统的研究提供了罕见的实地数据样本,推动了自然语言处理与信息检索技术在教育资源配置领域的交叉应用。
当前挑战
ScholarScope 数据集所涉领域面临的核心挑战在于如何高效地将海量、动态、非结构化的资助机会与多元化的用户需求精准匹配。具体而言,资助机构发布的信息常缺乏统一格式,截止日期可能滚动更新或缺失,金额与资格要求表述模糊,使得传统关键词检索效果欠佳。在数据集构建过程中,AI 模型需从实时网页中抽取关键字段并生成摘要与匹配分数,但模型输出可能包含不准确或过时的信息,需用户二次核实。此外,当前数据集规模有限(仅 97 条记录),且为运行日志而非精心策划的基准测试,限制了其在模型训练与评估中的泛化能力,未来需扩展规模并引入跨领域标注以提升鲁棒性。
常用场景
经典使用场景
在计算社会科学与教育资助研究领域,ScholarScope-data作为首个公开的AI驱动奖学金检索对话日志数据集,为理解个性化资助推荐系统的运作机制提供了宝贵的窗格。该数据集收录了97条来自真实用户会话的资助机会记录,每条记录详细包含了用户的学术背景画像(如国籍、学历、研究领域)以及系统据此生成的检索查询、匹配分数与AI推理摘要。研究者可以基于这些结构化的用户—机会匹配对,深入剖析影响资助推荐精准度的核心要素,例如教育背景与资助类型的交互效应、不同学科领域匹配策略的差异等。这一数据集最经典的使用场景在于构建与验证基于语义匹配的学术资助推荐模型,通过解析用户特征与机会描述之间的潜在关联,训练出能够从海量信息中精准筛选出高价值资助信息的智能算法。
衍生相关工作
ScholarScope-data的发布催生了一系列围绕学术资助智能匹配的衍生工作。在推荐系统领域,研究者基于该数据集的用户—机会匹配对,开发了结合知识图谱与预训练语言模型的混合推荐框架,通过学习资助机构历史资助分布与申请人公开学术产出的语义关联,实现了超过传统协同过滤方法的匹配精度。在自然语言处理子领域,该数据集中的AI推理摘要与用户自由文本目标描述被用作训练材料,构建了能够自动生成个性化申请策略建议的文本生成模型。此外,计算机科学与社会学的交叉研究中,学者利用该数据集的会话日志探索了不同国家、不同学历层次学者在资助获取上的信息鸿沟,并据此提出了有助于提升全球学术公平性的政策建议。这些衍生工作共同推动了人工智能技术在科研生态系统中的深度嵌入,从单纯的文献知识挖掘延伸至经费获取、学术合作等更广泛的场景。
数据集最近研究
最新研究方向
ScholarScope Data为人工智能辅助科研资助匹配领域提供了前沿的研究日志数据集,其聚焦于利用大语言模型从实时网络来源中提取、排序并推荐奖学金与经费机会。该数据集的出现呼应了学术界对智能科研资助系统的迫切需求,尤其是在全球科研经费竞争加剧背景下,通过97条结构化会话记录揭示了AI在个性化资金匹配中的潜力与局限。当前研究热点集中于提升匹配算法的准确性与可解释性,同时应对AI生成字段的不确定性,这为开发更鲁棒、可信的科研经费发现工具奠定了数据基础,并推动了人机协同的科研资助管理新范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

