
ubertext-itn-uk
收藏官方服务:
资源简介:
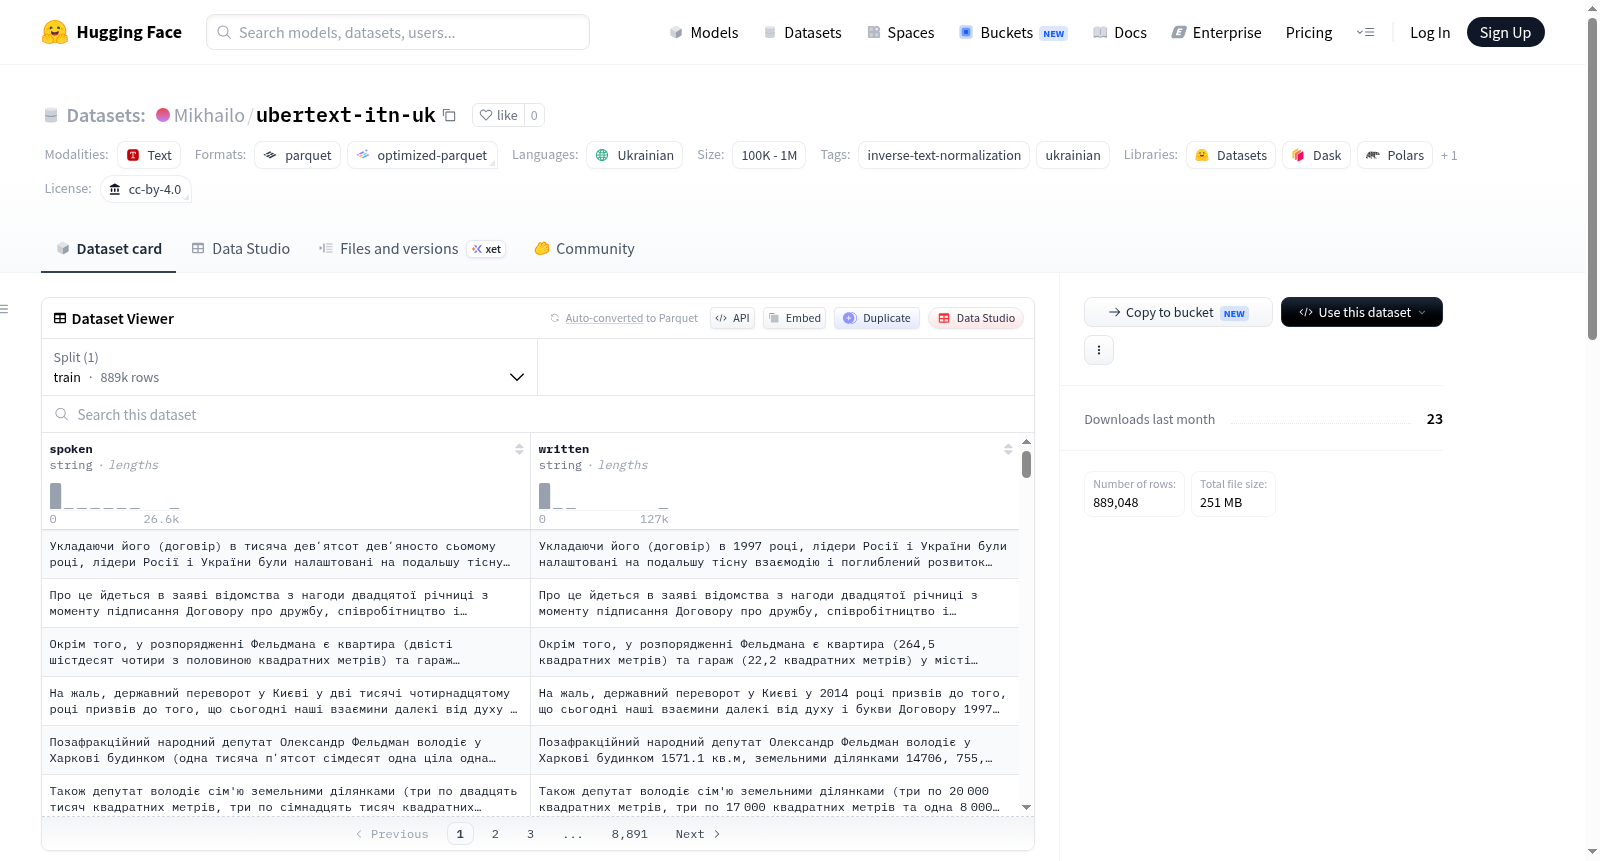
该数据集是一个用于乌克兰语逆文本规范化(Inverse Text Normalization, ITN)任务的大规模句子对集合,包含约88.9万个样本。其核心目的是将口语形式的乌克兰语文本(如语音识别系统的原始输出)转换为包含标准数字、符号和缩写的规范化书面文本。数据来源于skypro1111/ubertext-2-news-verbalized数据集,并采用大型语言模型(LLM)辅助标注(使用openai/gpt-oss-20b模型通过vLLM框架)的方式生成。每个数据样本由两个字段构成:spoken字段代表口语化的乌克兰语文本,作为ITN模型的输入;written字段则是对应的、经过规范化的目标文本。示例展示了典型的转换,例如将сорок два відсотки населення转换为42% населення,将пʼятнадцять доларів і двадцять центів转换为$15.20等。该数据集适用于训练和评估文本到文本生成模型,特别是针对乌克兰语的逆文本规范化、语音识别后处理等应用场景。
创建时间:
2026-06-05
原始信息汇总
- 数据集名称:Ukrainian ITN Dataset
- 语言:乌克兰语(uk)
- 许可证:Creative Commons Attribution 4.0 International (cc-by-4.0)
- 任务类别:文本到文本生成(text2text-generation)
- 标签:逆文本归一化(inverse-text-normalization)、乌克兰语(ukrainian)
- 规模:约889k(88.9万)对句子对
数据集描述:该数据集专门用于乌克兰语的逆文本归一化(ITN)任务,包含从口语形式到书面形式的成对转换。数据来源于skypro1111/ubertext-2-news-verbalized数据集,通过大语言模型辅助注释(使用openai/gpt-oss-20b,经vLLM运行)生成。
数据列:
- spoken:乌克兰语口语形式文本(ITN的输入)
- written:包含数字、符号、缩写的规范文本(ITN的输出)
示例:
| spoken | written |
|---|---|
| сорок два відсотки населення | 42% населення |
| пʼятнадцять доларів і двадцять центів | $15.20 |
| двадцять третього лютого дві тисячі двадцять четвертого року | 23 лютого 2024 |
| температура мінус сімнадцять градусів | температура -17 градусів |
使用方法(Python代码示例): python from datasets import load_dataset
ds = load_dataset("Mikhailo/ubertext-itn-uk") print(ds["train"][0])
搜集汇总
数据集介绍
构建方式
该数据集专为乌克兰语逆文本正则化任务而设计,基于现有数据集 skypro1111/ubertext-2-news-verbalized 构建。通过大语言模型(openai/gpt-oss-20b via vLLM)辅助标注,将口语化表达自动转换为包含数字、符号与缩写等标准化形式的书面文本,最终生成约89万对高质量的“口语-书面”平行句对。
特点
数据集以口语形式作为输入、规范书面形式作为输出,覆盖了百分比、货币金额、日期与负温度等多种现实场景中的典型转换实例。所有语料均源自乌克兰语新闻文本,语言地道且领域聚焦,能够有效训练逆文本正则化模型,提升从其口语化表示中还原完整规范文本的能力。
使用方法
用户可通过 HuggingFace Datasets 库直接加载使用,仅需一行代码 `load_dataset("Mikhailo/ubertext-itn-uk")` 即可获取训练集。数据集包含 `spoken` 与 `written` 两个字段,分别对应输入与目标文本,适合用于序列到序列模型的训练与评估。
背景与挑战
背景概述
该数据集于2024年由研究者Mikhailo基于skypro1111发布的乌克兰语文本语料库构建,聚焦于逆文本规范化任务,旨在将口语化表达(如数字、符号、缩写的语音形式)还原为书面标准形式。逆文本规范化是自然语言处理中语音识别与文本生成系统的关键技术环节,尤其对于资源稀缺的乌克兰语而言,高质量数据集的匮乏长期制约着相关技术的发展。ubertext-itn-uk包含约88.9万对音文转换对,通过大语言模型辅助标注生成,为乌克兰语语音合成、自动语音识别后处理等下游任务提供了重要基础资源,显著推动了该语言在信息处理领域的研究进展。
当前挑战
该数据集面临多重挑战。首先,乌克兰语作为资源稀疏语言,其口语表达与书面规范间存在复杂映射关系,例如数字、日期、货币符号的多样化语音描述需要精准对应书面形态,这对模型的语言理解能力提出高要求。其次,在构建过程中,依赖大语言模型(如GPT)进行自动化标注虽提升了效率,但可能引入噪声错误,如语音向文本转换时的语义歧义或格式不一致。此外,数据仅覆盖新闻领域,缺乏口语对话、社交媒体等多样化场景,限制了模型在现实应用中的泛化能力。
常用场景
经典使用场景
在语音合成与自动语音识别技术的交汇处,逆文本归一化扮演着将口语化表达转化为规范书面文本的关键桥梁。该数据集专为乌克兰语逆文本归一化任务而设计,核心应用场景涵盖将诸如“сорок два відсотки населення”这类口语化表述精准转换为“42% населення”等包含数字、符号及缩写的标准书面形式。通过提供近89万对口语-书面平行语料,该数据集为训练高效稳定的逆文本归一化模型提供了坚实的资源基础,从而显著提升乌克兰语语音系统中文本后处理的准确性与流畅度。
实际应用
在实际应用层面,该数据集为乌克兰语智能语音交互系统的商业化落地提供了不可或缺的技术支撑。它可被直接用于优化语音助手的文本后处理模块,确保用户口语指令(如“пʼятнадцять доларів і двадцять центів”)在屏幕上被准确显示为“$15.20”。此外,该资源还可服务于乌克兰语自动字幕生成、语音转写报告标准化、以及金融、医疗等专业领域的语音数据文本化流程,极大提升了乌克兰语信息处理的可用性与用户体验。
衍生相关工作
基于该数据集,研究者已衍生出多项具有影响力的相关工作。例如,借助其高质量口语-书面平行对,可微调大型语言模型以构建乌克兰语端到端逆文本归一化系统,用于对比不同规模语言模型在该任务上的表现差异。此外,该数据也为探索逆文本归一化与其他文本规范化任务(如拼写校正、缩写展开)的联合建模提供了可行的训练资源,并催生了关于低资源语言下数据增强策略与跨领域泛化能力评估的系列研究,进一步拓展了乌克兰语文本后处理技术的学术与工程边界。
以上内容由遇见数据集搜集并总结生成


