
PrunaAI/pruna-skills
收藏官方服务:
资源简介:
该数据集是Pruna Skills的文档示例,包含为PrunaAI/pruna-skills文档生成的媒体文件(如图像、音频和视频)及其对应的元数据文件。每个examples/目录下的文件都对应docs/EXAMPLES.md中的一个技能演示示例,PNG/MP3/MP4输出文件都有一个同名的.meta.json文件,其中包含确切的提示词、模型和输入信息。数据集主要用于展示PrunaAI技能的使用示例,并支持通过API重新生成和维护。
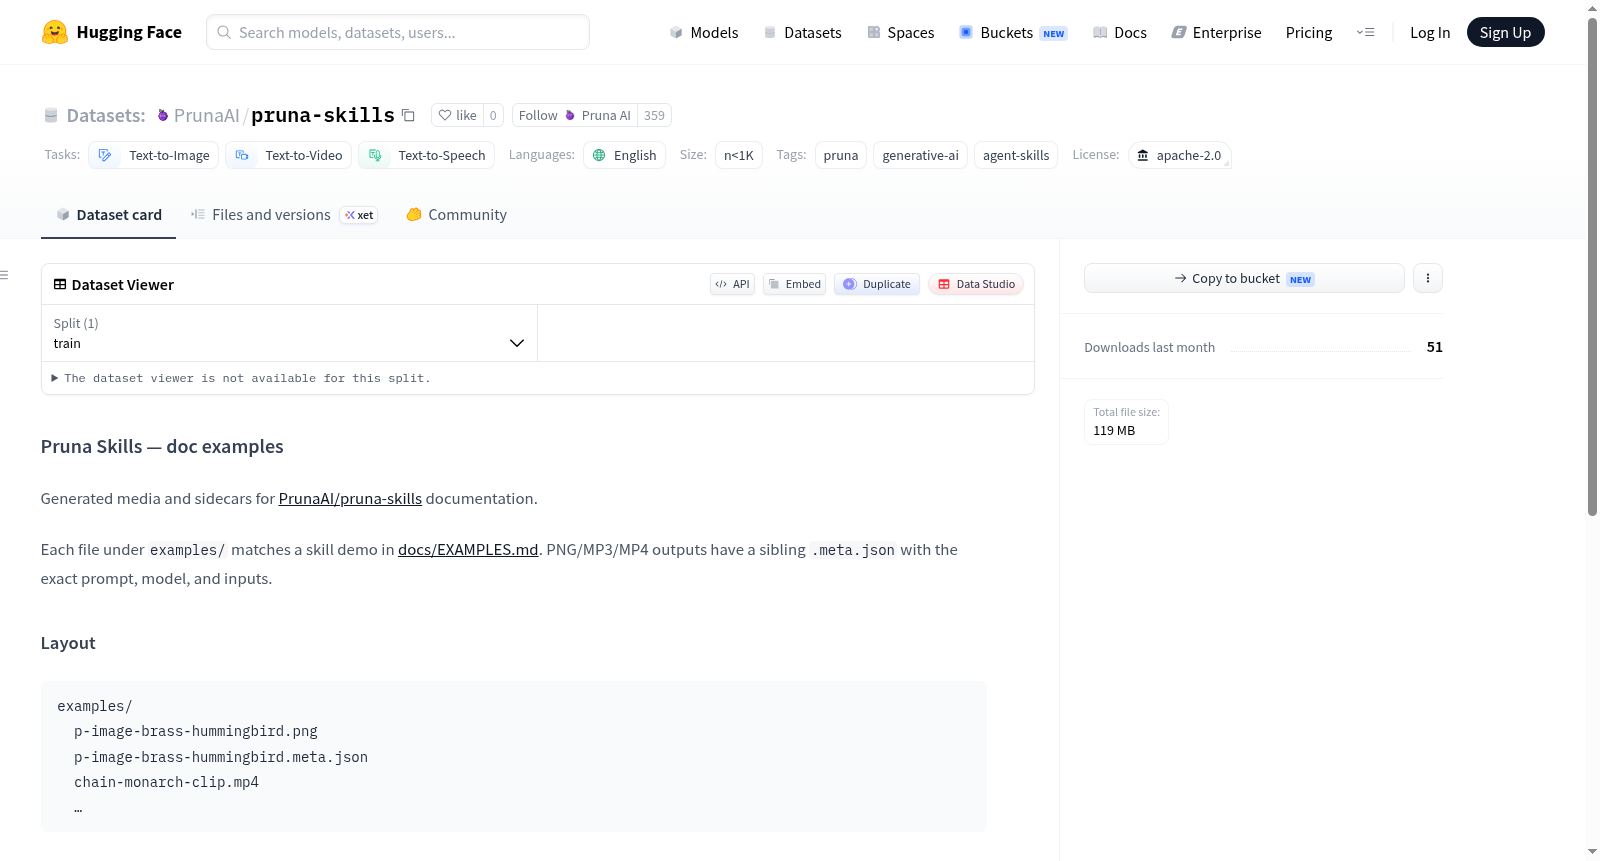
Generated media and sidecars for PrunaAI/pruna-skills documentation. Each file under examples/ matches a skill demo in docs/EXAMPLES.md. PNG/MP3/MP4 outputs have a sibling .meta.json with the exact prompt, model, and inputs.
提供机构:
PrunaAI原始信息汇总
- 数据集名称:PrunaAI/pruna-skills
- 任务类型:Text-to-Image(文本到图像)、Text-to-Video(文本到视频)、Text-to-Speech(文本到语音)
- 语言:英语
- 规模:小于1千条样本
- 许可证:Apache-2.0
- 标签:pruna、generative-ai、agent-skills
- 数据集结构:包含一个子集(default),该子集仅有一个训练集(train)分割。
- 数据内容:数据集包含生成式AI技能演示的示例文件(如PNG、MP3、MP4)及其对应的元数据JSON文件。元数据文件记录了提示词(prompt)、模型(model)、输入信息(input,包括图像、音频、视频提示、分辨率)以及输出URL等信息。
- 文件布局:示例文件位于
examples/目录下,每个生成的媒体文件(如p-image-brass-hummingbird.png)都有一个同名的.meta.json元数据文件(如p-image-brass-hummingbird.meta.json)。 - 使用说明:可通过直接URL
https://huggingface.co/datasets/PrunaAI/pruna-skills/resolve/main/examples/<filename>访问文件。维护者可使用提供的命令(如make download-doc-examples-hf、make doc-examples)重新生成或下载示例。 - 下载统计:上月下载量为51次,总文件大小为119 MB。
- 数据集查看器状态:当前无法正常加载数据预览,因为数据集的字段结构与实际数据不匹配(字段名不一致导致类型转换错误)。
搜集汇总
数据集介绍
构建方式
该数据集专为PrunaAI的pruna-skills项目文档配套而生,旨在提供技能演示的生成媒体及其元数据。数据集以example文件夹为核心单元,每个媒体文件(如PNG、MP3、MP4)均配备同名的.meta.json文件,详实记录生成该媒体所使用的提示词、模型与输入参数。这样的组织方式确保了每一份媒体产出与其生成条件之间的严格对应,极大地方便了技能复现与可追溯性。
特点
数据集虽规模微小(n<1K),却涵盖文本到图像、文本到视频、文本到语音等多模态生成任务,展现出丰富的技能覆盖广度。其最为显著的特点在于每一份媒体文件都带有一个结构化的元数据伴侣,将生成过程的上下文信息完整保留。这种设计不仅提升了数据的使用价值,还使得整个生成过程透明化,为后续的调试、分析与优化提供了可靠的基准。
使用方法
用户可通过Hugging Face数据集接口直接访问,利用Resolve API以公开URL形式获取example文件夹下的具体文件。对于开发者而言,数据集的维护与再生可通过项目仓库中的Makefile命令体系轻松完成,例如使用make download-doc-examples-hf从Hugging Face拉取已检入的示例,或通过make doc-examples经Pruna API重新生成。操作前需配置有效的PRUNA_API_KEY及对PrunaAI/pruna-skills仓库具备写入权限的Hugging Face令牌。
背景与挑战
背景概述
Pruna Skills文档示例数据集由PrunaAI团队于近期创建,旨在为多模态生成式AI技能库提供配套的演示媒体与元数据。该数据集服务于文本到图像、文本到视频及文本到语音等生成任务,每个样本均包含PNG、MP3或MP4格式的输出文件及其精确的提示词、模型和输入参数的元数据JSON文件。作为PrunaAI/pruna-skills开源项目的重要组成部分,该数据集为开发者提供了可复现的技能演示范例,推动了多模态生成式AI在标准化评估与文档化方面的进展。其简洁高效的设计理念,使其在生成式AI技能库的构建与传播中展现出独特价值。
当前挑战
当前该数据集面临的主要挑战包括:1) 在生成式AI领域,如何确保不同模态间(如图像、音频、视频)的生成质量与一致性,并验证技能演示的可复现性,是亟待解决的领域难题;2) 构建过程中,由于依赖外部Pruna API进行媒体生成,数据集维护面临API密钥管理与版本依赖的挑战,同时需协调Hugging Face仓库的写入权限与文件同步,确保示例与对应技能文档的实时匹配,避免因技术栈更新导致演示失效。
常用场景
经典使用场景
Pruna Skills数据集专为生成式AI代理技能的教学与演示而设计,其经典使用场景涵盖文本到图像、文本到视频及文本到语音等多模态生成任务。研究人员与开发者可借助该数据集中的示例文件及其配套元数据,精准复现各类生成式AI技能的调用流程,从而高效理解代理系统的能力边界与操作范式。
实际应用
在实际应用中,Pruna Skills数据集为开发者提供了可直接引用的生成结果模板,显著降低了AI代理功能演示与产品原型开发的门槛。企业技术团队可基于该数据集快速构建多模态内容生成的应用案例,例如自动化营销素材制作、个性化视频播报及语音交互场景,从而加速生成式AI技术从实验室到商业落地的转化进程。
衍生相关工作
以此数据集为基础,衍生出了一系列专注于代理技能编排与跨模态任务连贯性优化的研究工作。这些工作利用数据集中的提示与输出对应关系,探索了多步骤生成流程的自动化调度策略,并推动了提示链(prompt chaining)、模型组合(model ensembling)以及输出质量一致性校验等方向的技术进展,进一步丰富了生成式AI代理生态的理论与实践体系。
以上内容由遇见数据集搜集并总结生成


