hplt
收藏资源简介:
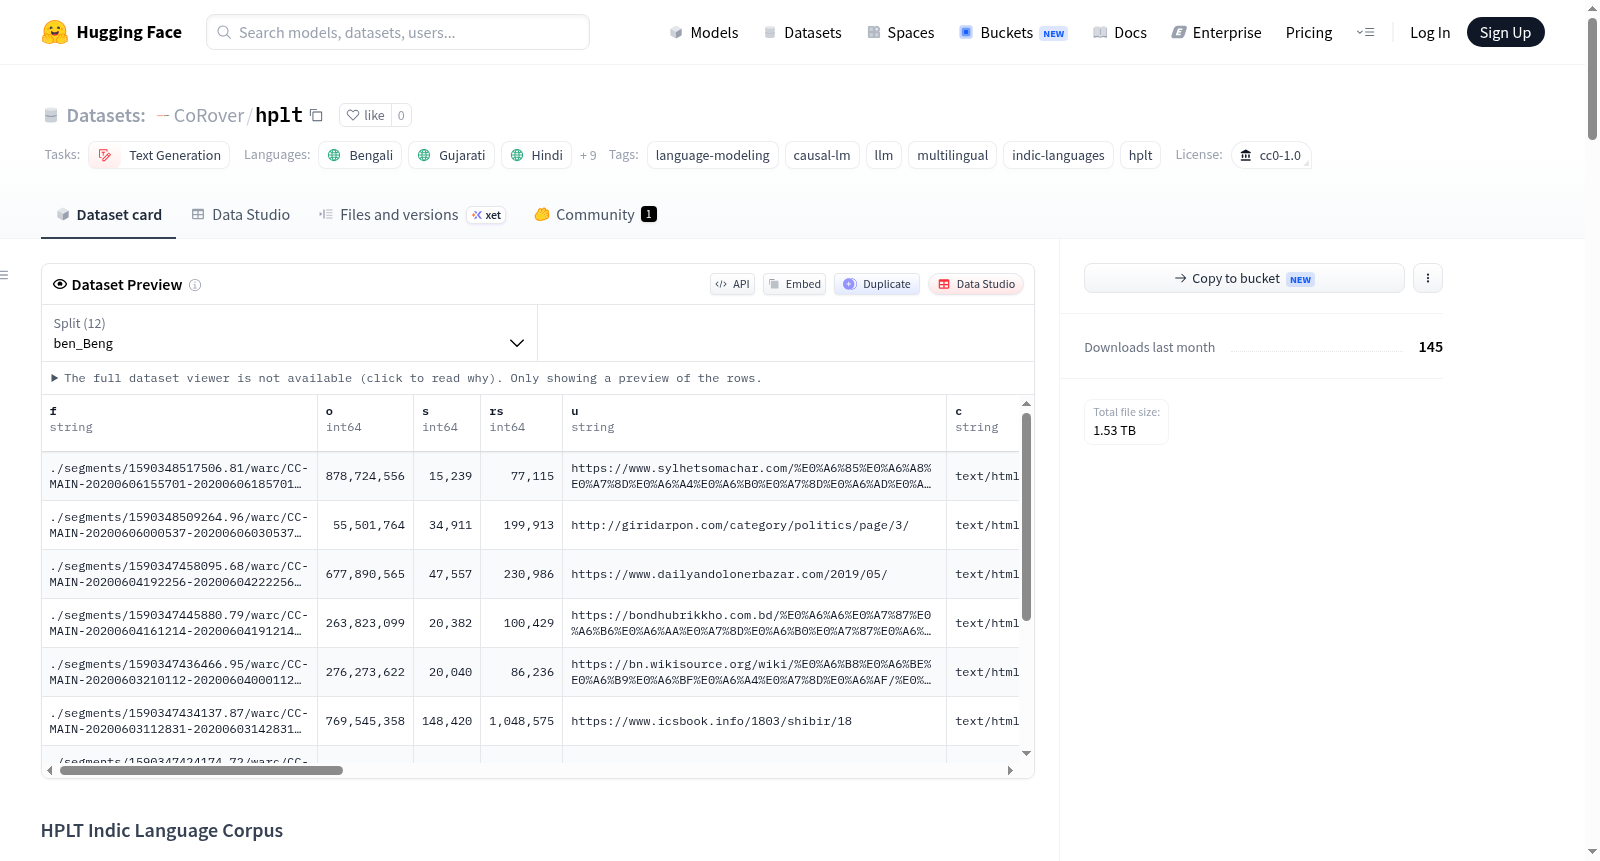
HPLT Indic Language Corpus 是一个多语言印度语料库,源自 HPLT Monolingual Dataset 3.0,由 CoRover 整理并托管,专为大规模生成式语言模型预训练和多语言自然语言处理研究设计。该数据集包含 12 种印度语言的原始网页文本数据,每种语言对应一个独立的拆分(split),覆盖孟加拉语、古吉拉特语、印地语、卡纳达语、马拉雅拉姆语、马拉地语、曼尼普尔语、奥里亚语、旁遮普语、泰米尔语、泰卢固语和乌尔都语,并采用各自的标准书写系统。每个样本包含丰富的元数据字段,如文本内容、语言标识、来源URL、时间戳、文档质量分数、去重信息、过滤标签、个人身份信息标记、以及21维的网页注册类别得分等。数据规模庞大,适用于因果语言建模、多语言模型训练、低资源语言研究、分词器开发等任务。数据来源于Common Crawl和Internet Archive等大规模网页抓取,经过HPLT处理流水线(包括文本提取、语言识别、质量过滤、去重等)生成。许可协议为CC0,但用户需自行评估底层网页内容的版权和合规性。
HPLT Indic Language Corpus is a multilingual Indian corpus derived from HPLT Monolingual Dataset 3.0, curated and hosted by CoRover, designed for large-scale generative language model pretraining and multilingual natural language processing research. The dataset contains raw web text data in 12 Indian languages, each with a separate split, covering Bengali, Gujarati, Hindi, Kannada, Malayalam, Marathi, Manipuri, Odia, Punjabi, Tamil, Telugu, and Urdu, using their respective standard writing systems. Each sample includes rich metadata fields such as text content, language identifier, source URL, timestamp, document quality score, deduplication information, filtering labels, personally identifiable information marks, and 21-dimensional web registration category scores. The data scale is large, suitable for tasks such as causal language modeling, multilingual model training, low-resource language research, and tokenizer development. The data originates from large-scale web crawls like Common Crawl and Internet Archive, processed through the HPLT pipeline (including text extraction, language identification, quality filtering, deduplication, etc.). The license is CC0, but users need to evaluate the copyright and compliance of the underlying web content themselves.
HPLT 印度语言语料库
数据集概述
该数据集由 CoRover 整理并托管,包含从 HPLT 单语数据集 3.0 中精选的印度语言数据,专为大规模生成式语言模型预训练和多语言 NLP 研究设计。数据集包含多个印度语言及其文字的原始 HPLT 数据。
语言覆盖
数据集涵盖 12 种印度语言,具体如下:
| 语言 | 语言代码 | 文字 | 目录 |
|---|---|---|---|
| 孟加拉语 | ben |
孟加拉文 | ben_Beng_raw |
| 古吉拉特语 | guj |
古吉拉特文 | guj_Gujr_raw |
| 印地语 | hin |
天城文 | hin_Deva_raw |
| 卡纳达语 | kan |
卡纳达文 | kan_Knda_raw |
| 马拉雅拉姆语 | mal |
马拉雅拉姆文 | mal_Mlym_raw |
| 马拉地语 | mar |
天城文 | mar_Deva_raw |
| 曼尼普尔语 | mni |
孟加拉文 | mni_Beng_raw |
| 奥里亚语 | ory |
奥里亚文 | ory_Orya_raw |
| 旁遮普语 | pan |
古木基文 | pan_Guru_raw |
| 泰米尔语 | tam |
泰米尔文 | tam_Taml_raw |
| 泰卢固语 | tel |
泰卢固文 | tel_Telu_raw |
| 乌尔都语 | urd |
阿拉伯文 | urd_Arab_raw |
数据格式
每条数据记录包含以下字段:
- f: 字符串类型
- o: 整数类型
- s: 整数类型
- rs: 整数类型
- u: 字符串类型
- c: 字符串类型
- ts: 时间戳类型
- de: 字符串类型
- crawl_id: 字符串类型
- lang: 字符串序列
- prob: 浮点数序列
- text: 字符串类型(文档文本)
- xml: 字符串类型
- html_lang: 字符串序列
- cluster_size: 整数类型
- seg_langs: 字符串序列
- id: 字符串类型
- filter: 字符串类型
- pii: 整数序列的序列
- doc_scores: 浮点数序列
- web-register: 包含 25 个浮点数子字段的结构体
预期用途
该数据集适用于以下场景:
- 生成式语言模型预训练
- 因果语言建模
- 多语言语言模型训练
- 印度语言模型训练
- 继续预训练
- 文本生成
- NLP 研究
- 分词器开发
- 跨语言建模
- 低资源语言研究
数据来源与处理
数据来源于 HPLT(高性能语言技术) 项目的 HPLT 单语数据集 3.0,主要基于大规模网络爬取数据(包括 Common Crawl 和 Internet Archive)。处理流程包括:
- 文本提取
- 语言识别
- 质量过滤
- 去重
- 文档处理
- 语言/文字分类
质量与使用建议
数据集中包含质量相关信息,用户在生产环境中进行模型训练时,可额外执行以下操作:
- 语言过滤
- 质量过滤
- 文档去重
- 领域过滤
- 文本标准化
- 文字验证
- 有害性与安全性过滤
推荐的使用步骤:解压数据分片 → 提取文本 → 语言与文字验证 → 去重 → 质量过滤 → 文本标准化 → 分词 → 转换为训练格式。
许可与声明
- 数据集打包采用 CC0 许可
- 底层文本来源于网络,可能受原始内容的权利、许可、服务条款等限制
- 用户需自行评估数据是否适用于其特定用途
引用
如使用该数据集,请引用 HPLT 项目:
bibtex @misc{hplt, title = {HPLT Monolingual Datasets}, author = {HPLT}, url = {https://hplt-project.org/datasets/v3.0} }