
KvaytG/russian-discord-chat-logs
收藏官方服务:
资源简介:
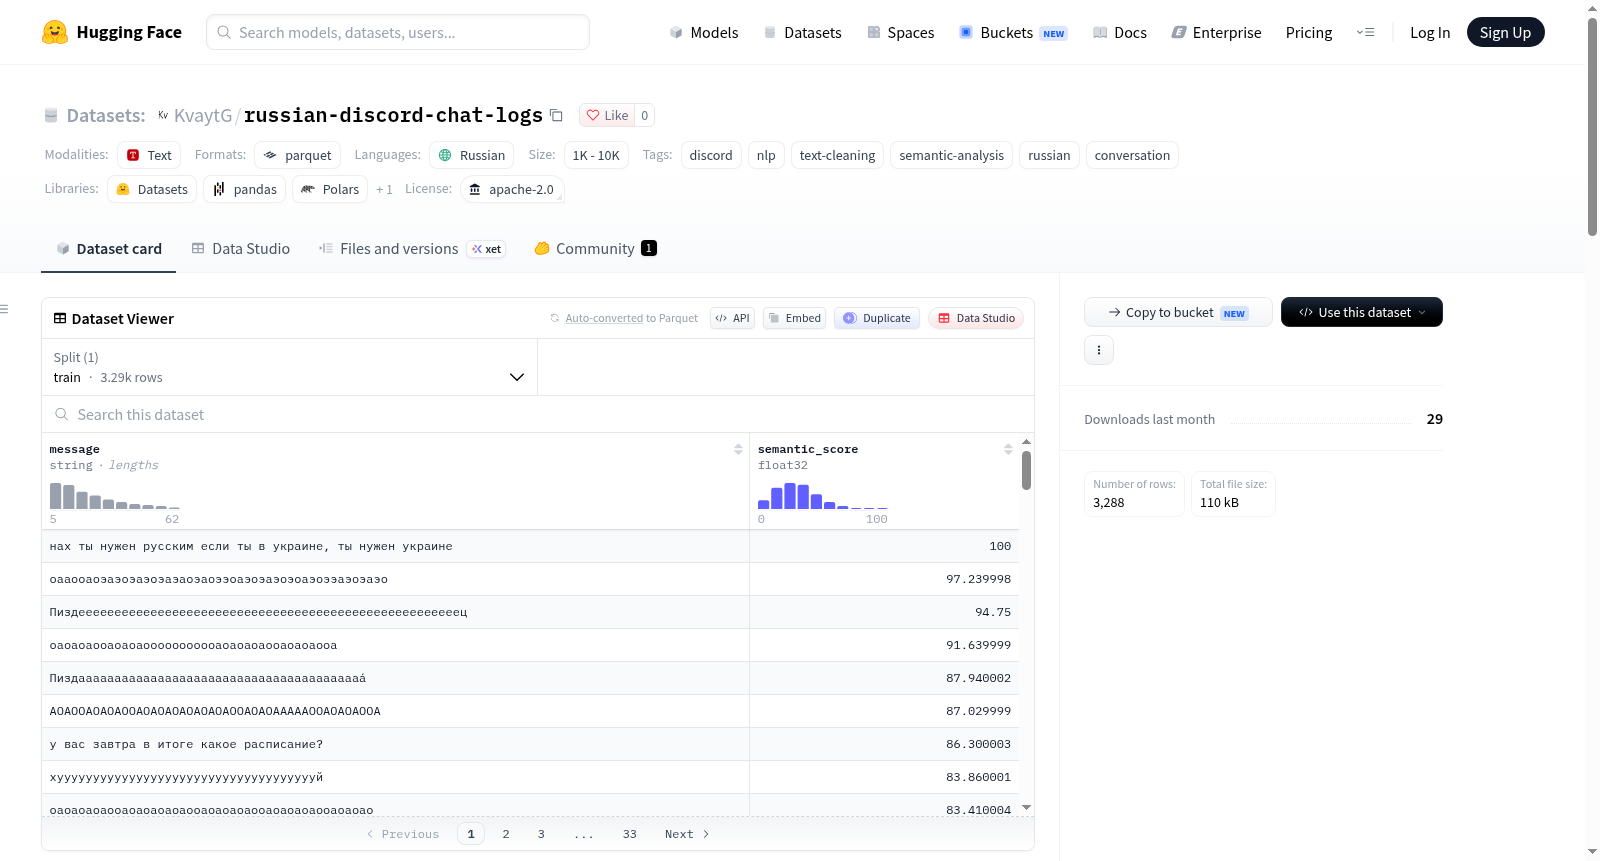
该数据集以Parquet格式存储,提供高效的存储和快速查询性能,并保持精确的数据类型。每一行代表一条唯一的聊天消息,这些消息经过了多个阶段的严格清洗、过滤和语义分析处理。具体模式包括:message列(包含至少30%西里尔字符的清理后Discord消息文本)和semantic_score列(一个归一化值,范围0.0-100.0,表示消息的信息和语义密度)。
The data is stored in Parquet format, which provides efficient storage, fast query performance, and maintains precise data types. Each row represents a single unique chat message that has passed through several stages of rigorous cleaning, filtering, and semantic analysis. The schema includes: message column (the cleaned text of the Discord message containing at least 30% Cyrillic characters) and semantic_score column (a normalized value 0.0 - 100.0 representing the messages information and semantic density).
提供机构:
KvaytG搜集汇总
数据集介绍
构建方式
该数据集的构建依托于Discord平台导出的原始消息日志,经过多阶段自动化流程提炼而成。原始日志从嵌套文件夹中的messages.json文件解析提取,先经过去重处理合并相同消息,再按长度排序剔除首尾各10%的极端异常值,以消除单词刷屏或大规模复制粘贴带来的噪声。随后进行文本清洗,移除全部超链接并丢弃纯表情符号消息。为控制多语言噪声与代码片段,管线计算每条消息中西里尔字母的占比,仅保留俄文字母比例不低于30%的文本。最终每条消息经由句向量模型编码,计算其语义密度得分,形成结构化数据。
特点
数据集以Parquet格式存储,具备高效读写与精确类型保持能力,整体规模介于一千至一万条之间。每条记录包含清洗后的俄语消息文本与一个归一化至0至100的语义得分,用以刻画信息密度与语义丰富度。语义得分并非简单依赖文本长度,而是综合多语言Sentence-Transformer模型生成的嵌入向量L2范数、基于字符长度的对数加权以及最小-最大缩放计算得出,从而将语义复杂、上下文丰富的句子与简短应答区分开来。全部数据按语义得分降序排列,使高价值对话内容居于前列,便于优先获取。
使用方法
使用者可通过Hugging Face datasets库便捷加载该数据集,只需调用load_dataset函数并指定数据集名称与训练集划分即可获取全部数据。加载后的数据可直接用于自然语言处理任务,例如语义分析、文本质量评估、对话系统训练或俄语语料筛选。由于数据已按语义得分排序,研究者既可整体利用,也可依据得分阈值截取高信息密度子集进行针对性实验。数据集采用Apache 2.0许可,允许在合规前提下自由使用与分发,使用时建议参考提供的引用信息以标明来源。
背景与挑战
背景概述
俄语社交媒体文本资源的匮乏长期制约着低资源语言自然语言处理的发展,Discord作为兼具即时性与社群性的平台,其聊天日志蕴含着丰富的口语化表达与多语混杂现象。russian-discord-chat-logs数据集由KvaytG构建并于2026年发布,旨在为俄语语义分析与文本清洗研究提供经过严格预处理的对话语料。该数据集以语义密度得分为核心创新,借助多语言句向量模型对每条消息进行量化排序,从而将高信息量的讨论内容置于数据前列。这一设计为俄语对话系统、语义相似度计算及低资源语言建模提供了可复用的基准资源,对推动俄语NLP的实证研究具有积极意义。
当前挑战
该数据集所面对的领域问题在于俄语网络聊天文本的语义筛选与噪声抑制,即如何从高度口语化、混杂表情符号与多语种干扰的Discord消息中提取具有分析价值的语料。构建过程中的核心挑战包括:嵌套文件夹结构下messages.json的解析与提取一致性,重复消息合并时对语义等价与字面相同的区分,长度修剪阶段对10%分位阈值的选取可能误删简短但信息密集的回复,以及30%西里尔字符比例阈值的设定在过滤多语噪声与保留俄语夹杂外来词表达之间的权衡。此外,语义密度评分依赖句向量模型的L2范数与对数长度加权,其权重设计对短文本评分偏低的问题尚未在数据集中得到充分验证。
常用场景
经典使用场景
在俄语计算语言学与对话分析领域,该数据集最为经典的应用场景在于对非正式网络对话文本进行语义密度排序与高质量语料筛选。研究者借助句向量模型对每条Discord消息生成嵌入表示,继而以L2范数与长度对数加权的方式量化其信息含量,最终将语义得分介于0至100之间的消息按降序排列。此种使用范式使得蕴含丰富语境与复杂语义的长句得以居于前列,而诸如简单感叹或应答之类的低信息密度表达则自然沉降至底部,为后续的模型训练与语用分析提供了经预筛选的优质样本。
实际应用
在实际应用层面,该数据集可直接服务于俄语聊天机器人训练、社区内容审核与对话摘要生成等任务。凭借语义得分的降序排列,开发者能够快速定位最具信息价值的讨论片段,用于构建高质量的指令微调数据或检索增强生成的知识库。社交媒体分析团队亦可利用该评分筛选出高语义密度的用户反馈,从而优化产品迭代决策。此外,该数据集所采用的清洗与评分流水线可迁移至其他语言或平台,为跨语言对话数据的自动化预处理提供可借鉴的工程范式。
衍生相关工作
围绕该数据集的构建方法,后续研究可延伸至多个方向。其一,基于paraphrase-multilingual-MiniLM-L12-v2的语义评分框架可被替换为其他多语言句向量模型,以比较不同嵌入空间对俄语语义密度的表征差异。其二,该数据集的清洗与筛选流程可被复用于Telegram、VKontakte等俄语社交平台的日志分析,催生跨平台的对话语料库构建工作。其三,语义得分与消息长度、字符组成等特征的关联分析,可为俄语非正式文本的信息论研究提供实证基础,进而推动低资源语言对话理解模型的迭代与优化。
以上内容由遇见数据集搜集并总结生成


