
遇见数据集

xpertsystems/hc-gen-007-sample

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

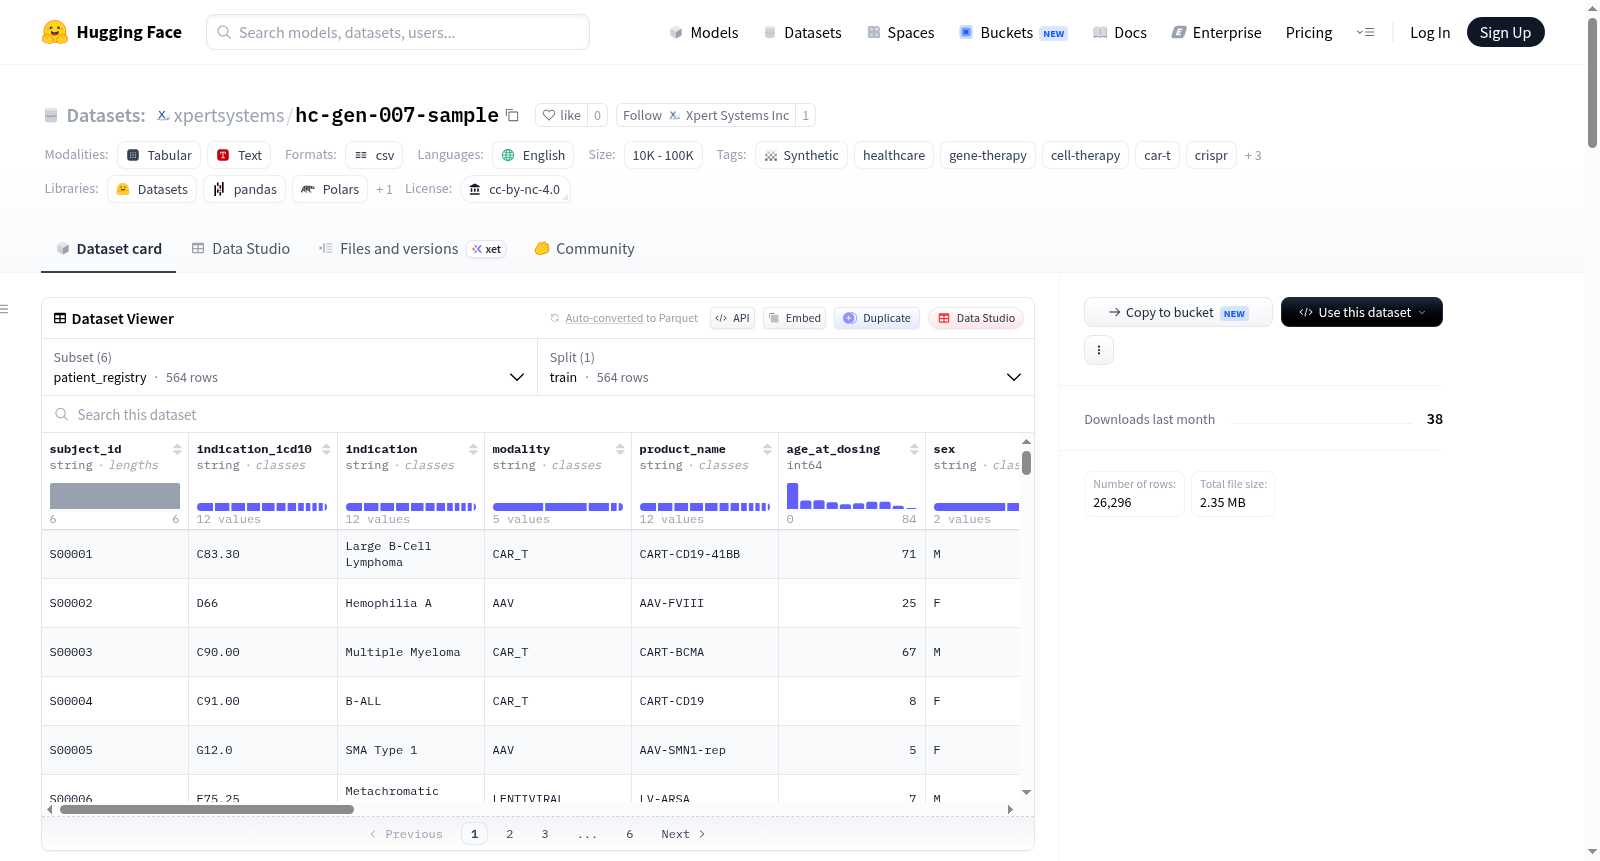
HC-GEN-007基因治疗反应数据集:多模态纵向疗效、安全性、免疫原性与长期随访(样本)。这是一个合成患者级数据集,模拟了基因和细胞治疗在5种治疗方式(AAV、LNP-mRNA、CAR-T、CRISPR/Cas9、慢病毒)和12种适应症上的纵向反应,包含24个月随访窗口和针对整合载体的15年长期随访(遵循FDA 2020长期随访指南)。该数据集是完整HC-GEN-007产品(5000名受试者)的样本,包含约500名给药受试者,完全合成,不包含真实患者或产品数据,产品原型(如AAV-FVIII、CART-CD19)为虚构。注意:不用于临床用途,仅用于机器学习开发、基准测试、模式原型设计和教育。

HC-GEN-007 — Gene Therapy Response Dataset: Multi-Modality Longitudinal Efficacy, Safety, Immunogenicity & Long-Term Follow-Up (Sample). Synthetic patient-level dataset modeling longitudinal response to gene and cell therapy across 5 modalities (AAV, LNP-mRNA, CAR-T, CRISPR/Cas9, Lentiviral) and 12 indications, over a 24-month follow-up window with Year-15 long-term follow-up for integrating vectors (per FDA 2020 LTFU guidance). This is a ~500-dosed-subject sample of the full HC-GEN-007 product (5,000 subjects). It is synthetic — generated by a benchmark-first simulation engine. It contains no real patient or product data. Product archetypes (e.g. AAV-FVIII, CART-CD19) are fictional. Not for clinical use. This dataset is for ML development, benchmarking, schema prototyping, and education only.
提供机构:
xpertsystems
搜集汇总
数据集介绍
xpertsystems/hc-gen-007-sample 数据集图片
构建方式
该数据集以合成方式构建,通过一个基准优先的仿真引擎生成,模拟了基因与细胞疗法在5种模态(AAV、LNP-mRNA、CAR-T、CRISPR/Cas9、慢病毒)和12种适应症下长达24个月的核心随访及15年长期随访数据。其核心构建单元为每位给药受试者,并以六个关系型CSV表格呈现,涵盖患者注册、疗效结局、不良事件、免疫原性实验室检查、长期随访及试验汇总信息。每个仿真参数均与对应的验证度量指标严格绑定,通过索引选择精准锁定,确保模拟值的可复现性。数据集样本规模约500名给药受试者,并注明了预先指定的校准目标,如持久应答率、CRS分级比例及nAb排除率等,实现了工程化的结构化分离效应。
特点
该数据集最显著的特点是其多模态覆盖与高保真校准能力,囊括了基因治疗领域的五大核心干预策略与十二种适应症,形成了高度结构化的纵向观测体系。其通过基准优先的验证框架,确保了各项关键指标(如持久应答率、CRS/ICANS发生率、AAV nAb排除率)与真实世界临床试验基准高度吻合,同时利用工程化的效应分离(如CRISPR靶向编辑成功与否的显著差异)增强了数据的区分度与实用性。数据集还专门针对整合型载体设计了长达15年的长期随访模块,契合FDA的指导方针。此外,数据集坦诚标注了已知的技术缺陷(如肝毒性事件中CRS标志的误标),展现了高度的透明性。
使用方法
该数据集的使用方式灵活多样,支持直接通过Pandas读取本地CSV文件进行个性化分析,也可利用Hugging Face的datasets库以配置名加载特定表格。数据以subject_id为键,在六个表格间构建了星型关联结构,便于进行关系型或纵向数据的机器学习流程开发。典型应用场景包括多模态基因与细胞疗法的疗效与安全性预测建模,如基于患者注册表与不良事件表计算CAR-T亚组的CRS发生率,或利用长期随访表进行生存分析与整合位点风险评估。加载时需注意排除标记为肝毒性的不良事件行以修正CRS标志误标,从而获得准确的CAR-T毒性率。该数据集的设计初衷是用于算法开发、基准测试、模式原型设计与教育目的,严禁用于临床决策。
背景与挑战
背景概述
HC-GEN-007-sample数据集由XpertSystems.ai于2026年创建,旨在解决基因与细胞治疗领域多模态纵向数据稀缺的困境。该数据集通过模拟引擎生成约500名受试者的合成患者数据,覆盖AAV、LNP-mRNA、CAR-T、CRISPR/Cas9及慢病毒五大治疗模态,涵盖12种适应症,并遵循FDA 2020年长期随访指南设计长达15年的随访窗口。其核心研究问题聚焦于疗效、安全性、免疫原性及长期随访的多维动态建模,为机器学习模型开发、基准测试及模式原型设计提供了标准化、可复现的校准锚点。该数据集因填补了基因治疗领域高质量合成数据空白,在学界与工业界引发了广泛关注,成为验证多模态治疗反应预测算法的重要工具。
当前挑战
在领域问题层面,基因治疗数据集面临的核心挑战是真实患者数据的稀疏性、隐私限制及跨模态异质性,难以支撑复杂机器学习模型的训练与泛化。HC-GEN-007通过模拟数据试图缓解这一问题,但合成数据固有的局限性依然存在,如单变量率校准准确但高阶相关结构未经验证,难以完全捕捉真实临床试验中治疗反应与不良事件间的复杂非线性关联。在构建过程中,挑战更为显著:数据生成引擎依赖基准优先策略,通过精准索引选择使关键指标(如持久应答率、CRS发生率)高度锁定于目标值,导致跨种子方差极小,虽确保了一致性,却牺牲了模拟真实世界异质性的能力;同时,引擎存在公开缺陷,如肝毒性事件误标为CRS标志,尽管该问题已在文档中诚实披露,但处理不当仍会导致CAR-T CRS率的错误计算,对下游模型应用构成潜在的误导风险。
常用场景
经典使用场景
在基因与细胞治疗这一前沿领域,HC-GEN-007样本数据集以其多模态、纵向的数据架构,成为研究疗法应答与安全性的理想基准平台。其核心用途涵盖五种治疗模态(AAV、LNP-mRNA、CAR-T、CRISPR/Cas9、慢病毒)与十二种适应症的跨域建模,尤其适用于描绘24个月内疗效轨迹、不良事件谱系及免疫原性动态变化。通过整合患者登记、疗效结局、不良事件、免疫学实验室检测及长达15年的长期随访记录,该数据集为构建基于真实世界临床逻辑的机器学习预测模型提供了结构化、标准化的输入,是评估新型疗法的临床前数据基石。
实际应用
在实际应用层面,HC-GEN-007样本数据集扮演着虚拟临床试验预演与算法验证沙盒的双重角色。药物研发机构可利用其合成患者群体,在真实世界数据匮乏的早期阶段,快速迭代CAR-T毒性预警模型、AAV免疫反应预测模型及CRISPR疗效率优化算法。监管科学领域,它可作为FDA长期随访指南实施效果的模拟验证工具,检验跨模态的生存分析与整合位点监测逻辑。面向临床决策支持系统的开发者,该数据集的星型关系表结构(六张关联CSV)使其成为练习关系型纵向数据流水线梳理、特征工程构建及多任务学习框架部署的教学与实践蓝本。
衍生相关工作
围绕HC-GEN-007数据集的结构与设计哲学,衍生了一系列具有启发性的相关工作。其锚点校准机制——即每个模拟参数严格对应一个验证指标——启发了基因治疗领域合成数据生成的基准优先方法论,推动了类似MMLU在生物医学工程中的算法验证标准。数据集中公开的标签泄漏缺陷已成为研究标签噪声对时间序列预测模型影响的重要案例,促进了针对不良事件分层模型的鲁棒性测试套件开发。此外,其多模态纵向架构范式被借鉴于构建跨癌种CAR-T应答预测数据库,以及AAV载体免疫原性的联合建模框架,形成了从合成数据到半合成基准的学术转化链条,在计算医学与药物安全评估的交汇处开辟了新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

