
遇见数据集

RoMoDataset/RoMo-SMPL

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

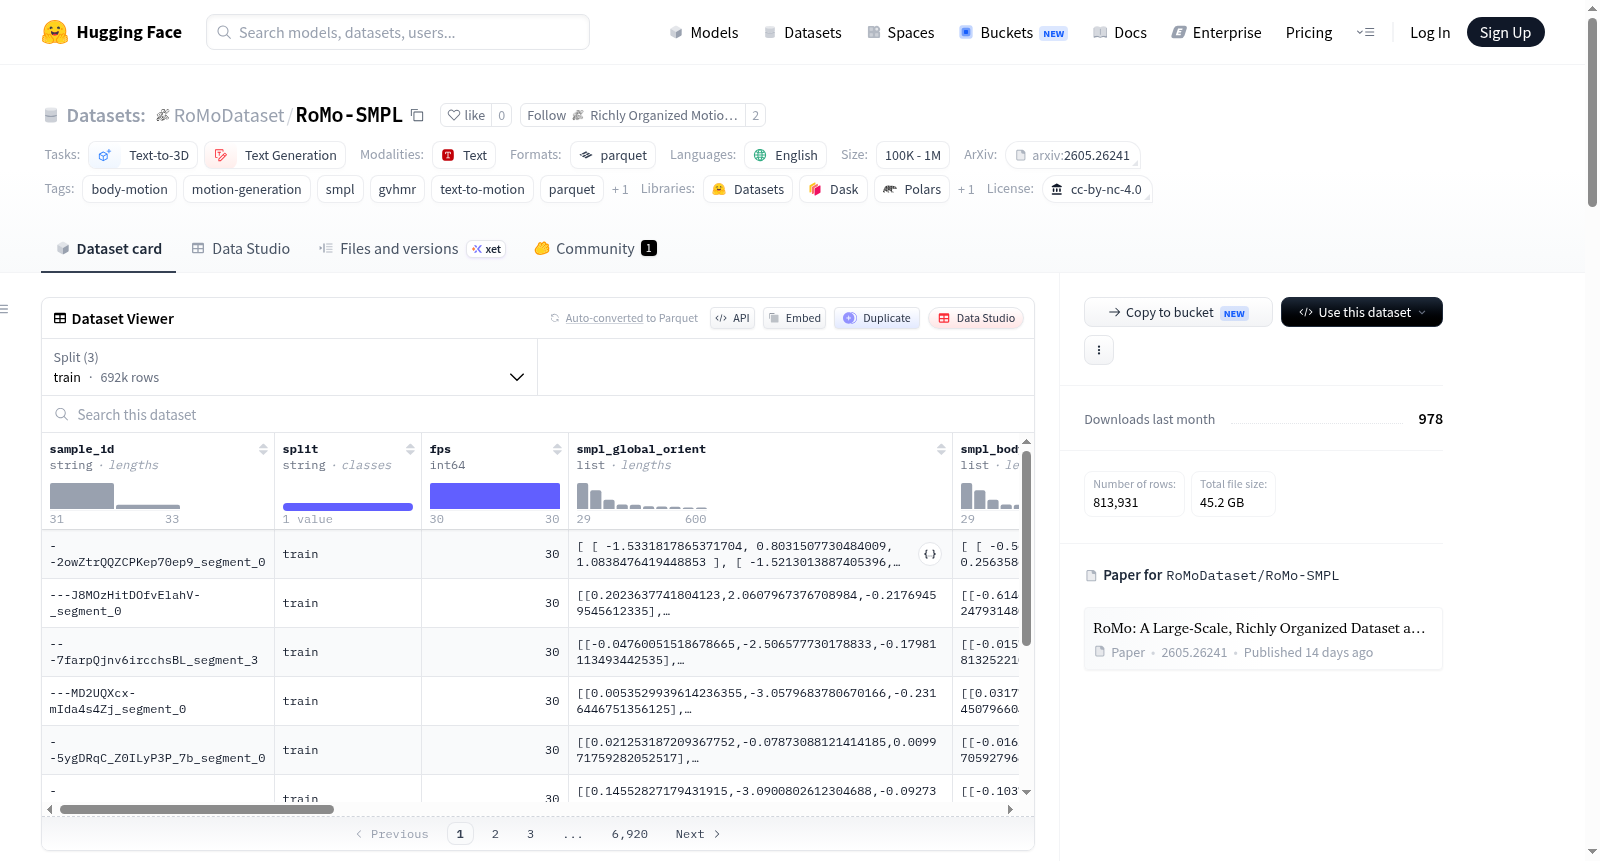
RoMo-SMPL是一个基于RoMo论文的大规模人体运动数据集,专注于SMPL身体参数空间(包括全局方向、21个关节的身体姿势、形状和平移参数)。该数据集包含815,555个运动序列,分为训练集(693,607)、验证集(81,270)和测试集(40,678),帧率为30 fps。身体模型来源于GVHMR恢复的SMPL身体。每个运动片段配有五个文本描述(从标签到段落级别)和一个三级语义分类法(包括类别、子类别和原子动作标签)。数据以Parquet格式(zstd分片)存储,许可证为CC BY-NC 4.0。该数据集主要用于文本到3D、文本生成和人体运动生成等任务,但不包含手部姿势和手部描述。

RoMo-SMPL is a paper-aligned release of the RoMo body motion corpus in SMPL body parameter space (global orientation, 21-joint body pose, shape, translation). It contains 815,555 sequences with fixed train (693,607), val (81,270), and test (40,678) splits, at a frame rate of 30 fps. The body model is derived from GVHMR recovery of SMPL body. Each clip includes five text captions and a three-level semantic taxonomy (category, subcategory, atomic action). The data is stored in Parquet format (zstd shards) under the CC BY-NC 4.0 license. It is designed for tasks such as text-to-3D, text generation, and motion generation, but does not include hand pose or hand captions.
提供机构:
RoMoDataset
搜集汇总
数据集介绍
RoMoDataset/RoMo-SMPL 数据集图片
构建方式
RoMo-SMPL是基于GVHMR算法对海量自然场景视频进行人体姿态恢复而构建的大规模动作数据集,其核心在于将视频中捕获的人体运动以SMPL参数化人体模型的形式表示,涵盖全局朝向、21个关节点姿态、体型参数与根节点平移。每个动作片段均配备五级文本描述(从粗粒度的标签到细粒度的段落描述)以及三层语义分类体系(类别、子类别、原子动作)。数据集严格划分为训练、验证与测试三部分,总计813,931条序列,并以Parquet格式的zstd分片存储于data/目录下。
特点
该数据集以SMPL参数作为统一表征,具有30帧每秒的固定采样率,每条序列包含完整的全局姿态参数与形状参数,同时提供多层次文本标签与结构化语义分类,便于从不同粒度理解人体动作。数据集规模大、标注丰富,且与RoMo-HML-263保持官方交集,支持跨表征的对比研究。需要注意的是,手部姿态及对应描述未被包含,仅专注于身体运动,这使得数据集中在全身动作建模上具有高度的专业性与纯净性。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,调用load_dataset('RoMoDataset/RoMo-SMPL')即可获取训练、验证与测试子集。每条样本以字典形式提供,包含sample_id、split、SMPL参数(global_orient、body_pose、betas、transl)以及从caption_l0到caption_l4的文本描述与taxonomy字段。这些数据可直接用于文本到3D动作生成、动作检索与语义理解等任务。研究者亦可根据split字段进行数据集切分,或利用taxonomy字段实现细粒度的训练与评估。
背景与挑战
背景概述
RoMo-SMPL数据集于2026年由张嘉豪等人发布,依托浙江大学等机构的研究力量,旨在解决文本到三维人体运动生成领域中大规模、高质量且语义丰富的数据匮乏问题。该数据集基于SMPL人体参数化模型,包含813,931条运动序列,每条都配有五级文本描述和三级语义分类体系,显著提升了运动数据的结构化与语义层次。其核心贡献在于为运动生成模型提供了统一、标准化的训练与评估基准,推动了文本驱动的人体动画、虚拟现实和具身智能等前沿领域的发展。RoMo-SMPL已成为相关研究中的重要数据基础设施。
当前挑战
当前挑战主要集中在三个层面。第一,领域问题方面,文本到运动生成面临运动多样性不足与细粒度语义对齐困难,现有模型难以准确捕捉复杂动作的时空变化和上下文关系。第二,数据构建过程中,从大规模互联网视频中恢复SMPL参数时,GVHMR方法因光照遮挡等因素导致7个片段产生非有限帧而被剔除,凸显了现实场景下运动重建的鲁棒性局限。第三,该数据集仅包含身体运动,缺乏手部姿态与表情建模,限制了其在全身交互任务中的适用性,多模态融合需求迫切。
常用场景
经典使用场景
在人体运动生成与理解的研究领域,RoMo-SMPL数据集因其大规模、高丰富度的SMPL格式运动序列而备受青睐。该数据集涵盖近81万段户外真实运动片段,每个片段均配有五个层级的文本描述及三级语义分类体系,为从文本生成逼真人体运动提供了坚实的数据基础。研究者常将其作为训练和评估文本到运动生成模型的核心基准,利用其标准化的训练/验证/测试划分,系统性地提升模型对多样化运动模式的建模能力。
解决学术问题
该数据集直面了已有运动数据集规模不足、语义标注粗糙且缺乏结构化分类的关键瓶颈。通过提供统一的SMPL参数化表示和三层语义分类法,它有效解决了运动类别不平衡、文本描述单一及跨场景泛化能力弱等学术难题。RoMo-SMPL的发布,使得研究者能够更为深入地探索细粒度运动生成、运动语义理解以及跨模态对齐等前沿方向,推动了人体运动表征与生成领域的标准化进程,对后续研究工作产生了深远的影响。
衍生相关工作
围绕RoMo-SMPL数据集,衍生出了一系列具有代表性的经典工作。诸如RoMo-HML-263和RoMo-HML-272等人体运动特征数据集,将原始SMPL参数转换为HumanML3D标准特征空间,方便与既有方法兼容对比。同时,基于该数据集的三层语义分类法,研究者开发了细粒度运动检索与条件生成方法,实现了按照类别、子类别乃至原子动作进行精确控制。此外,GVHMR姿态恢复方法与RoMo-SMPL的结合,推动了户外场景下人体运动重建精度的显著提升,并催生了更多关于运动语义标注和跨数据集迁移学习的创新性研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

