
Mikimi/phoible-voxangeles-formants-aggregated-audio-aggregated
收藏数据链接:
官方服务:
资源简介:
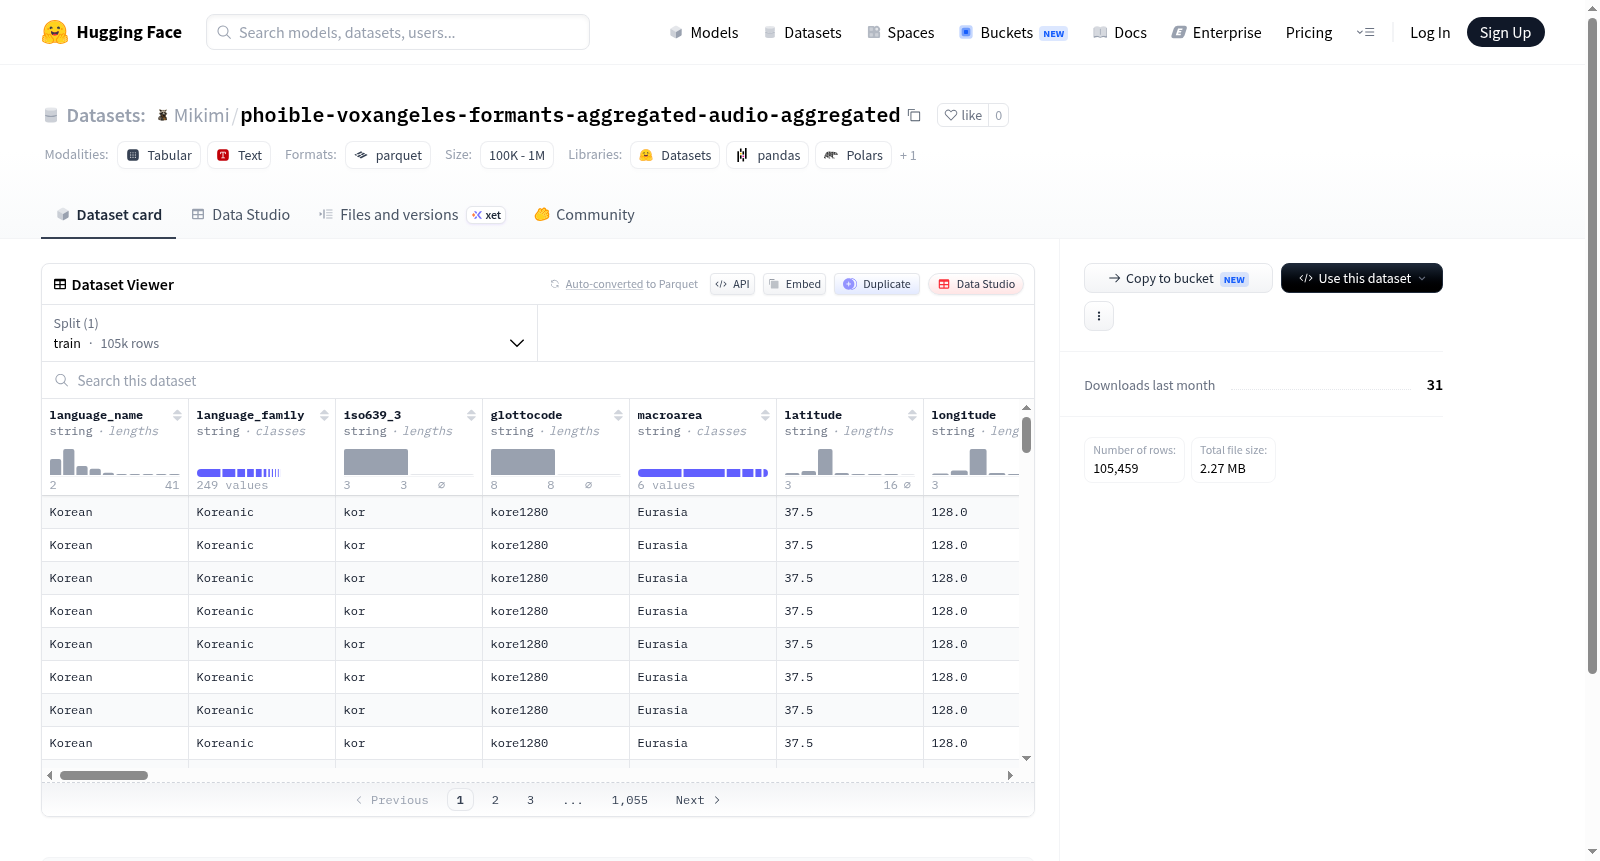
该数据集包含语言学或语音学相关数据,涵盖多种语言的信息,如语言名称、语系、ISO 639-3代码、Glottocode、地理区域、经纬度,以及音素相关的特征,包括音素IPA表示、基础音素、音段类别、边缘性标志、是否有音频、音段数量、F0到F5的共振峰频率值、共振峰距离(赫兹和巴克单位)、努力代理特征、Lobanov和Nearey归一化的共振峰值,以及一系列语音学特征(如音调、重音、音节性、辅音性、响音性、连续性、延迟释放、近似音、拍音、颤音、鼻音、边音、唇音、圆唇、唇齿音、冠状音、前部音、分布性、刺耳性、背音、高低音、前后音、紧张性、舌根前后移动、周期性声门源、上喉源、声门展开、声门收缩、强音、喉头升高挤喉音、喉头降低内爆音、点击音)。数据集还包含实现ID列表,并划分为训练集,用于可能的语音分析、语言比较或机器学习任务。
提供机构:
Mikimi搜集汇总
数据集介绍
构建方式
该数据集基于PHOIBLE音位清单数据库与VoxAngeles声学测量项目融合构建而成,汇聚了来自众多语系的语言音位实例。通过将原始语音音频信号进行标准化处理,提取了包括基频F0及前五个共振峰频率在内的声学参数,并计算了共振峰距离与发音努力指数等衍生特征。此外,针对每位发音人的声学空间,采用了Lobanov与Nearey两种归一化方法对共振峰数据进行校正,以确保跨语言比较的可靠性与准确性。数据集最终以聚合音频与聚合格式呈现,每个样本对应一个特定语言中的音位及其对应的声学测量值。
使用方法
该数据集以HuggingFace Datasets库的标准格式存储,用户可通过指定配置名'default'直接加载训练集。加载后,每条数据包含语言元数据、音位标注、声学测量值、归一化共振峰、发音特征及实现ID列表等字段。适用于构建跨语言语音识别模型、音位分类器,或进行声学空间的语言类型学分析。使用者可根据'phoneme_ipa'或'segment_class'字段对数据进行筛选,按语言或音位类别分组后开展后续统计建模或可视化工作。推荐利用Python的pandas库进行数据探索,或结合scikit-learn等工具直接应用特征列进行机器学习任务。
背景与挑战
背景概述
该数据集由跨语言语音学领域的研究机构构建,创建于近年,旨在整合大规模跨语言音位共振峰数据。其核心研究问题聚焦于探索不同语言音位系统的声学特征模式,特别是通过分析元音和辅音的形式频率(F0-F5)来揭示人类语音产生的普遍性与特异性。数据集融合了PHOIBLE音位清单与VoxAngeles声学测量资源,为计算语音学、语言类型学以及语音识别技术提供了宝贵的标准化基准,显著推动了多语言声学-音系映射关系的量化研究。
当前挑战
该数据集着力应对两大挑战:其一是语言学领域中长期存在的跨语言声学数据碎片化问题——先前研究常局限于少数语言或孤立声学参数,难以支撑系统性类型学分析;其二是构建过程中面临的多源数据对齐难题,需处理不同语料库间采样协议、说话人差异及标注粒度不一致等问题。此外,数据集需确保声学特征的多维度表征(如Lobanov与Nearey归一化参数)在极端音位系统(如带声调或复杂辅音列的语言)中的适用性,并克服因录音环境异质性带来的信噪比波动,最终实现十万余条实例的高效整合与验证。
常用场景
经典使用场景
该数据集汇集了来自PHOIBLE和VoxAngeles语料库的跨语言音位清单与声学测量数据,涵盖105459条音位实例及其对应的共振峰频率、基频等声学特征。研究者常将其用于语音学与音系学交叉领域的探索,例如基于共振峰数据(如F1、F2、F3)分析不同语言中元音和辅音的声学空间分布规律,或结合Lobanov、Nearey等归一化方法消除发音人差异,以揭示跨语言音位系统的共性与变异。其丰富的特征标注(如声调、圆唇度、舌位高低等)使得细粒度的音位分类与对比研究成为可能。
解决学术问题
该数据集有效解决了语音学研究中长期面临的数据碎片化与标准不统一问题。通过整合多语言音位清单与对应声学特征,它支持学者系统性地探究音位范畴的声学实现与跨语言普遍性规律,例如检验共振峰距离与发音努力度之间的关联假设。此外,归一化的声学特征(如F1_lobanov)为量化分析提供了可比基础,有助于推进音位感知与产出机制的理论建模。该资源极大地降低了获取大规模、高一致性语音数据的门槛,助力语音类型学与演化语言学领域的定量研究。
实际应用
在实际层面,该数据集对语音合成与识别系统的开发具有重要价值。其包含的归一化共振峰数据可用于改进多语种文本转语音系统,通过模拟不同语言的声学模式提升合成语音的自然度。同时,基于音位特征与声学参数的对应关系,可辅助训练声学模型以更精准地识别罕见音位,尤其适用于低资源语言的语音技术研发。在语言教育领域,该数据亦能支撑发音纠错系统的设计,通过对比学习者的共振峰分布与标准数据,实现针对性的语音反馈。
数据集最近研究
最新研究方向
该数据集融合了PHOIBLE全球音位清单与VoxAngeles的音频语料,通过聚合105,459条音位实例的声学特征(如共振峰F1–F5、基频F0)与语言学特征信息,为跨语言语音学研究提供了多维度的数据基石。当前前沿方向聚焦于利用其丰富的声学参数(如Lobanov与Nearey归一化共振峰)训练机器学习模型,以探索音位实现的普遍声学模式与语言类型学约束间的深层关联。同时,结合计算语音学与生理声学特征(如发声努力代理指标),该数据集正助力推动语言演化动力学与音位系统涌现机制的研究,为理解人类语音多样性背后的共性规律开辟了新路径。
以上内容由遇见数据集搜集并总结生成


