
遇见数据集

media-metadata-musicbrainz-artists

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

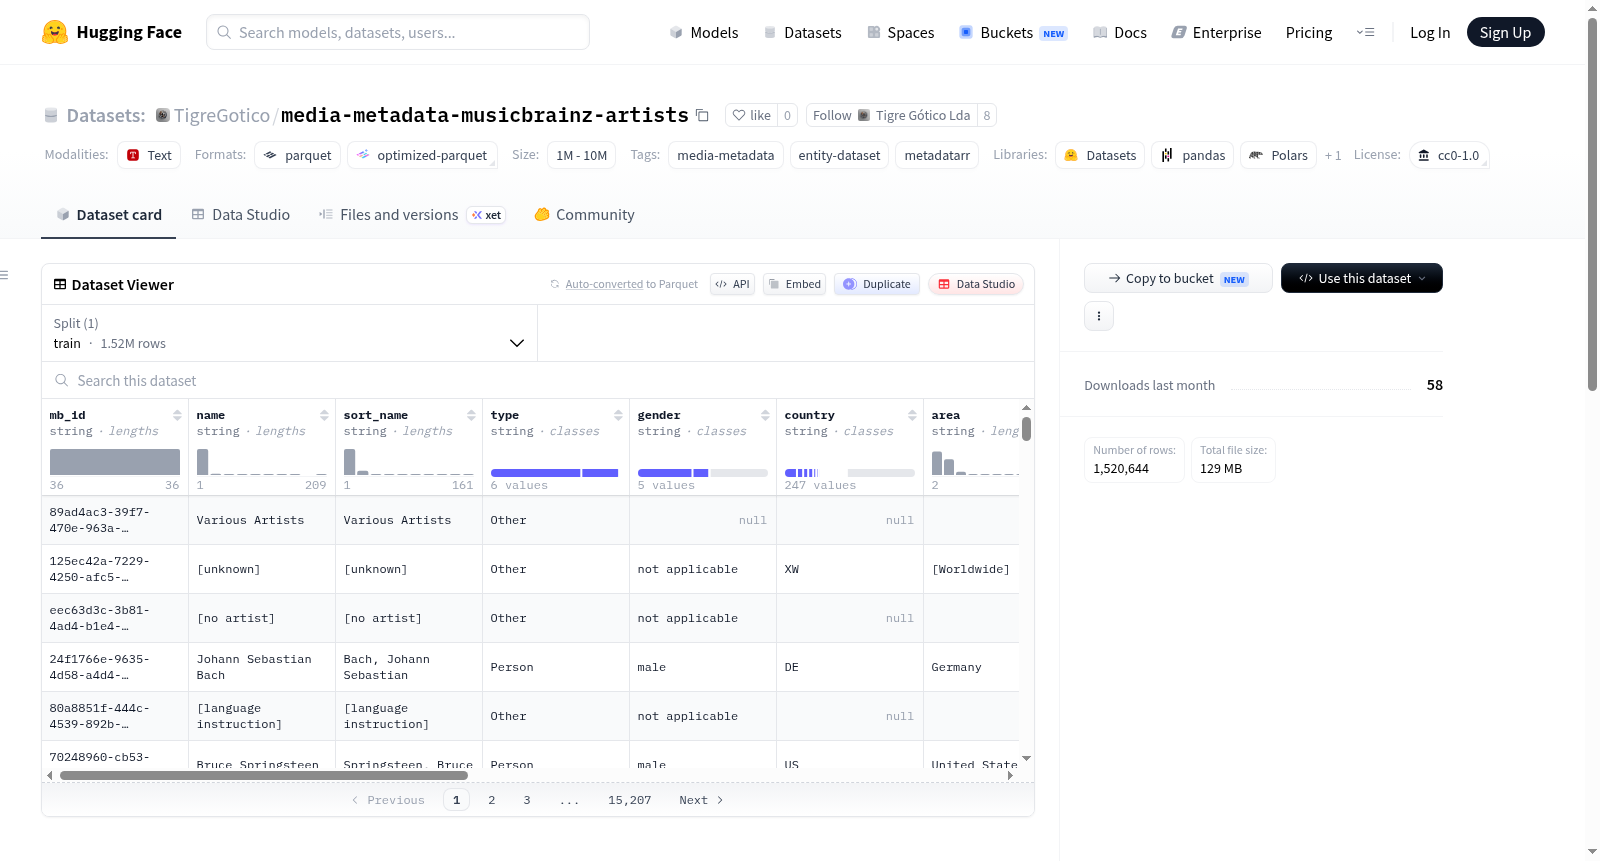
该数据集是一个丰富的实体数据集,由TigreGotico使用metadatarr项目中的`musicbrainz_artists`爬虫从MusicBrainz抓取并整理而成。数据集专注于音乐艺术家相关的媒体元数据,包含超过152万条艺术家记录。每条记录包含15个结构化字段,详细描述了艺术家的各类属性,包括:唯一标识符(`mb_id`)、名称(`name`, `sort_name`)、类型(`type`,如个人、团体等)、性别(`gender`)、国家(`country`)、所属地区(`area`)、职业生涯起止日期(`begin_date`, `end_date`)及是否已结束的标志(`ended`)、用于区分同名实体的说明(`disambiguation`)、别名列表(`aliases`)、用户或社区添加的标签(`tags`),以及专业的版权识别码(`ipi_codes`, `isni_codes`)。该数据集适用于需要大规模、结构化音乐艺术家信息的任务,例如:音乐知识图谱的构建与填充、艺术家实体解析与消歧、媒体库元数据增强、音乐信息检索研究以及数字版权管理相关的应用。

This dataset is a rich entity dataset, crawled and organized by TigreGotico from MusicBrainz using the `musicbrainz_artists` scraper from the metadatarr project. It focuses on media metadata related to music artists, containing over 1.52 million artist records. Each record includes 15 structured fields that detail various attributes of artists, such as: unique identifier (`mb_id`), name (`name`, `sort_name`), type (`type`, e.g., individual, group), gender (`gender`), country (`country`), area (`area`), career start and end dates (`begin_date`, `end_date`) and the ended flag (`ended`), disambiguation for distinguishing entities with the same name (`disambiguation`), alias list (`aliases`), tags added by users or communities (`tags`), and professional copyright identification codes (`ipi_codes`, `isni_codes`). The dataset is suitable for tasks requiring large-scale, structured music artist information, such as: construction and population of music knowledge graphs, artist entity resolution and disambiguation, metadata enhancement for media libraries, music information retrieval research, and applications related to digital rights management.
创建时间:
2026-06-26
搜集汇总
数据集介绍
media-metadata-musicbrainz-artists 数据集图片
构建方式
该数据集由TigreGotico团队利用metadatarr工具中的musicbrainz_artists爬虫模块,从MusicBrainz开源音乐百科平台系统性地采集而来。爬虫程序通过调用MusicBrainz的API接口,逐页遍历并抽取艺术家的元数据字段,经过数据清洗与结构化处理后,汇聚成包含超过152万条记录的丰富实体数据集。整个构建流程基于可复现的流水线设计,源代码托管于metadatarr仓库中,保证了数据采集的透明性与可扩展性。
使用方法
用户可通过HuggingFace Datasets库直接加载使用,例如使用load_dataset函数指定数据集名称即可获取数据。加载后的数据集可转换为Pandas DataFrame格式,便于进行后续的数据分析、特征工程或模型训练。数据集以紧凑的表格形式存储,每个字段均具备明确的类型定义,用户可根据需要选取特定字段进行查询或统计。特别适合用于音乐推荐系统开发、艺术家关系网络分析、音乐知识图谱构建以及跨平台实体对齐等任务,同时也为音乐学研究和音乐产业数据分析提供了标准化的数据基础。
背景与挑战
背景概述
在数字音乐生态系统中,艺术家元数据是音乐信息检索、推荐系统及版权管理的重要基石。然而,主流数据库中艺术家信息的分散与不一致性长期困扰着学术研究与工业应用。media-metadata-musicbrainz-artists数据集应运而生,由TigreGotico团队于2023年通过metadatarr爬取工具从MusicBrainz社区数据库中提取并构建,包含超过152万条艺术家记录。该数据集聚焦于多维度元数据的结构化整合,涵盖标识符、别名、活跃时期与地理信息等关键字段,旨在为音乐信息学、跨语言实体对齐以及知识图谱构建等领域提供可靠的数据支撑,其发布标志着面向大规模实体元数据的开源资源迈入新阶段。
当前挑战
该数据集所应对的核心领域挑战在于音乐艺术家实体的歧义性与元数据的碎片化问题:同一艺术家在不同语言或地域中可能存在多名称变体,而现有数据库常缺乏统一的消歧机制。此外,数据集构建过程中面临的技术挑战尤为显著,包括从MusicBrainz海量API接口中高效爬取并解析异构数据、处理部分艺术家记录的字段缺失与日期格式不一致,以及维护近150万条记录中别名、标签等复杂嵌套结构的完整性。同时,数据集的持续更新能力受限,源数据的动态变化要求构建者设计可扩展的增量抓取策略,以确保长期可用性。
常用场景
经典使用场景
在音乐信息检索与知识图谱构建的学术领域,media-metadata-musicbrainz-artists数据集因其收录了逾152万条艺术家实体的丰富元数据而备受青睐。该数据集整合了来自MusicBrainz的艺术家身份标识、名称、别名、性别、国籍、地域、活跃时间以及ISNI和IPI编码等多维属性,为音乐实体链接、艺术家消歧、音乐风格分类及艺术家生涯建模等研究提供了标准化的数据基石。研究者常利用其结构化的字段设计,开展跨语种别名挖掘、艺术家类型识别以及地理-文化关联分析等经典任务,进而推动音乐本体库的精细化构建。
解决学术问题
该数据集有效解决了音乐领域长期存在的艺术家实体异构性与元数据碎片化问题。通过统一收录艺术家在全球音乐生态中的多重标识(如ISNI、IPI),为跨数据库实体对齐与知识融合提供了关键桥梁。学术研究中,它助力攻克了艺术家名称歧义消除、群体与个人艺术家的类型判别、以及基于时空维度的艺术家生涯演化规律挖掘等核心难题。其深远意义在于,为构建大规模、高质量的音乐领域知识图谱奠定了实体层基础,促进了音乐学与计算机科学的交叉创新。
实际应用
实际应用中,该数据集为流媒体平台的艺术家主页构建、版权管理系统的权属信息匹配以及音乐推荐引擎的冷启动问题提供了坚实的数据支撑。在数字音乐档案馆中,它可辅助自动化地补全艺术家传记中的缺失信息,提升馆藏元数据的完整性与互操作性。音乐出版社与版权结算机构亦可利用其ISNI/IPI编码字段,精准对接全球版权数据库,实现高效的作品确权与版税分配。此外,基于艺术家类型和地域标签,商业推荐系统能生成更具文化敏感性的个性化歌单。
数据集最近研究
最新研究方向
当前,媒体元数据在推荐系统、版权管理与音乐信息检索领域扮演着关键角色。media-metadata-musicbrainz-artists数据集汇聚了超过152万艺术家的丰富实体信息,涵盖从规范名称、国籍、性别到ISNI编码等多元属性,为构建细粒度的艺术家知识图谱提供了坚实的数据基石。前沿研究正利用此类数据集探索基于图神经网络的音乐人相似度计算、跨地域文化传播路径分析,以及艺术家生涯演化建模。随着生成式AI对版权溯源需求的激增,该数据集在训练音乐作品归属识别模型、支持创作者权益保护方面展现出不可替代的价值,推动了音乐产业数字化治理的纵深发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

