emotional-roleplay-finetuning-dataset-flattened
收藏资源简介:
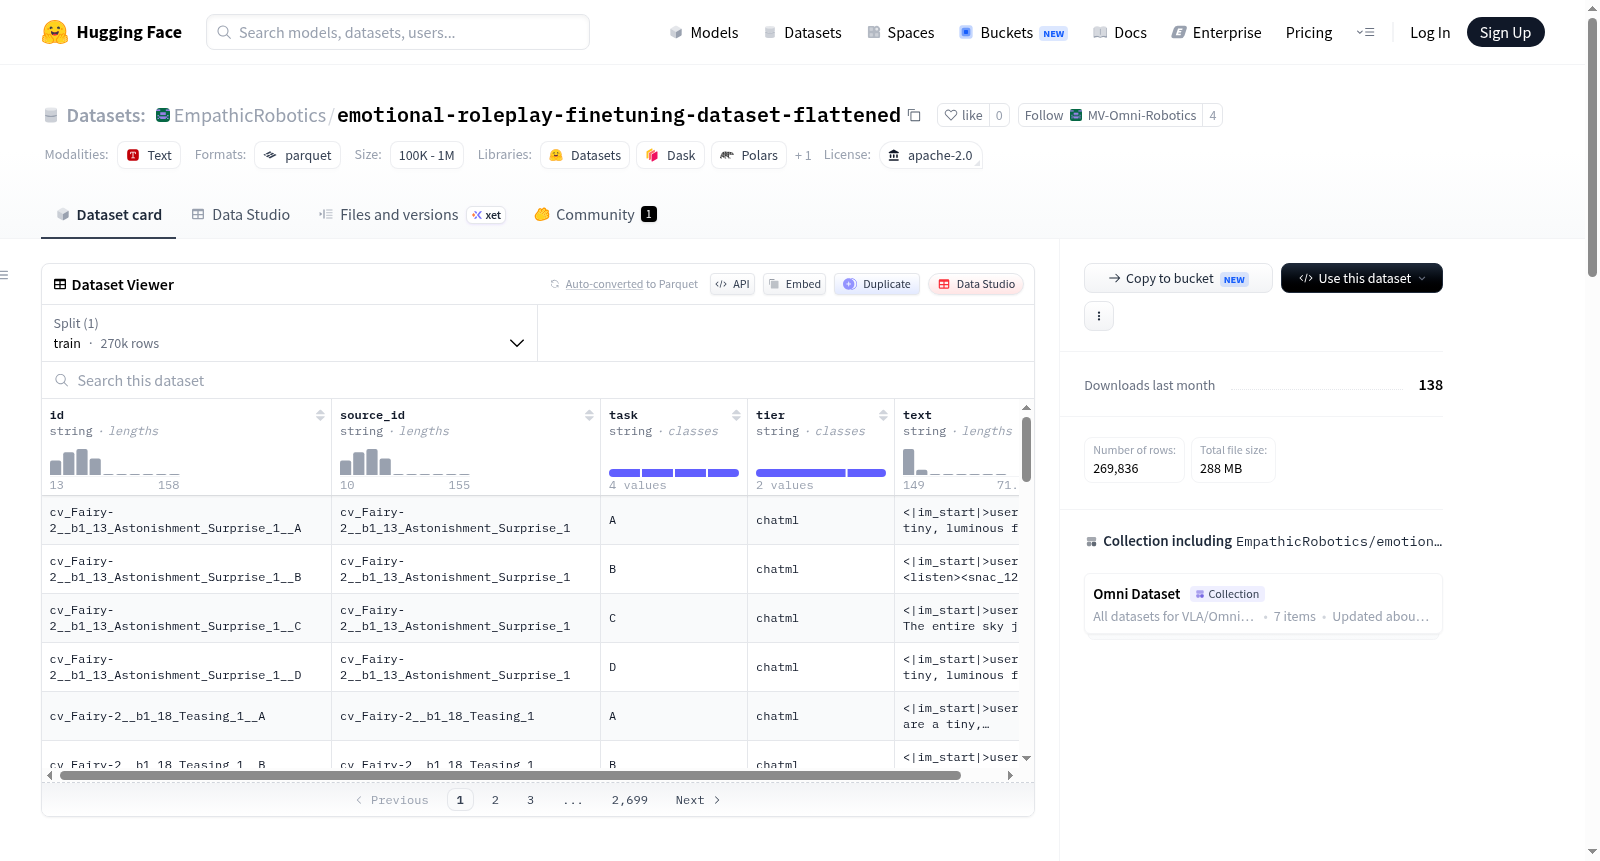
该数据集是laion/emotional-roleplay-finetuning-dataset的格式标准化版本(v5,多任务,speakfix),专为情感角色扮演对话系统的微调设计。它包含269,836条训练记录,源自67,459个源样本(合成TTS语音片段及文本),每个源样本扩展为4个任务:任务A(生成:文本指令预测语音token)、任务B(ASR:语音转文本)、任务C(语音转语音描述,生成语气/风格描述)、任务D(纯文本指令生成语音描述)。数据集采用2层聊天模板:英语且一致性评分≥4的行使用ChatML格式(<|im_start|>user),其余行使用基础USER:/ASSISTANT:格式。v5版本修复了speak标记的使用,确保仅英语任务A的助手侧包含<speak>音频token,非英语任务A被替换为听力理解任务(用户侧使用<listen>音频,助手回答文本),其他任务中speak被降采样为listen。数据集包含字段:id(行ID)、source_id(源行ID)、task(任务类型A/B/C/D)、tier(模板层级,如ChatML或base)、text(实际对话文本)。所有数据均经过SNAC token化(7 token/帧),仅包含训练集分割。适用于多任务语音角色扮演模型训练,包括语音合成、语音识别、情感与语气描述生成等任务,许可证为Apache 2.0。
This dataset is a standardized version (v5, multi-task, speakfix) of the laion/emotional-roleplay-finetuning-dataset, specifically designed for fine-tuning emotional role-play dialogue systems. It contains 269,836 training records derived from 67,459 source samples (synthetic TTS speech clips and text), with each source sample expanded into four tasks: Task A (generation: text instruction predicts speech tokens), Task B (ASR: speech to text), Task C (speech to speech description, generating tone/style descriptions), and Task D (pure text instruction generating speech description). The dataset uses a two-tier chat template: rows with English and consistency score ≥4 use ChatML format (<|im_start|>user), while others use the basic USER:/ASSISTANT: format. The v5 version fixes the use of speak tokens, ensuring only English Task A includes <speak> audio tokens on the assistant side; non-English Task A is replaced with a listening comprehension task (user side uses <listen> audio, assistant answers text); in other tasks, speak is downsampled to listen. The dataset includes fields: id (row ID), source_id (source row ID), task (task type A/B/C/D), tier (template level, e.g., ChatML or base), text (actual dialogue text). All data is SNAC tokenized (7 tokens/frame) and contains only the training split. Suitable for multi-task speech role-play model training, including speech synthesis, speech recognition, emotion and tone description generation, etc. Licensed under Apache 2.0.
数据集概述
名称: emotional-roleplay-finetuning-dataset-flattened
发布者: EmpathicRobotics
许可证: Apache-2.0
数据集大小: 约1.22GB(下载大小约583.7MB)
样本数量: 训练集共269,836条记录(由67,459个源数据行 × 4个任务生成)
数据特征
每条记录包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
id |
string | 唯一标识符 |
source_id |
string | 源数据行标识符 |
task |
string | 任务类型(A/B/C/D) |
tier |
string | 分层模板类型(ChatML或base) |
text |
string | 文本内容 |
任务结构
每个源数据行生成4个不同的任务:
- 任务A(主任务/生成): 根据指令、语音描述和语言提示生成
<speak>音频 - 任务B: 音频转文本(ASR,自动语音识别)
- 任务C: 文本+音频 → 语音特征描述(语气/风格)
- 任务D: 仅指令 → 语音特征描述(纯文本,低成本)
模板分层机制
根据质量指标将数据分为两层:
- ChatML层(
<|im_start|>user格式): 仅当语言为英语且adherence_score ≥ 4时使用,共20,659行(占30.63%) - Base层(
USER:/ASSISTANT:格式): 其余46,800行
所有数据行均被保留,未丢弃任何样本。
v5版本关键修复
本版本(2026-08-02)针对v4进行了两项重要修正:
-
非英语任务A替换: 原版本中所有行都会生成
<speak>音频,但因仅34.4%的源数据行为英语,导致大量非英语音频被用于训练。v5将44,241条非英语行替换为"听力理解"任务——用户侧使用降采样的<listen>音频,助手侧以纯文本回答,复用原有真实转录和语音描述。 -
<speak>不进入用户侧: 所有任务中,用户侧不再出现<speak>块,统一降采样为<listen>格式(每帧从7个token降至3个token,保留L0/L1a/L1b频段,数学上精确无损)。
数据验证结果
<speak>出现次数: 23,218次(恰好等于英语任务A的行数)<listen>出现次数: 179,159次(= 67,459×2 + 44,241,算术完全匹配)- 用户侧任何任务中
<speak>出现次数: 0
基础来源
数据源自laion/emotional-roleplay-finetuning-dataset(67,491个合成TTS语音片段及对应文本,其中67,459条有效行被采用),音频使用SNAC进行分词(完整L0+L1a+L1b+L2频段,每帧7个token)。