
土家语双语数据集
收藏数据链接:
官方服务:
资源简介:
利用AI技术数字化抢救、保护北部土家语(龙山标准音),构建土家语双语数据集,包含词汇、短句文本及音频标注,用于ASR、TTS、翻译等模型训练。
This bilingual Tujia language dataset is developed via AI-powered digital rescue and preservation of the Northern Tujia language (Longshan standard pronunciation). It encompasses vocabulary, short sentence texts and audio annotations, and is intended for training models including ASR, TTS and machine translation.
创建时间:
2026-08-01
原始信息汇总
数据集概述:TujiaNLP
项目定位
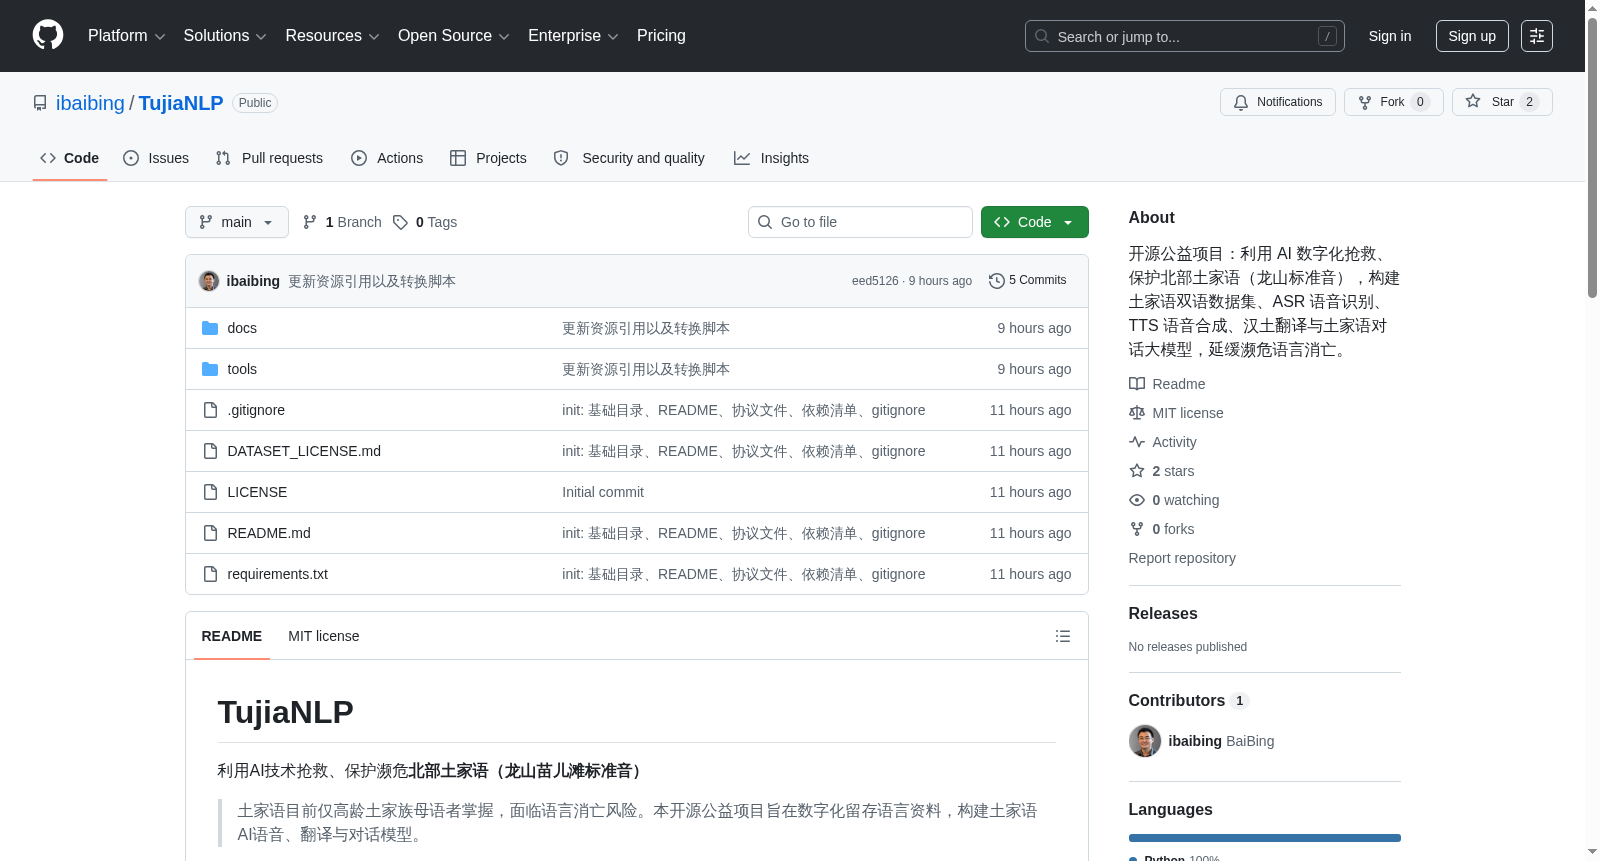
TujiaNLP 是一个致力于抢救和数字化保护濒危语言——北部土家语(以龙山苗儿滩标准音为主) 的开源公益项目。项目通过采集田野录音、构建双语标注数据集,并训练 AI 模型(语音识别、合成、翻译及对话),旨在留存语言资料并开发学习工具。
语言与书写范围
- 目标语言:北部土家语(涵盖龙山、永顺、来凤片区),暂不包含南部土家语,以避免方言混杂。
- 书写标准:统一采用 叶德书-彭秀模 1984 土家语拼音方案,禁止混用海外 Brassett 拼音,并提供两套拼音转换工具(位于
tools/)。
数据集内容与结构
- 主要目录:
dataset/:包含双语词汇、短句文本数据(原始音频不存入 Git 仓库)。docs/:规范文档、学术资料及田野采集模板。tools/:数据集处理、录音工具及拼音转换脚本。speech/:ASR(语音识别)与 TTS(语音合成)的训练代码。translation/:汉土双语翻译模型代码。llm/:对话流水线脚本及大模型微调实验代码。demo_web/:静态网页演示(词典、翻译、发音工具)。
- 数据格式:文本数据以 CSV/JSON 格式存储,涵盖词汇和例句。
技术栈与硬件
- 开发设备:Mac Studio M2 Ultra(128GB),基于 MLX 框架进行本地离线训练/推理。
- 语音模型:OpenAI Whisper(语音识别)、VITS 与 FishSpeech(语音合成)。
- 大语言模型底座:Qwen 系列(原生适配 MLX)。
- 开发语言:Python 3.11+。
项目目标与进展
- 短期目标:田野音频采集、构建规范双语数据集、训练 ASR 与 TTS、实现汉-土翻译模型。
- 长期目标:搭建对话 AI(模块化流水线→LLM 微调)、开发轻量学习工具。
- 当前进度:仅完成 GitHub 仓库初始化,其余任务(数据采集、模型训练、Web Demo 等)均处于待完成状态。
开源协议与伦理规范
- 程序源代码:MIT License。
- 文本数据集(CSV/JSON):CC-BY-SA 4.0。
- 田野原始音频:遵循每位受访者单独签署的知情同意约定。
- 伦理要求:田野录音需获取受访者知情同意,严格保护隐私,采集素材不可私自商用。
参与贡献
欢迎土家族同胞(协助田野录音、语义校对)、AI/NLP 开发者(模型微调、代码优化)、语言学爱好者(扩充词汇、整理语法)共同参与。
搜集汇总
数据集介绍
构建方式
该数据集以北部土家语(龙山苗儿滩标准音)为核心,通过田野调查采集高龄母语者的语音素材,并严格遵循知情同意伦理规范。所有音频均依据叶德书-彭秀模1984年拼音方案进行规范化转写,构建双语词汇与短句文本库。项目采用模块化流水线架构,兼顾ASR、TTS及翻译模型的训练需求,确保数据标注的准确性与一致性。
特点
数据集聚焦濒危的北部土家语,具有鲜明的方言纯净性与标准化特点。统一采用1984年拼音方案,避免方言混杂,保障模型训练质量。数据集包含双语词汇、短句文本及原始音频,覆盖语音识别、合成、翻译等多维度应用。开源协议区分程序代码、文本数据与音频权限,兼容学术研究与公益传承需求。
使用方法
使用者可通过GitHub仓库获取数据集及配套工具。文本数据以CSV/JSON格式存储,便于直接加载;原始音频需遵循个体授权协议。项目提供拼音转换脚本、录音工具及处理脚本,支持模型微调。开发者可基于开源代码训练土家语ASR/TTS模型,或利用demo_web快速部署词典、翻译及发音演示应用,助力语言学习与保护。
背景与挑战
背景概述
土家语作为汉藏语系藏缅语族的一支,是土家族文化传承的珍贵载体,然而当前仅由高龄母语者掌握,正濒临消亡危机。为借助人工智能技术抢救这一濒危语言,土家语双语数据集应运而生。该数据集由一群致力于语言保护的研究者与志愿者共同构建,项目于近年启动,依托龙山县苗儿滩的标准音,聚焦北部土家语(龙山/永顺/来凤片区),旨在通过系统化的田野采集与规范标注,留存语音与文本资源。其核心研究问题涵盖语音识别(ASR)、语音合成(TTS)、机器翻译及对话系统构建,力图打造一套完整的土家语数字化工具链。该项目的开源精神与跨学科协作模式,为濒危语言保护提供了新范式,对计算语言学和语言复兴实践具有重要示范意义,其成果有望推动更多语言资源的智能化保存与传播。
当前挑战
该数据集面临着多层面的严峻挑战。就领域问题而言,土家语作为低资源语言,缺乏大规模标注数据,语音与文本的获取困难,且方言差异显著,南北土家语在音系与词汇上差异较大,混合使用会干扰模型训练,这要求数据采集必须精准限定片区,且需克服方言变体带来的建模难题。在构建过程中,田野录音需遵循严格的伦理规范,确保受访者知情同意并保护隐私,同时统一采用叶德书-彭秀模拼音方案,需摒弃音系差异较大的海外Brassett拼音,保证标注一致性。硬件上,虽采用Mac Studio M2 Ultra,但本地训练与推理仍受算力限制,且开源社区力量有限,模型微调与工具链迭代周期长。此外,数据版权与使用许可明确分离,需依法规管理原始音频,平衡数据共享与隐私保护。这些挑战考验着项目团队的协作智慧与持久投入,也凸显了低资源语言人工智能发展的系统性障碍。
常用场景
经典使用场景
该数据集作为濒危语言数字化保护的基石,最经典的使用场景在于构建土家语语音识别(ASR)与语音合成(TTS)系统。研究者可依托规范化的双语标注音频,利用Whisper等预训练模型进行增量微调,实现从土家语语音到文本的精准映射,并借助VITS等模型合成自然流畅的土家语语音,从而为语言教学、文化传承提供交互式语音技术支撑,开创AI赋能濒危语言保护的先河。
实际应用
在实际应用中,该数据集的赋能领域广泛而深远。其衍生的智能学习工具可为土家族青少年提供发音评测、双语词典查询与互动对话练习,助力语言习得与日常使用。同时,基于该数据的实时翻译系统可服务于旅游导览、民俗文化展示等场景,促进土家语在公共生活中的可见度与活跃度,为文化数字遗产的保护与活化注入科技动能,展现AI技术在社会公益领域的独特价值。
衍生相关工作
该数据集激发了多项开创性的衍生研究。在模型层面,基于MLX框架的本地化训练探索了高效低资源语音处理范式,并催生了面向土家语的双语翻译模型与对话流水线;在工具层面,开发了拼音互转工具和田野采集规范,为其他濒危语言的数据治理提供了可复用的技术模板。这些工作不仅拓宽了NLP的应用边界,还构建了语言学、人类学与AI交叉融合的生态,引领了濒危语言数字化保护的新方向。
以上内容由遇见数据集搜集并总结生成


