
遇见数据集

Apakose-Ezekiel/farahan-yoruba-elder-corpus

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

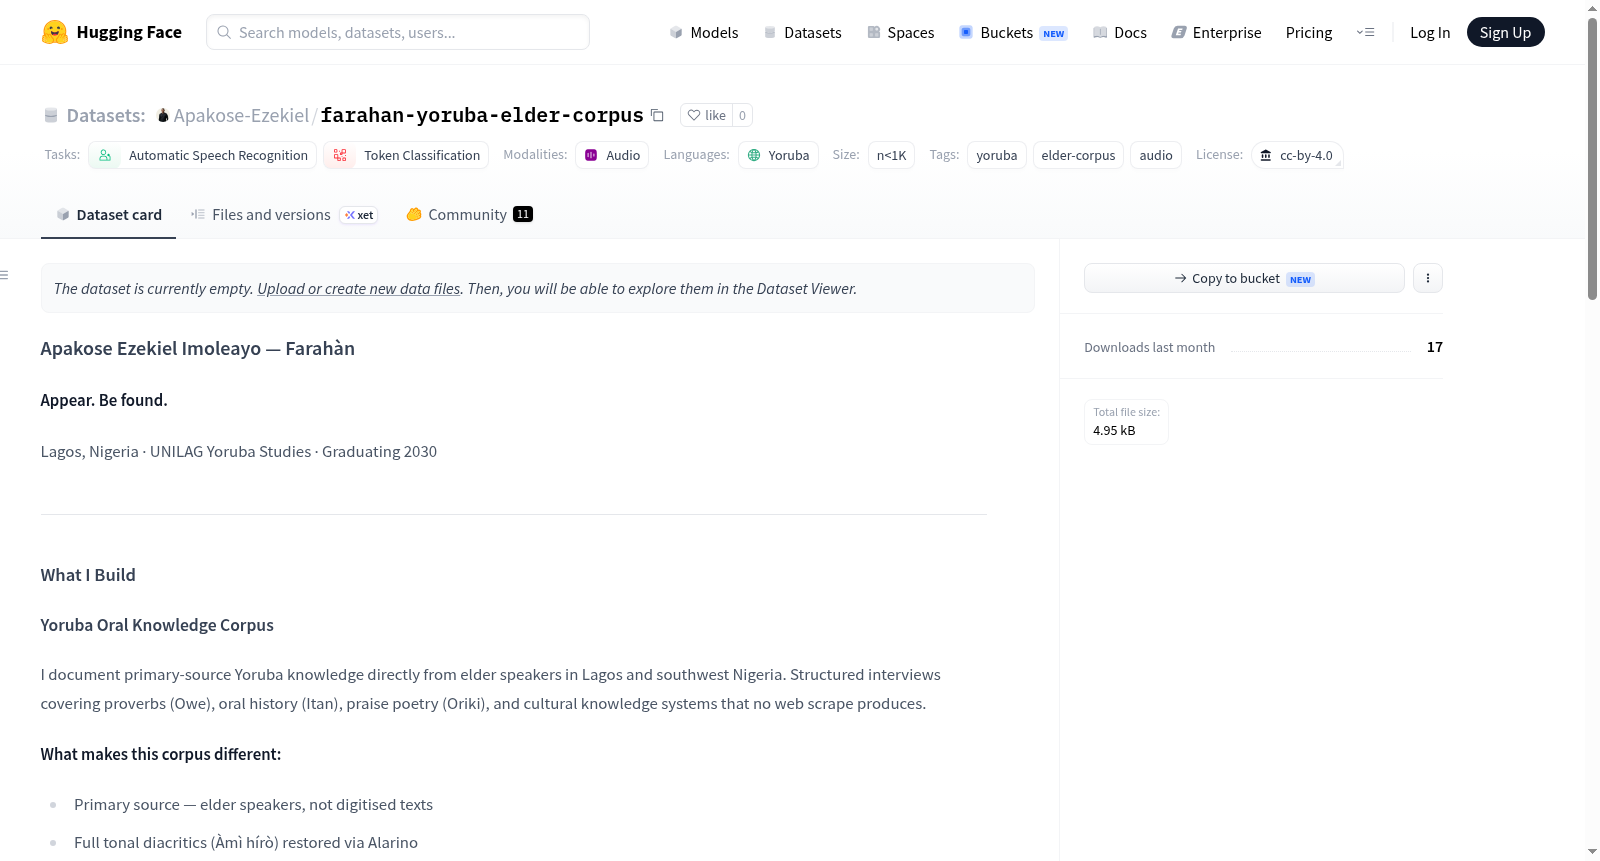
Farahàn Yoruba Elder Corpus 是一个专注于约鲁巴语(一种非洲声调语言)的数据集,旨在解决声调歧义问题。它包含约鲁巴语长者的访谈语料,每个条目在发声时都进行了声调标注,确保声调标记作为语义数据的一部分,而不是可选的元数据。该数据集用于支持NLP任务,如文本分类和词元分类,特别关注低资源语言和声调语言的处理,以改善下游任务如命名实体识别、机器翻译和语言建模的性能。

The Farahàn Yoruba Elder Corpus is a dataset focused on the Yoruba language, a tonal African language, designed to address tonal disambiguation issues. It contains interview transcripts from Yoruba elders, with each entry annotated for tone at the point of utterance, ensuring tonal marks are integral semantic data rather than optional metadata. This dataset supports NLP tasks such as text classification and token classification, particularly for low-resource and tonal languages, aiming to enhance performance in downstream applications like named entity recognition, machine translation, and language modeling.
提供机构:
Apakose-Ezekiel
搜集汇总
数据集介绍
Apakose-Ezekiel/farahan-yoruba-elder-corpus 数据集图片
构建方式
Farahan Yoruba Elder Corpus(FYEC)是在尼日利亚拉各斯及西南部地区,通过对约鲁巴族老年社群进行结构化访谈构建而成的。语料直接源自母语者口述,而非数字化文本,全面覆盖谚语(Owe)、口述历史(Itan)、赞美诗(Oriki)及文化知识体系。所有内容均以JSONL格式存储,并经由Alarino工具恢复完整的声调符号(Àmì hírò),同时标注了Oyo、Lagos、Ekiti、Ijebu和Ondo五种方言变体。文化元数据包括视觉场景描述,为多模态AI训练提供了丰富的基础。
特点
该语料库的核心特色在于其原始性与文化敏感性。所有音频与文本均来自长者原声,保留了约鲁巴语在自然语境下的真实语音和语调。每条记录都包含方言标注、声调恢复以及文化敏感性分类,确保对神圣与敏感内容的保护。语料库规模虽小(n<1K),但专为低资源非洲语言的自然语言处理(NLP)任务设计,适用于语音识别、文本转语音、词性标注及多模态生成模型,弥补了当前约鲁巴语数字化语料的稀缺。
使用方法
研究人员可通过HuggingFace平台直接加载该数据集,将其集成至自动语音识别(ASR)、命名实体识别(NER)或文本转语音(TTS)等NLP管线中。数据以JSONL格式提供,便于与HuggingFace Datasets、PyTorch或TensorFlow等框架无缝对接。使用时,用户可根据方言标签、文化分类或敏感性等级进行子集筛选。该语料库特别适合用于约鲁巴语教育平台、非洲文化保护项目,以及面向低资源语言的模型微调与基准测试。
背景与挑战
背景概述
Farahan Yoruba Elder Corpus是由尼日利亚拉各斯大学约鲁巴研究学者Apakose Ezekiel Imoleayo于近期创建的数据集,旨在系统性地记录约鲁巴长者口述知识。该数据集聚焦于西非约鲁巴语社群中的谚语(Owe)、口述历史(Itan)、赞美诗(Oriki)等文化知识体系,填补了现有语料库主要依赖数字化文本而忽略原生口述资源的空白。其独特之处在于全额保留声调变音符号(Àmì hírò)、跨方言标注(覆盖奥约、拉各斯、埃基提等五地),并嵌入文化敏感分类机制以保护神圣内容。作为低资源非洲语言自然语言处理领域的开创性基准,该数据集为多模态模型、语音合成系统和语言模型微调提供了稀缺的非洲文化语境数据,有望推动约鲁巴语在人工智能时代的传承与可见性。
当前挑战
该数据集面临的核心挑战在于解决低资源非洲语言在自然语言处理中的系统性匮乏问题。约鲁巴语的声调系统、方言多样性及口语文化特性(如谚语的隐喻结构)导致现有模型难以准确理解与生成,而传统语料库因依赖二手文本丢失了原始语境。构建过程中,研究者需克服长老口述的跨代语言变迁、现场录音环境噪声干扰(如拉各斯城市背景音)以及文化敏感性标注的主观性难题。此外,方言间的词汇差异与语法变体增加了一致性标注的复杂度,而神圣内容的伦理保护要求研发定制化分类器以避免算法偏见。这些挑战共同制约了数据集规模扩展与跨领域迁移应用。
常用场景
经典使用场景
Farahan Yoruba Elder Corpus 作为一项专注于约鲁巴语口语知识的珍贵语料库,其经典使用场景主要面向低资源非洲语言的语音识别与命名实体识别任务。该数据集收录了来自拉各斯及尼日利亚西南部地区年长讲者的结构化访谈内容,涵盖谚语、口述历史、赞美诗等文化知识体系,并完整保留了声调变音符号。研究者和开发者可利用此语料库训练约鲁巴语的自动语音识别系统,或进行文化敏感性的标记分类,为多模态AI模型提供具有非洲文化根基的原始语料支持。
解决学术问题
该数据集有效解决了非洲低资源语言在自然语言处理研究中面临的语料匮乏与声调标注缺失的学术难题。通过采集第一手原始素材而非数字化文本,并借助Alarino工具恢复完整的声调变音符号,Farahan Yoruba Elder Corpus为约鲁巴语的语音识别、文本转语音及语言模型微调提供了标准化基准。其文化敏感性分类机制还保护了神圣内容,为跨文化NLP研究树立了伦理规范,推动了低资源非洲语言在学术领域的可计算化进程,对语言保护与人工智能的融合具有深远意义。
衍生相关工作
围绕该数据集已衍生出多项经典工作,包括基于Alarino工具的约鲁巴语声调变音符号恢复研究,以及针对低资源非洲语言的语音识别模型fine-tuning工作。此外,研究者利用其文化敏感性分类标志开展跨文化NLP伦理框架的探索,推动了标注伙伴关系与学术合作。该语料库还与尼日利亚市场AI搜索可见性项目相结合,衍生出面向语义摩擦问题的GEO与AEO基础设施工作,显著提升了本地语言在西方训练AI系统中的语义对齐能力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

