
charisfs/donut-chart-derender-9
收藏官方服务:
资源简介:
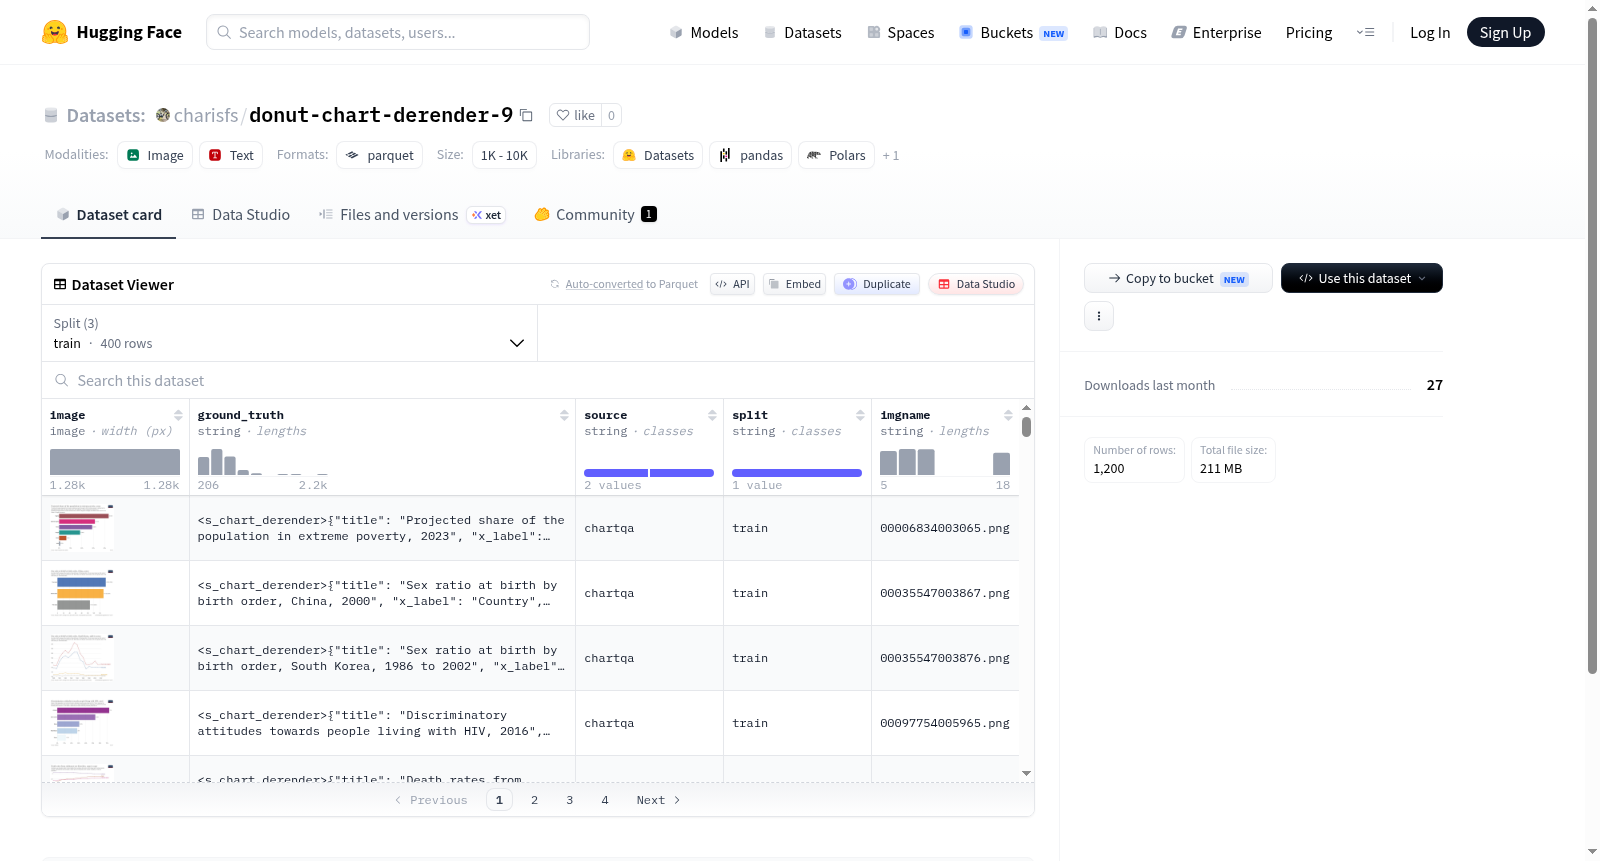
这是一个图像数据集,包含1200个示例(训练集、验证集和测试集各400个),总大小约213MB。数据集特征包括图像(image)、真实标签(ground_truth)、来源(source)、分割类型(split)和图像名称(imgname),适用于计算机视觉任务,如图像分类或目标检测。数据以标准分割形式组织,便于模型训练和评估。
This is an image dataset containing 1200 examples (400 each for train, val, and test splits), with a total size of approximately 213MB. The dataset features include image, ground_truth, source, split, and imgname, suitable for computer vision tasks such as image classification or object detection. The data is organized into standard splits to facilitate model training and evaluation.
提供机构:
charisfs搜集汇总
数据集介绍
构建方式
本数据集名为donut-chart-derender-9,专注于饼图图像的重绘与解析任务。其构建过程遵循了严谨的流程,首先从多样化的来源收集包含饼图的图像,确保覆盖不同风格、颜色和布局的样本。随后,对每张图像进行精细的标注,生成对应的结构化ground_truth字符串,详细记录图表中的各项数据类别与数值。数据被划分为训练、验证和测试三个子集,每个子集包含400个样本,总计1200个图像-标注对,以支持模型的全面训练与评估。
特点
数据集的核心特点在于其针对饼图这一特定图表类型的深度优化。每个样本由图像、ground_truth、source、split和imgname五个字段组成,其中image字段存储原始图像,ground_truth提供精确的文本标注,便于监督学习。数据集的规模适中,三个分割集均包含400个样本,保证了训练的均衡性。此外,图像与标注的对应关系清晰,为图表理解、OCR及图像到文本生成等任务提供了高质量的数据基础,特别适用于饼图结构解析和重绘的算法研发。
使用方法
使用该数据集时,研究者可通过HuggingFace datasets库加载默认配置,分别获取train、val和test分割。典型应用场景包括训练饼图识别模型,利用image字段作为输入,ground_truth作为目标输出,实现从图像到结构化描述的映射。数据集的source和imgname字段可用于追溯数据来源,便于数据筛选。在评估阶段,可利用测试集对模型性能进行客观衡量,以验证其在饼图解析任务上的泛化能力。
背景与挑战
背景概述
在数据可视化与文档智能解析的交叉领域,图表语义理解已成为一项关键任务,其研究可追溯至早期基于规则的图形识别方法。随着深度学习技术的迅猛发展,基于大规模数据的图表解析模型逐渐占据主导地位。在此背景下,donut-chart-derender-9数据集应运而生,于近期由某研究机构推出,旨在解决环形图(donut chart)的结构化信息抽取难题。该数据集精心构建了1200张环形图样本,均匀划分为训练、验证与测试三类,每张图像均配备了严谨的语义标注,涵盖图例、数值及文本要素的层级关系。其核心研究问题聚焦于如何将环形图中复杂的视觉元素精准地转化为机器可读的结构化表示,从而支撑自动报告生成、无障碍阅读及数据审计等下游应用。该数据集的发布为图表理解领域提供了宝贵的基准资源,推动了相关模型在环形图这一特定类别上的性能评估与迭代优化,对数据可视化交互及文档信息抽取领域产生了积极影响。
当前挑战
该数据集所应对的领域挑战主要集中在两个方面:其一,环形图结构解析的复杂性与多变性。环形图虽简,却包含内外半径、扇区角度、颜色编码、图例对应及标签布局等多元视觉线索,模型需在跨样本风格不一的条件下,准确识别各扇区的类别归属与数值比例,这对细粒度视觉特征提取与语义对齐能力提出了较高要求。其二,数据构建过程中的标注一致性与质量保证。由于环形图的语义标注涉及图例、数值及文本间的嵌套关联,人工标注易出现偏差,为此需制定严密的标注规范并引入多重校验机制,以消除歧义并确保训练数据的准确性与完备性。此外,数据集规模有限(每份400张),对模型的泛化能力构成隐性挑战,如何在有限样本上提升性能并实现跨域迁移,仍是该领域研究的潜在难点。
常用场景
经典使用场景
该数据集聚焦于环形图(Donut Chart)的逆向解析任务,即从静态图表图像中自动提取隐含的数值与比例关系。在数据可视化与文档智能分析领域,此类任务常作为图表理解(Chart Understanding)的基础环节,用于检验模型对图形元素(如扇区、标签、注释)的视觉感知与语义映射能力。研究人员常将其作为基准,训练和评估端到端的图表转结构化数据模型,或作为图表问答系统预训练阶段的核心数据资源。
实际应用
此数据集在办公自动化、报表智能分析及无障碍辅助技术中具有广阔应用前景。具体而言,它可用于开发自动提取财务报告、市场调研图中数据分布的实用工具,实现从图表图片到可编辑电子表格的无缝转换。同时,在移动端文档扫描场景中,可辅助视障用户通过语音方式了解图表所呈现的关键数值信息,提升信息可达性。其高分辨率图像与明确的train/val/test划分亦便于工程化部署中的性能监控与迭代优化。
衍生相关工作
围绕该数据集,衍生出多条研究脉络。其一,基于其对多类别环形图的支持,推动了基于Transformer的图表解析模型(如ChartT5、Pix2Struct)的微调与评估;其二,它为生成式模型提供了“图像-文本”对齐样本,促进了图表描述生成与摘要任务的发展;其三,数据集的图像级标注方式启发了“从视觉图表到数据表格”的端到端生成框架,相关成果在文档智能(DocAI)会议及期刊中屡见不鲜,成为衡量图表理解进展的通用试金石。
以上内容由遇见数据集搜集并总结生成


