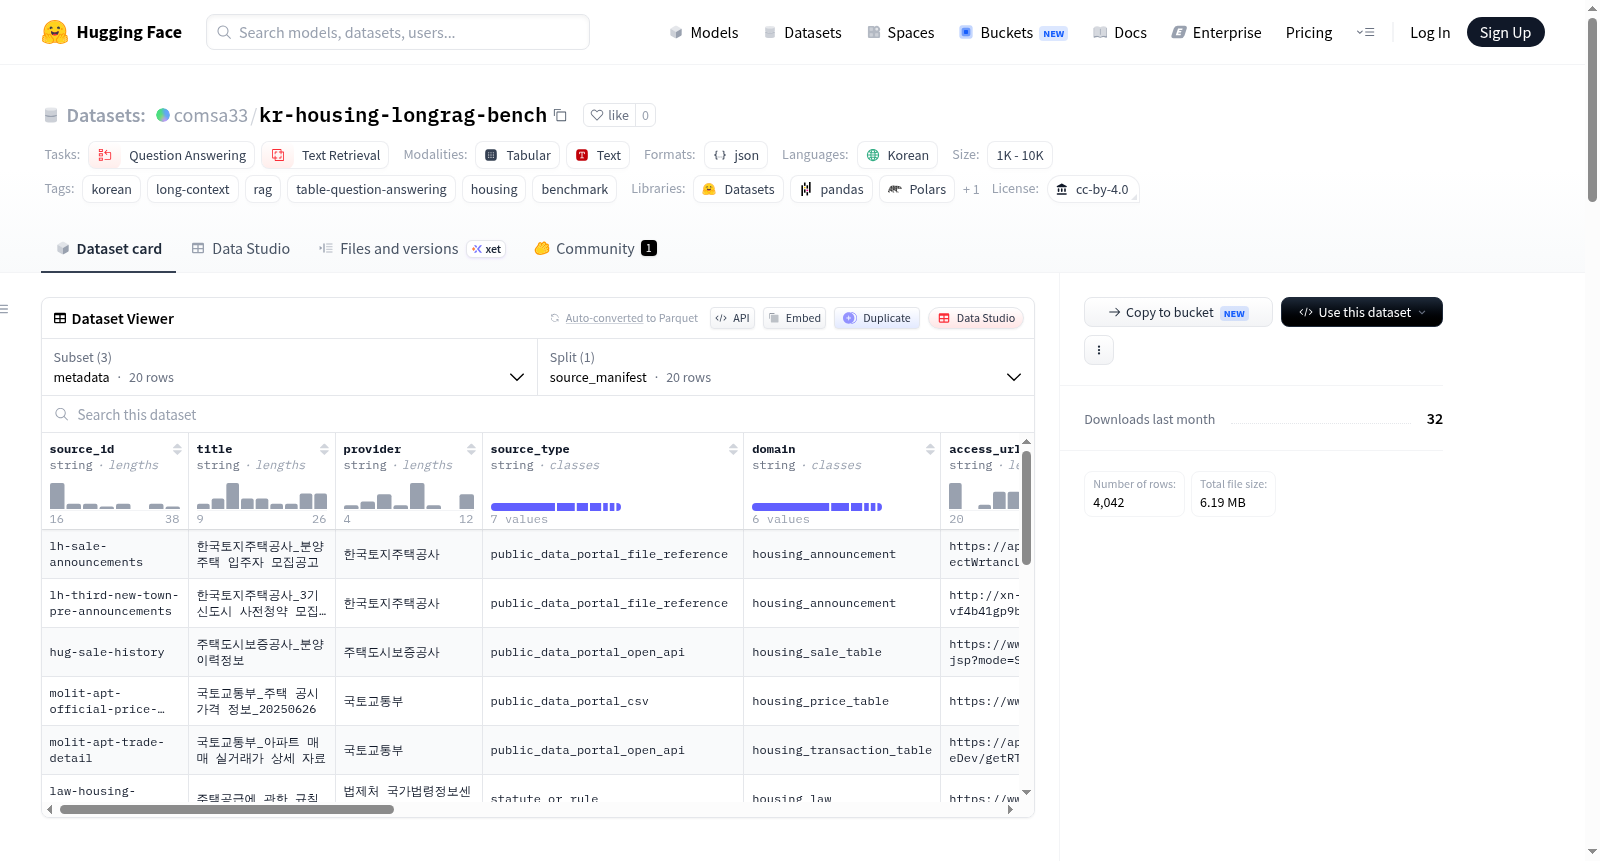
kr-housing-longrag-bench
收藏资源简介:
KR-Housing-LongRAG-Bench是一个韩语公共住房基准测试数据集,旨在评估长上下文大语言模型、检索增强生成系统以及表格/工具管道在官方住房公告、公共表格数据和住房法律证据上的性能。该数据集当前版本为v0.7(研究预览版),数据构建与v0.6版本相同。它包含2,011个问答对,划分为开发集(1,618个)、公开测试集(105个)和隐藏问题集(288个)。数据来源于10个公告提供者,覆盖9个韩国市道地区。问题风格多样,包括真实用户问题(605个)、专业分析师问题(1,250个)和诊断探针问题(156个),并识别出286个有效的近重复簇。数据集主要适用于问答和文本检索任务,特别针对韩语长上下文处理、RAG系统评估以及表格问答场景。已知注意事项包括:人工审核尚未完成;隐藏分割仅包含问题,答案被屏蔽;长上下文捆绑文本未包含在此数据包中;部分项目为诊断探针而非自然用户问题。基准注释采用CC BY 4.0许可证发布。
KR-Housing-LongRAG-Bench is a Korean public housing benchmark dataset designed to evaluate the performance of long-context large language models, retrieval-augmented generation systems, and table/tool pipelines on official housing announcements, public form data, and housing legal evidence. The current version is v0.7 (research preview), with data construction identical to v0.6. The dataset contains 2,011 question-answer pairs, divided into a development set (1,618), a public test set (105), and a hidden question set (288). Data is sourced from 10 announcement providers, covering 9 Korean municipal regions. Question styles are diverse, including real user questions (605), professional analyst questions (1,250), and diagnostic probe questions (156), with 286 effective near-duplicate clusters identified. It is primarily suitable for question answering and text retrieval tasks, especially for Korean long-context processing, RAG system evaluation, and table question answering scenarios. Known caveats include: manual review is not yet complete; the hidden split contains only questions with answers masked; long-context bundled text is not included in this data package; and some items are diagnostic probes rather than natural user questions. The benchmark annotations are released under the CC BY 4.0 license.
数据集概述
KR-Housing-LongRAG-Bench 是一个面向韩国公共住房领域的基准测试数据集,旨在评估长上下文大语言模型、检索增强生成系统以及表格/工具流程在官方住房公告、公开表格数据和住房法律证据上的表现。
核心特性
- 语言:韩语 (
ko) - 许可证:CC BY 4.0
- 任务类别:问答、文本检索
- 标签:韩语、长上下文、RAG、表格问答、住房、基准测试
- 版本状态:
v0.7研究预览版,底层数据集构建与v0.6相同(之前的数据发布版本为v0.6.3)
数据集规模
- 总问答数量:2,011 条
- 公开数据划分:
- dev:1,618 条(包含答案)
- test_public:105 条(包含答案)
- test_hidden:288 条(仅含问题,答案已屏蔽,黄金谓词为空,黄金行ID为空)
- 数据来源:
- 公告提供方:10 个
- 公告覆盖区域:9 个
시도(韩国广域行政区)
- 问题类型分布:
- 真实用户问题:605 条
- 专业分析师问题:1,250 条
- 诊断探测问题:156 条
- 有效近似重复聚类数:286 个
数据集包含的文件
| 文件 | 划分 | 描述 |
|---|---|---|
data/dev.jsonl |
dev | 包含答案 |
data/test_public.jsonl |
test_public | 包含答案 |
data/test_hidden_questions.jsonl |
test_hidden | 答案被屏蔽;黄金谓词和黄金行ID为空 |
data/prompts.jsonl |
prompts | 仅定位器提示输入(公开安全) |
data/source_manifest.jsonl |
metadata | 来源注册与许可状态 |
data/task_schema.json |
metadata | QA 模式定义 |
注意:本数据集不包含原始PDF/HWP/HWPX文档、提取的文档文本、捆绑文本、API密钥或隐藏的黄金答案。长上下文捆绑文本未在数据包中重新分发,需通过 GitHub 仓库从官方来源 URL 重建本地捆绑包。
加载方式
使用 datasets 库加载:
python from datasets import load_dataset
qa = load_dataset("comsa33/kr-housing-longrag-bench", "qa") prompts = load_dataset("comsa33/kr-housing-longrag-bench", "prompts")
print(qa["dev"][0]) print(prompts["prompts"][0])
评估方法
通过 GitHub 仓库中的官方评估器进行评分:
bash git clone https://github.com/comsa33/kr-housing-longrag-bench.git cd kr-housing-longrag-bench python3 scripts/eval_harness_v06.py --pred predictions.jsonl
预测文件格式要求:
json {"qa_id": "krhlrb_v05_0001", "prediction": "your model answer"}
评估器会报告按数据划分、任务类型和问题风格计算的原始准确率和聚类加权准确率。
已知限制
- 人工审查结果尚未完成
- 隐藏划分仅包含问题,黄金答案未在数据包中分发
- 部分问题为诊断探测问题,并非自然用户问题
- 该基准为研究预览版,并非最终封闭的排行榜基准
引用信息
若使用本数据集,请引用 v0.7 版本(通过其 Zenodo 版本化DOI):
@dataset{lee_kr_housing_longrag_bench_v07_2026, author = {Lee, Ruo}, title = {KR-Housing-LongRAG-Bench}, year = {2026}, version = {v0.7 (research-preview; dataset build v0.6)}, publisher = {Zenodo}, doi = {10.5281/zenodo.20570856}, url = {https://doi.org/10.5281/zenodo.20570856}, note = {Research-preview release (baseline scaffold + smoke diagnostics) over the unchanged v0.6 dataset build; the v0.6 data is archived as v0.6.3 (versioned DOI 10.5281/zenodo.20563604).} }
- 概念 DOI:
10.5281/zenodo.20559127(始终指向最新版本) - v0.6 数据构建归档版本:v0.6.3(版本化 DOI:
10.5281/zenodo.20563604)
相关资源
- GitHub 仓库:
https://github.com/comsa33/kr-housing-longrag-bench - Zenodo 记录:
https://doi.org/10.5281/zenodo.20559127