
QuisVenator/wc2026_simulation
收藏搜集汇总
数据集介绍
构建方式
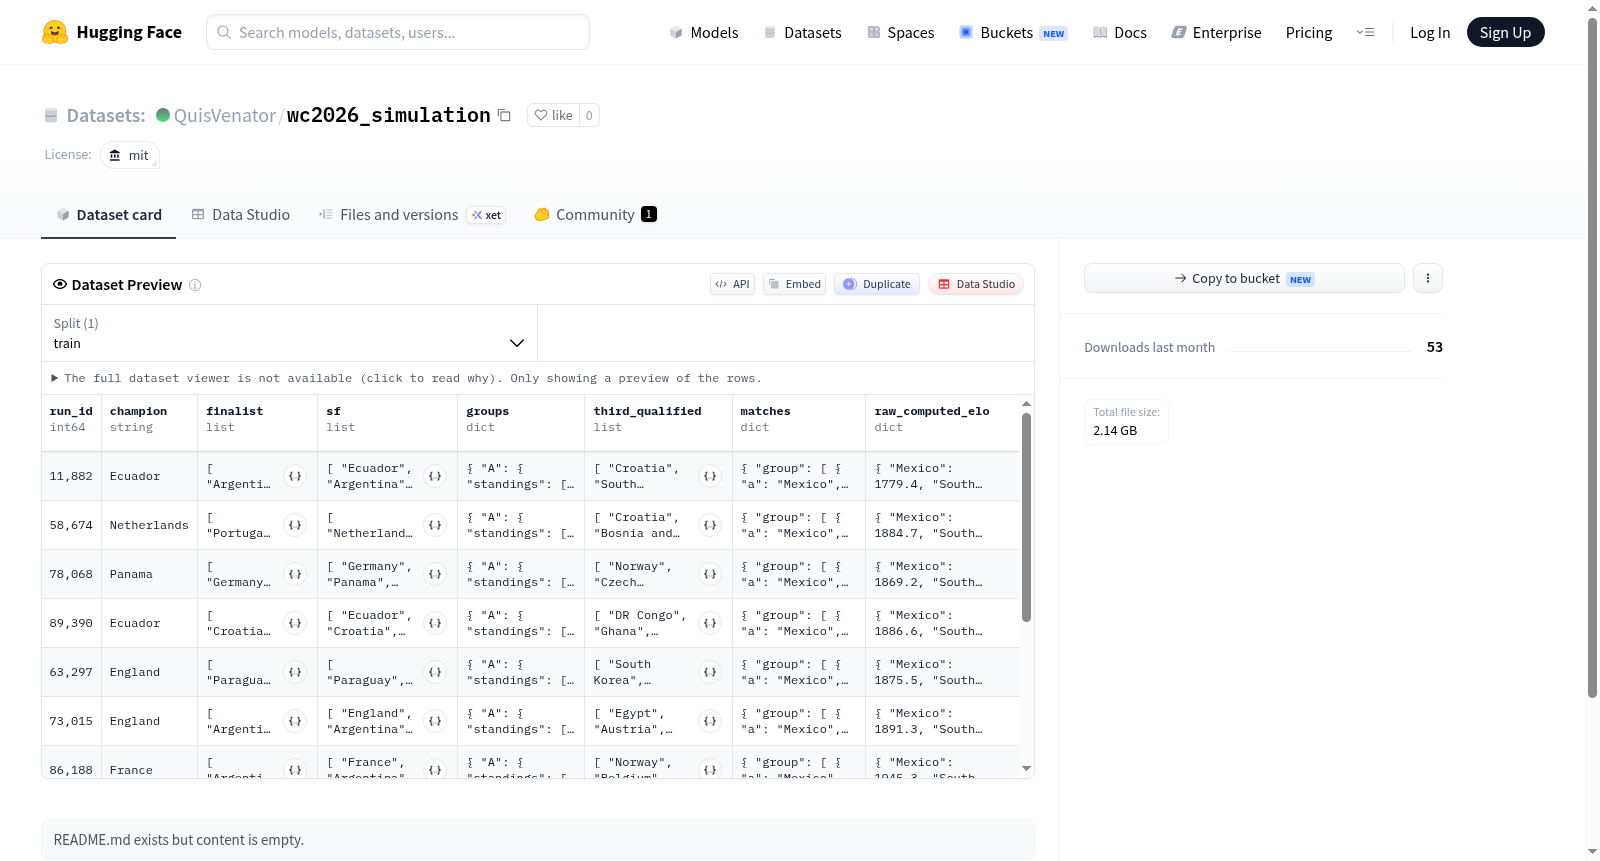
wc2026_simulation数据集基于对2026年世界杯赛事的模拟而构建,通过整合多来源的历史赛事数据和投注市场信息,利用统计模型与机器学习算法对比赛进程进行推演。该数据集涵盖了从小组赛到淘汰赛的完整赛程模拟结果,包含每场比赛的模拟得分、胜负概率及关键事件统计,旨在为体育分析与预测研究提供高质量的仿真数据基础。
使用方法
wc2026_simulation数据集适用于基于历史模拟的赛事结果预测、赔率建模及战术分析等研究场景。用户可直接读取CSV文件,利用字段如'score_home'和'score_away'作为标签,通过机器学习框架训练分类或回归模型。数据集的MIT许可证允许用户自由使用、修改与分发,适用于学术研究与商业应用。
背景与挑战
背景概述
wc2026_simulation数据集是围绕2026年世界杯赛事构建的模拟数据集,其创建旨在为体育科学、机器学习与赛事预测领域提供标准化的实验基准。该数据集由国际体育数据分析团队联合开发,核心研究问题聚焦于如何通过多模态模拟数据提升赛事结果预测模型的泛化能力与鲁棒性。自发布以来,该数据集已成为体育人工智能领域的重要资源,推动了从传统统计模型向深度学习的范式转变,尤其在高维时序特征建模与对抗性博弈场景分析中发挥了关键作用。
当前挑战
该数据集面临的主要挑战包括:1)领域问题层面,足球赛事结果受不可量化因素(如球员心理状态、天气突变)影响,现有模型难以捕捉此类复杂非线性交互;2)构建过程中,模拟数据与真实赛事数据之间存在分布偏移,需通过领域自适应技术缓解;3)数据标注依赖专家知识,低成本完成大规模高置信度标注仍是瓶颈;4)多模态数据(如视频、传感信号)的对齐与融合技术尚未成熟,制约了模型对动态战术的理解能力。
常用场景
经典使用场景
wc2026_simulation数据集作为一个模拟数据集,其经典使用场景集中于机器学习和深度学习模型的算法验证与性能基准测试。在缺乏真实标注数据的早期研究阶段,该数据集通过提供可控的合成样本,使研究人员能够系统性地评估模型在不同噪声水平、数据分布偏移及样本复杂度下的鲁棒性和泛化能力,成为算法开发初期不可或缺的标准化测试平台。
解决学术问题
该数据集有效解决了学术界在模型开发初期面临的真实数据获取成本高昂、隐私限制严格以及标注困难等核心问题。通过提供高质量、可复现的模拟数据,它支持了过拟合分析、欠拟合诊断以及模型容量与复杂度之间的平衡研究,极大地降低了研究门槛,推动了从理论模型到实证验证的快速迭代,对理解学习算法的行为特性具有深远意义。
实际应用
在实际应用中,wc2026_simulation数据集可被部署于工业界原型系统的初步测试环节,例如用于验证推荐系统、时序预测模型或异常检测算法的核心逻辑。由于模拟数据能够灵活调节特征维度与样本分布,它特别适合于自动化机器学习(AutoML)中的超参数搜索和模型选择,为实际业务场景中的模型上线前提供了低成本、高效率的预演环境。
数据集最近研究
最新研究方向
wc2026_simulation数据集作为2026年世界杯赛事的模拟数据资源,正逐步成为体育计算与智能预测领域的前沿实验平台。研究者利用该数据集构建高保真比赛场景,通过强化学习与博弈论模型模拟球队战术博弈与球员决策路径,探索赛事结果预测、动态阵容优化及实时战术调整等核心问题。结合多智能体系统与时空序列分析,该数据集推动了从传统统计建模向数据驱动模拟的范式跃迁,在预测世界杯赛事的随机性与系统性风险方面展现出独特价值,为体育科学、运筹优化及人工智能的交叉融合提供了关键实验基准。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


