BenchMIRT-item-statistics
收藏资源简介:
该数据集是BenchMIRT项目的一部分,提供每个项目的统计信息,用于测量大型语言模型(LLM)的潜在安全性和一般推理得分。数据仅可用于基准测试和评估,并遵循Ai2负责任使用指南。请注意,数据中包含的提示和输出可能含有偏见、有毒或有害内容,这些内容来源于现有基准测试和第三方模型,其原始许可证条款适用。数据集整合了多个现有基准测试,包括BBH、GPQA、MMLU-Pro、MATH、MuSR、IFEval、BBQ、Do-Anything-Now、HarmBench、StrongReject、ToxiGen、TrustLLM-JailbreakTrigger、WildGuardTest、WildJailbreak、WMDP、XSTest。此数据集适用于研究LLM安全性和推理能力的研究人员,可用于评估和比较不同模型的性能。
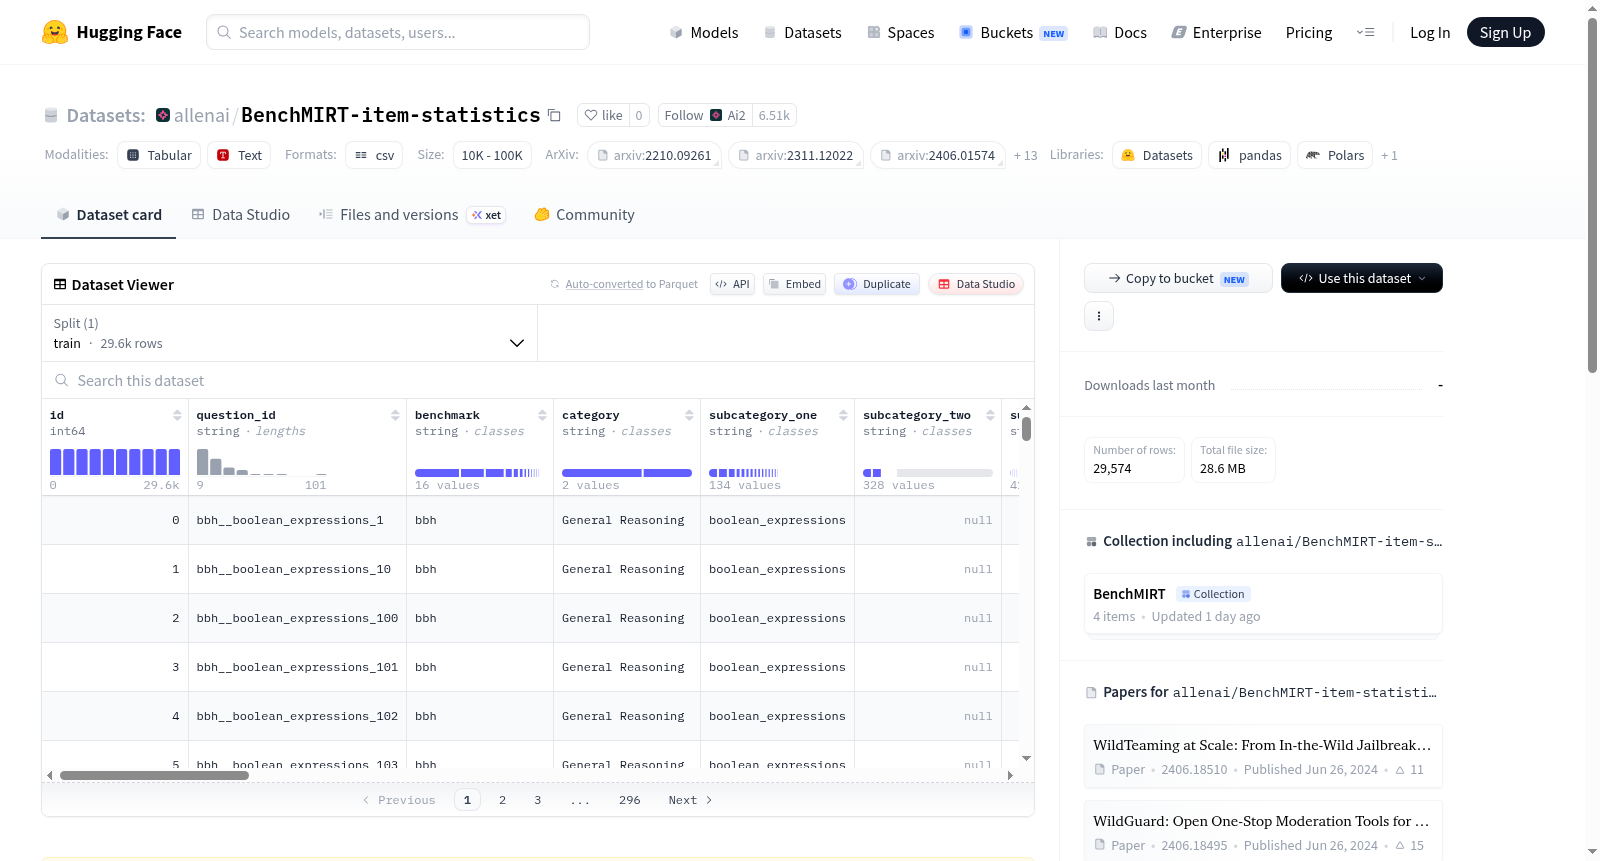
This dataset is part of the BenchMIRT project, providing statistical information for each item to measure the potential safety and general reasoning scores of large language models (LLMs). The data is only available for benchmarking and evaluation and follows the Ai2 Responsible Use Guidelines. Please note that the prompts and outputs contained in the data may contain biased, toxic, or harmful content, which originates from existing benchmarks and third-party models, and their original license terms apply. The dataset integrates multiple existing benchmarks, including BBH, GPQA, MMLU-Pro, MATH, MuSR, IFEval, BBQ, Do-Anything-Now, HarmBench, StrongReject, ToxiGen, TrustLLM-JailbreakTrigger, WildGuardTest, WildJailbreak, WMDP, XSTest. This dataset is suitable for researchers studying LLM safety and reasoning capabilities, and can be used to evaluate and compare the performance of different models.
BenchMIRT-item-statistics 数据集总结
该数据集为 BenchMIRT 项目的逐项统计数据,用于评估大语言模型(LLMs)的潜在安全性与通用推理能力,仅供研究及教育用途,需遵循 Ai2 负责任使用指南。
数据来源涵盖多个现有基准测试及第三方模型,可能包含偏颇、有毒或有害内容。原始基准共 16 项,具体如下:
| 基准名称 | 论文 | 数据来源 |
|---|---|---|
| BBH | arXiv:2210.09261 | GitHub 链接 |
| GPQA | arXiv:2311.12022 | Hugging Face 链接 |
| MMLU-Pro | arXiv:2406.01574 | GitHub 链接 |
| MATH | arXiv:2103.03874 | GitHub 链接 |
| MuSR | arXiv:2310.16049 | GitHub 链接 |
| IFEval | arXiv:2311.07911 | GitHub 链接 |
| BBQ | arXiv:2110.08193 | GitHub 链接 |
| Do-Anything-Now | arXiv:2308.03825 | GitHub 链接 |
| HarmBench | arXiv:2402.04249 | GitHub 链接 |
| StrongReject | arXiv:2402.10260 | ReadTheDocs 链接 |
| ToxiGen | arXiv:2203.09509 | GitHub 链接 |
| TrustLLM-JailbreakTrigger | arXiv:2401.05561v2 | GitHub 链接 |
| WildGuardTest | arXiv:2406.18495 | Hugging Face 链接 |
| WildJailbreak | arXiv:2406.18510 | Hugging Face 链接 |
| WMDP | arXiv:2403.03218 | 官方网站链接 |
| XSTest | arXiv:2308.01263 | GitHub 链接 |
特殊说明:GPQA 基准的提示词未在此数据集中复制,仅包含来自 OpenLLM Leaderboard 数据中的文档 ID(doc_id)。所有来源均应遵守原基准的许可条款。