
Polygl0t/gigalekh-v1
收藏官方服务:
资源简介:
该存储库包含一个大型印地语文本语料库,该语料库已使用教育内容和毒性分类器进行了过滤和标注。该数据集旨在用于训练印地语的语言模型和其他自然语言处理应用。
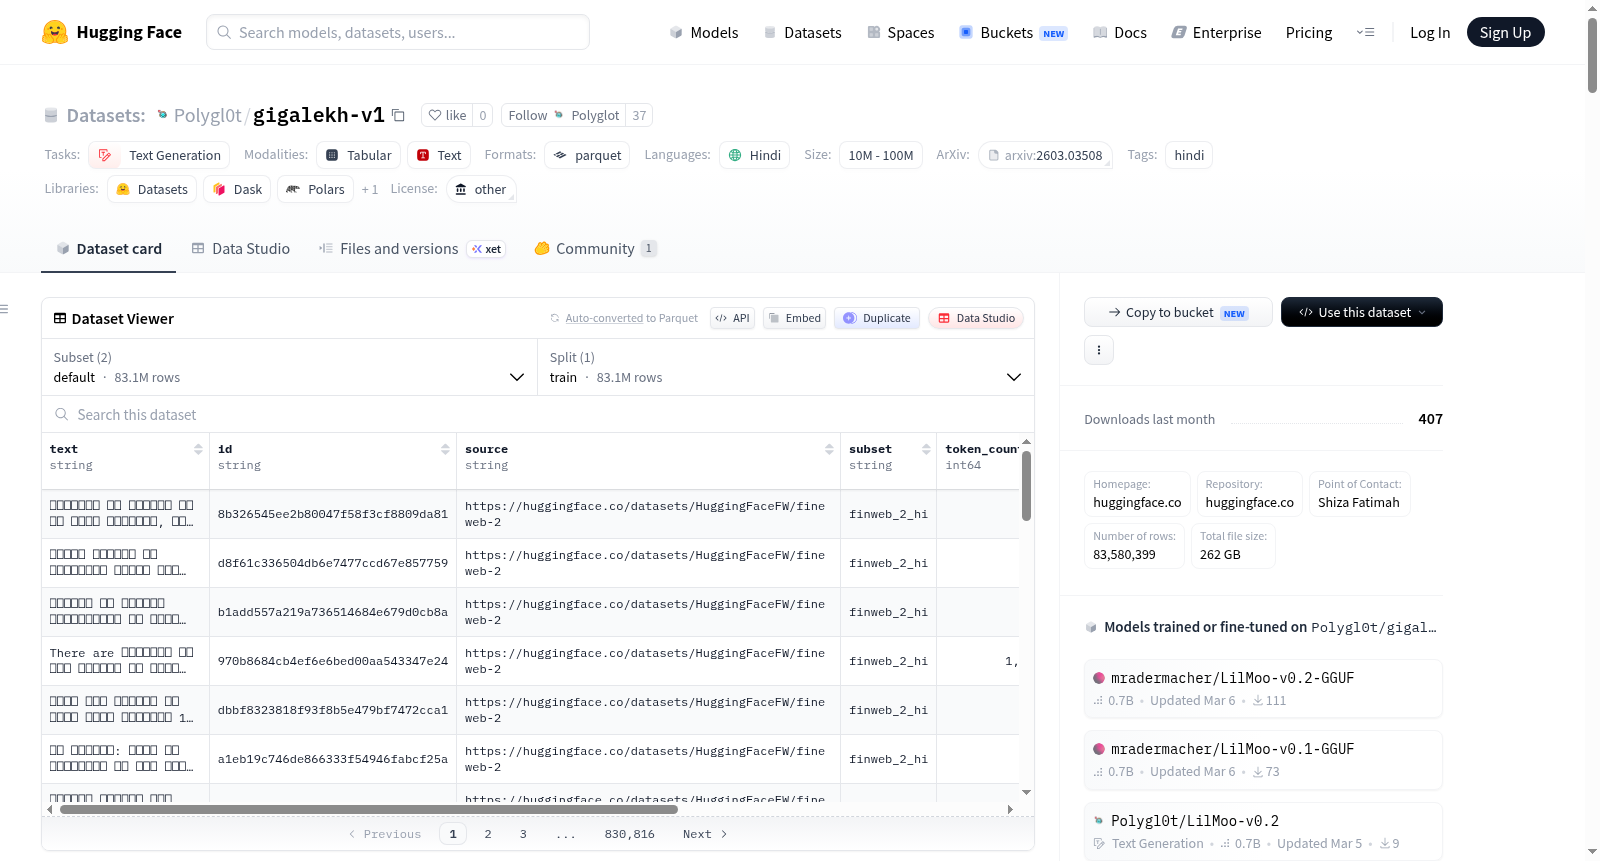
This repository contains a large corpus of Hindi text, which has been filtered and annotated using classifiers for educational content and toxicity. The dataset is intended for training language models and other NLP applications in Hindi.
提供机构:
Polygl0t搜集汇总
数据集介绍
构建方式
GigaLekh-v1数据集在构建过程中,首先从多个源头采集印地语文本数据,包括CommonCrawl网络爬虫及Hugging Face平台上的既有数据集。随后,通过Trafilatura库进行文本提取与语言识别,并运用基于FastText与GlotLID的双重语言鉴定技术提升准确性。在此基础上,实施基于启发式规则的质量过滤与格式化处理,以剔除低质量及不合规内容。为消除冗余,采用MinHash算法进行去重操作。最终,借助大语言模型(LLM-as-a-Judge)进行学习型过滤,利用Qwen2.5-32B-Instruct模型对文本的教育价值与毒性进行标注,并训练出两个分类器以自动化评分,形成包含教育分数与毒性分数的结构化数据。
特点
该数据集的核心特色在于其全面的质量标注体系。每一个样本均附带基于训练分类器预测的教育质量分数(edu_score)与毒性分数(toxic_score),并辅以对应的整数值版本,为下游任务提供了细粒度的质量筛选依据。数据集中包含一个独立的“excluded”子集,专门收录了因高毒性分数而被过滤的文档,为毒性检测与缓解研究提供了宝贵的资源。此外,数据来源广泛,覆盖多个时期的CommonCrawl快照及众多Hugging Face数据集,确保了内容的时效性与多样性。注释信息如token_count、source与subset字段,进一步增强了数据集的可追溯性与可用性。
使用方法
用户可通过Hugging Face的datasets库便捷地加载GigaLekh-v1数据集。加载默认配置(config_name='default')可获取经过完整过滤流程的主数据集,而选择'excluded'配置则可访问被排除的高毒性样本。为节省存储空间,支持设置streaming=True以流式方式读取数据。该数据集适用于印地语语言模型的预训练与微调,研究者可根据edu_score与toxic_score字段筛选高质量、低毒性的文本,或利用'excluded'子集探索毒性内容的特征。加载后的数据以字典形式呈现,包含text、id、source等字段,便于直接整合至NLP工作流中。
背景与挑战
背景概述
GigaLekh-v1数据集由Polygl0t团队于2025年创建,主要研究人员包括Shiza Fatimah等,旨在构建一个大规模、高质量、经过教育性与毒性标注的印地语文本语料库。该数据集整合了来自Common Crawl、Hugging Face等多个来源的印地语数据,通过精细的过滤流程,包括文本提取、语言识别、启发式质量过滤、去重以及基于大语言模型的主动学习标注,最终形成了包含约8300万样本、超过260GB文本的主训练集。GigaLekh-v1的发布填补了印地语NLP领域高质量预训练语料匮乏的空白,为语言模型训练、教育内容挖掘及毒性检测等下游任务提供了坚实的数据基础,对推动低资源语言自然语言处理研究具有重要影响力。
当前挑战
GigaLekh-v1面临的核心挑战在于解决印地语NLP领域的多重难题:首先,印地语作为低资源语言,其网络文本质量参差不齐,存在大量噪声、编码错误及非规范表达,且毒性内容(如仇恨言论)在印地语网页中尤为突出,如何精准识别并过滤有害文本同时保留教育性内容成为关键。其次,数据构建过程中,需要协调来自不同来源的异构数据,克服格式不统一、标注缺失等问题,并设计适用于印地语特性的启发式过滤规则(如针对天城文字符的编码修复)。此外,基于LLM的标注环节面临模型偏见风险,需确保教育性与毒性评分对印地语文化语境的敏感度,同时平衡计算成本以处理百亿级token的标注需求。
常用场景
经典使用场景
GigaLekh-v1作为迄今为止规模最大的高质量印地语文本语料库,其最经典的使用场景在于预训练大规模语言模型。该数据集汇聚了来自多种渠道的逾8300万条文本,总Token数超过900亿,为印地语领域的大模型提供了丰沛的训练素材。凭借其内置的教育质量评分与毒性评分双重标注,研究者能够依据下游任务需求灵活地筛选或加权数据,从而训练出在语言理解、文本生成以及知识表达方面表现卓越的印地语基础模型。无论是从零开始的预训练,还是对现有模型进行持续预训练或领域自适应,该语料库都充当了不可或缺的数据基石。
衍生相关工作
围绕GigaLekh-v1的构建过程,多个衍生工作相继涌现。其中,基于Qwen2.5-32B-Instruct大模型作为评判者标注的教育质量数据集与毒性数据集,为印地语文本质量评估提供了开放的监督学习训练资源。进一步地,研发团队分别训练了印地语RoBERTa教育分类器和毒性分类器,这些模型可直接用于其他语料库的自动化质量过滤与安全审查。此外,该语料库中因高毒性而被排除的样本单独构成了excluded子集,为印地语毒性检测与缓解策略的研究提供了独特的负面样本集合,推动了对低资源语言中敏感内容识别技术的深入探索。
数据集最近研究
最新研究方向
当前,面向低资源语言的大规模语料库构建与质量评估成为自然语言处理领域的前沿热点,尤其以印地语等非英语语言为代表。GigaLekh-v1数据集的问世,标志着印地语文本资源迈入了百万级规模与多维度标注的新纪元。该数据集不仅整合了来自CommonCrawl、FineWeb-2、Wikipedia等十余个来源的海量文本,更创新性地引入基于Qwen2.5-32B大语言模型的LLM-as-a-Judge流水线,对每一文本进行教育质量与毒性分数的精细标注。这一方法论融合了启发式过滤、MinHash去重与深度学习分类器,有效弥合了低资源语言在语料质量与安全管控上的鸿沟。在大型语言模型训练日益注重数据合规与负责任的AI的背景下,GigaLekh-v1为印地语文本生成、语言模型预训练及毒性检测提供了兼具规模与精度的基准资源,其双模态标注策略(教育与毒性)更是为多语言NLP的数据治理树立了先例。
以上内容由遇见数据集搜集并总结生成


